Разбор готов
Meta SilverTorch: индекс как часть модели отбора кандидатов
В крупной рекомендательной системе нельзя дорого ранжировать миллионы роликов, фотографий и других объектов при каждом открытии приложения. Сначала этап отбора кандидатов (retrieval) должен сузить каталог до тысяч объектов, которые уже можно передать более точному ранжированию. В прежней архитектуре Meta эту работу делила сетка сервисов: один строил вектор пользователя, другой искал похожие объекты, отдельная инфраструктура проверяла правила допуска, ещё один сервис оценивал оставшихся кандидатов. Со временем такая схема стала тратить бюджет задержки на сетевые переходы, допускать рассогласование версий модели и индекса и мешать оптимизировать поиск, фильтрацию и оценивание как одну вычислительную задачу. SilverTorch меняет границу системы: индекс, фильтры, ANN-поиск, башня пользователя, нейронная переоценка и составная оценка становятся частями одной PyTorch-модели, а самые дорогие операции перепроектируются под GPU. В этой главе разберём, зачем понадобились Bloom-фильтрация и объединённый Int8 ANN-поиск, как Meta сравнивала новую систему с CPU- и GPU-вариантами, из чего складываются заявленные ускорения, как используется локальность памяти и torch.compile и как индекс обновляется без полного перевыпуска модели. Главная польза — научиться отделять общий интерфейс модулей от их градиентного обучения и читать числа Meta только вместе с базой сравнения и условиями измерения.
Материал полезен ML- и инфраструктурным инженерам, которые работают с многоэтапными рекомендательными системами и хотят понять, как границы между индексом, фильтрацией и моделью влияют на задержку, пропускную способность, стоимость вычислений и скорость выпуска изменений. Базовое знакомство с двухбашенными моделями, ANN-поиском и GPU поможет, но специфические для SilverTorch понятия вводятся по ходу главы.
Статья · на английском
SilverTorch: Index as Model — A New Retrieval Paradigm for Recommendation SystemsLei Chen и соавторы · Опубликовано: 26 мая 2026 г.
Где SilverTorch находится в рекомендательной системе
SilverTorch решает задачу раннего отбора кандидатов. Когда человек открывает приложение, система не может прогнать дорогое ранжирование по миллионам доступных роликов и фотографий. Сначала этап отбора кандидатов (retrieval) сужает каталог до тысяч объектов, и только после этого список передаётся следующим ранжирующим системам. Meta указывает для этого этапа бюджет меньше 100 мс. Это не заявленная задержка всей ленты или всего пользовательского запроса: речь именно о стадии поиска и отбора кандидатов.
По словам Meta, прежняя микросервисная архитектура стала ограничивать и число рассматриваемых кандидатов, и сложность моделей внутри этого бюджета. SilverTorch задуман как способ поднять этот потолок: один запрос проходит через общую модель, которая строит представление пользователя, ищет похожие объекты, учитывает ограничения показа, переоценивает кандидатов и объединяет несколько целей взаимодействия в итоговую оценку.
Вводная часть статьи, абзацы до “Moving From Microservice Mesh to One Integrated Neural Network”Как работала прежняя сетка сервисов
В старой схеме входной запрос сначала попадал в оркестратор. Он обращался к отдельному сервису башни пользователя (user tower), который строил вектор интересов. Затем отдельный сервис отбора кандидатов искал похожие объекты и применял ограничения, например по языку и стране. Ещё один сервис оценивал оставшихся кандидатов. Оркестратор собирал результаты и передавал их дальше.
Каждая часть имела собственный код, структуры данных, память и цикл выпуска; сервисы могли быть написаны на разных языках. Отдельно существовали и артефакты данных: представления объектов, индекс для ANN-поиска и структуры фильтрации. Такой дизайн удобен, пока компоненты можно улучшать независимо, но становится проблемой, когда качество и стоимость зависят от их согласованной работы.
“Moving From Microservice Mesh to One Integrated Neural Network” → “The Microservice Paradigm We Replaced”Почему локального ускорения сервисов оказалось недостаточно
Первое ограничение — передача данных. Каждый сетевой переход добавляет обмен туда и обратно и сериализацию, отнимая время у полезных вычислений из бюджета отбора. Кроме того, поиск, фильтрация и оценивание проектируются независимо, поэтому система не может свободно переставлять или объединять эти операции в одном вычислительном графе.
Второе ограничение — рассогласование версий. Башня пользователя, индекс объектов и правила фильтрации обновляются в разном ритме. Если пользовательская модель уже выпущена в версии v2, а индекс всё ещё построен по v1, новый пользовательский вектор сравнивается со старыми представлениями объектов. Meta описывает это как источник потери качества, которую уже не исправит последующее ранжирование.
Третье ограничение — разрыв между ML- и инфраструктурной разработкой: исследовательская логика живёт в PyTorch, а производственная реализация отдельных сервисов может жить в C++ с другими тестами и циклом выпуска. Ускорение одного компонента, например перенос FAISS на GPU, помогает этому компоненту, но не убирает границы между сервисами и передачу артефактов между ними.
“The Microservice Paradigm We Replaced”, три ограничения и абзац о Faiss-GPUIndex as Model: индекс становится состоянием той же модели
В SilverTorch отправной точкой становится не набор сервисов, а одна PyTorch-модель. Подход Meta называет Index as Model. Индекс объектов, фильтрация допустимости, слой оценивания и башня пользователя представлены как тензоры или операции внутри общего вычислительного графа. Для выпуска получается один артефакт, для запроса — один проход вычислений (forward pass), а состояние индекса и вычислительная логика оказываются в одной системе версий.
На исходной схеме сверху показан контур подготовки состояния. Блок Model Trainer публикует параметры для башни пользователя и контура Index to Model Parameter; Item Embedding Model строит представления объектов; GPU Index builder формирует индекс по пулу кандидатов и их признакам. В модель, обслуживающую запросы, затем попадают Bloom Index, ANN Index и индекс признаков объектов.
Нижняя часть схемы показывает путь запроса: пользовательские признаки идут в User Tower, после чего индекс, проверки допустимости и ANN-поиск совместно сокращают пространство кандидатов. Схему не следует читать как обязательную проверку Bloom-структурой всего каталога до ANN. Описанный в статье совместный план позволяет сначала выбрать наиболее перспективные области индекса, затем проверять допустимость только внутри них и оценивать только прошедшие объекты. После поиска на рисунке обозначен порядок O(100k) кандидатов; нейронная переоценка и составная оценка сокращают его до порядка O(1k), который передаётся дальнейшему ранжированию. Это порядки величины на схеме, а не фиксированные размеры для каждого запроса.
Важно не спутать единый интерфейс с единым способом обучения. В статье прямо сказано: часть областей модели написана инженерами вручную, часть обучается сквозным обратным распространением ошибки. То, что все они оформлены как nn.Module, означает общий интерфейс и возможность композиции, но само по себе не делает индекс или фильтр градиентно обучаемыми.
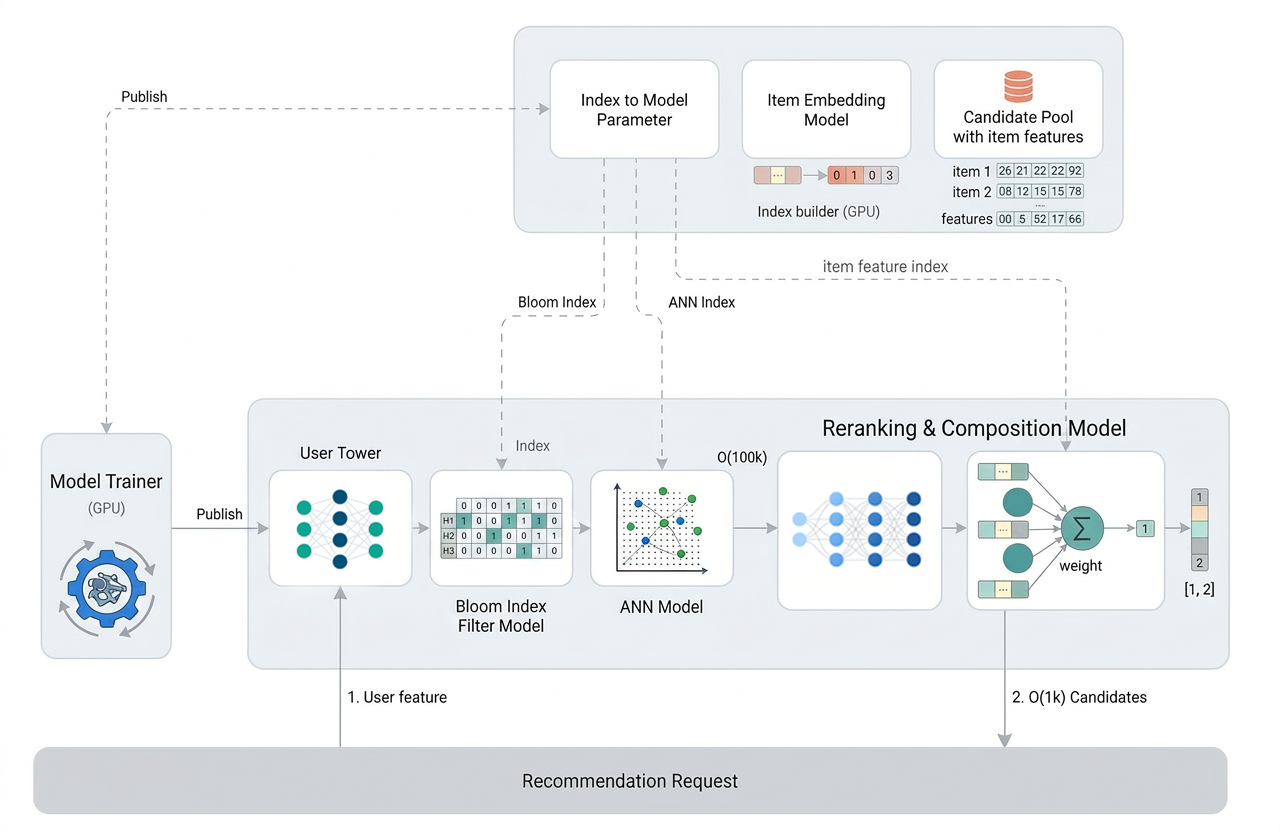
В SilverTorch компоненты отбора кандидатов представлены модулями PyTorch. Индекс и ограничения входят в единый артефакт вместе с моделью.
Источник: Meta Engineering · SilverTorchПочему понадобилось переписать все стадии в чистом PyTorch
Таблицу можно прокрутить по горизонтали.
Проблема этих реализаций не в незрелости: Meta называет их проверенными практикой. Ограничение в том, что каждая живёт со своей памятью и моделью исполнения. Можно последовательно вызвать ANN, затем фильтр, затем оценивание, но трудно построить общий план вроде «сначала выбрать перспективные области индекса, фильтровать только внутри них и оценивать только прошедших кандидатов».
Поэтому SilverTorch задаёт общий контракт: данные представлены тензорами, логика получает тензоры на вход и возвращает тензоры на выход, а каждый компонент реализует интерфейс nn.Module. Это позволяет держать компоненты в одном вычислительном графе, совместно оптимизировать их выполнение и применять инструменты экосистемы PyTorch. Meta отдельно упоминает torch.compile: компилятор может преобразовать PyTorch-граф в более эффективные GPU-ядра.
Однако просто обернуть прежний сервис эпохи CPU в nn.Module было бы недостаточно. Ключевой шаг — переделать сами примитивы с учётом поведения памяти GPU, расположения тензоров и возможности выполнить несколько стадий за один проход. Два главных примера такого пересмотра в статье — Bloom-фильтр и объединённый Int8 ANN-поиск (fused Int8 ANN).
“The Redesign: Pure PyTorch Modules for Every Stage” → “The Pure PyTorch Decision”Bloom-фильтрация вместо списков, неудобных для GPU
Обычный инвертированный индекс хранит для признака список объектов, которым он соответствует. На CPU такая структура эффективна, но на GPU длины списков могут сильно различаться. Когда потоки одной группы исполнения (warp) получают разный объём работы, часть потоков заканчивает раньше и простаивает, пока остальные обрабатывают длинные списки. Meta связывает это с дисбалансом нагрузки внутри warp и расхождением путей выполнения (warp divergence).
SilverTorch заменяет такой путь Bloom-индексом внутри модели. При публикации объект получает компактную сигнатуру, а во время запроса проверка соответствия выполняется простыми побитовыми операциями. Это превращает фильтрацию в более плотную параллельную работу на GPU и позволяет сочетать её с ANN-поиском без отдельного сетевого вызова. В совместном плане система может сначала выбрать перспективные области индекса, а Bloom-проверку применять уже внутри них.
Статья не приводит параметры Bloom-структуры, не публикует отдельную оценку ложных совпадений и не утверждает, что такой фильтр сам по себе безошибочен. Поэтому результат нужно читать как инженерное сравнение конкретной реализации Meta, а не как универсальную гарантию качества Bloom-фильтра.
Абзацы о Bloom index filter после “The Pure PyTorch Decision”Fused Int8 ANN: больше кандидатов при меньшем движении данных
Приближённый поиск ближайших соседей (ANN) обычно используют, чтобы быстро вернуть небольшой набор объектов, близких к пользовательскому вектору. Для SilverTorch этого мало: Meta хочет недорого получить заметно более широкий пул, чтобы более выразительные модели успели переоценить его до финального ранжирования.
Поэтому ANN реализован внутри модели как объединённое GPU-ядро, а представления объектов хранятся в Int8. В статье это сравнивается с типичным 16-битным хранением: объём памяти сокращается примерно вдвое. Объединение операций уменьшает перемещения данных, поэтому система может позволить себе большие top-k и больше проверяемых областей индекса, оставляя вычислительный запас для следующих слоёв.
Meta пишет об ограниченной потере качества относительно полного перебора (brute force) и приводит конкретное наблюдение: в их практике конфигурация с 64 probes и top-2048 не дала потери полноты ANN-поиска. Это производственный результат данной настройки, а не гарантия для любой Int8-квантизации, другого индекса или другого распределения данных.
Абзацы “Fused Int8 ANN search follows the same idea” и описание конфигурации 64 probes / top-2048Нейронная переоценка и многозадачный составной скоринг
Освободившийся вычислительный запас SilverTorch тратит не только на более широкий ANN-поиск. После отбора работает нейронная переоценка кандидатов (neural reranking). В отличие от простого скалярного произведения пользовательского и объектного векторов, этот слой может моделировать более богатое взаимодействие пользователя и конкретного объекта.
В статье перечислены несколько форм таких слоёв: многослойные полносвязные сети, несколько слоёв self-attention и более структурированные модели взаимодействия, например mixture of logits. Представления объектов и совместные признаки пары остаются в памяти GPU, поэтому такие слои можно применять раньше в каскаде и к намного большему числу кандидатов.
Следующий уровень — многозадачное оценивание. Модель отдельно предсказывает вероятность разных действий, например лайка, репоста или комментария, а затем составная оценка объединяет эти сигналы. По описанию Meta, новая система отбора может проводить через дополнительные обучаемые слои на один-два порядка больше кандидатов, чем прежняя сервисная схема. Численного A/B-прироста пользовательской метрики в статье для этого эффекта не приведено.
“Recommendation Quality”Как Meta сравнивала системы и что означают 23.7× и 20.9×
Основное производственное сравнение проведено на нагрузке с 80 миллионами объектов. Meta воспроизводила реальный рабочий трафик на сравниваемых системах при одинаковом бюджете задержки. Это важная часть результата: числа нельзя переносить на другой размер каталога, другой бюджет задержки или произвольную архитектуру без новой проверки.
Таблицу можно прокрутить по горизонтали.
Во вводной части Meta также называет 20,9× улучшением оценённой эффективности совокупной стоимости владения для этого вычислительного решения. Подробная таблица формулирует показатель как эффективность вычислительных затрат относительно CPU-базы. Поэтому корректный вывод ограничен данным этапом отбора и этой базой сравнения: это не означает, что общий бюджет Meta или все расходы рекомендательной системы уменьшились в 20,9 раза.
В той же таблице различаются и функциональные возможности: для FAISS-GPU указан максимальный top-k = 2 048, для CPU — без жёсткого ограничения, но медленно, а для SilverTorch — сотни тысяч. Нейронная переоценка и многозадачное оценивание отмечены как поддерживаемые SilverTorch, но не двумя вариантами FAISS. То есть сравнение отражает не только скорость одного ANN-оператора, но и более широкий объём работы, который новая архитектура способна выполнить внутри того же бюджета.
“Benefits — What Shows Up Outside the System” → “Compute Cost Efficiency” и таблица performance metricsИз чего складывается выигрыш и почему множители нельзя перемножать
Meta раскладывает вариант с 13,35× преимуществом по затратам на один запрос на несколько инженерных источников. Объединённое Int8 ANN-ядро в их измерениях работает в 2,2–14,7 раза быстрее Faiss-GPU. Bloom-индекс оказывается в 291–523 раза быстрее CPU-инвертированного индекса.
Ещё один выигрыш даёт совместный порядок probe-then-filter. Сначала ANN выбирает наиболее перспективные кластеры или области индекса, затем Bloom-проверка применяется только к объектам внутри них, и дальнейшая оценка выполняется только для прошедших кандидатов. По данным Meta, такой совместный план сокращает вычисления фильтра ещё примерно в 30 раз. Это не проверка всего каталога Bloom-структурой перед ANN.
Int8-представление внутри вычислительного графа примерно вдвое уменьшает память относительно базовых вариантов с полной точностью; статья упоминает GPU-инструкции dp4a и отсутствие измеримой потери полноты поиска в этом сравнении. Но перечисленные множители относятся к разным операциям и условиям. Их нельзя перемножить и получить новый общий коэффициент ускорения: сквозной результат измеряется отдельно.
Абзац после таблицы performance metrics: 13.35× cost-per-request advantage и компонентные ускоренияОдин стек разработки вместо передачи идеи между командами
У архитектурного объединения есть и организационный эффект. Когда весь путь выражен в PyTorch, инженер может реализовать новую идею в том же стеке, в котором она будет исполняться, вместо отдельного переноса из исследовательского кода в C++-сервис и последующей интеграции нескольких команд.
Meta сообщает, что время от разработки нового улучшения отбора кандидатов до публикации сократилось с недель до дней. Это наблюдение команды SilverTorch, а не универсальная оценка любой миграции на единый кодовый стек: в источнике нет распределения по типам изменений или отдельной методики измерения инженерного времени.
“Engineering Velocity”Масштабирование начинается с локальности памяти
Стратегия SilverTorch — сначала максимально использовать один GPU, то есть масштабироваться вверх (scale up). Для этого система учитывает иерархию памяти: SRAM на кристалле, HBM на GPU, DRAM хоста и удалённую DRAM. Чем ближе данные к месту вычисления, тем меньше времени и пропускной способности тратится на перенос. Такой акцент на локальности объясняет, почему простого переноса старого сервиса на GPU недостаточно.
Когда одного GPU мало, система масштабируется внутри одного сервера, используя высокоскоростные соединения между GPU. Если нейросеть и индекс уже не помещаются на одном сервере, Meta применяет разделение каталога по нескольким узлам. Для больших разреженных таблиц эмбеддингов используется TorchRec: библиотека может распределять таблицы между HBM, оперативной памятью хоста и даже удалённой памятью CPU-серверов.
Общий вычислительный граф PyTorch даёт и единый слой компиляции. Meta отдельно отмечает torch.compile, который способен преобразовывать модель в более эффективные GPU-ядра. Для SilverTorch это важно именно потому, что ANN, фильтрация и нейросетевые стадии видны одной среде выполнения, а не скрыты за сетевыми границами независимых сервисов.
“Engineering for Scale and Freshness” → “Scale Up and Scale Out”; связь с torch.compile из “The Pure PyTorch Decision”Как обновлять индекс без полного перевыпуска модели
Если индекс стал частью состояния модели, возникает новая эксплуатационная задача: обновлять его достаточно часто и не останавливать обслуживание запросов. SilverTorch разделяет полную публикацию и свежие точечные изменения. Полная модель периодически публикуется как целостный снимок.
Между полными публикациями непрерывный потоковый сервис читает сигналы о новых объектах, изменившихся признаках вовлечённости и правилах допустимости. Он вносит адресные изменения непосредственно в нужные тензоры уже загруженной модели. По описанию Meta, такие обновления применяются без остановки обслуживания запросов и без полного повторного развёртывания модели.
Статья связывает этот механизм со свежестью рекомендаций: публикации, созданные в тот же день, теперь составляют значимую часть рекомендаций по сравнению с предыдущими системами. Численной доли Meta здесь не приводит, поэтому утверждение нельзя превращать в процент. И здесь важно различать обновление состояния и обучение: запись новых значений в тензоры сама по себе не означает шаг обратного распространения ошибки.
“Index Freshness”Три этапа эволюции SilverTorch
- 01
1. Воспроизвести исходные модули в PyTorch
ANN, фильтрацию и оценивание сначала перенесли в единый PyTorch-стек. Уже это дало выигрыш от быстрой GPU-памяти и сокращения перемещений данных.
- 02
2. Перепроектировать примитивы под GPU
Затем модули перестали быть прямыми аналогами старых сервисов. Появились объединённый Int8 ANN-поиск и Bloom-фильтр, рассчитанные на совместное исполнение и поведение памяти GPU.
- 03
3. Добавить совместное обучение там, где оно нужно
Только после этого Meta включила обратное распространение ошибки для отдельных модулей, написанных инженерами вручную, чтобы они могли обучаться вместе с остальной моделью. Источник говорит именно об отдельных модулях, а не обо всех компонентах без исключения.
Эта последовательность важна для понимания всей архитектуры. Основной выигрыш SilverTorch не требует предполагать, что индекс и фильтр с самого начала стали полностью дифференцируемыми. Сначала изменились границы исполнения и локальность данных, затем алгоритмы пересмотрели под GPU, и лишь после этого для части вручную реализованных модулей добавили совместное градиентное обучение.
“The Evolution of SilverTorch and What’s Next”Что уже работает и что Meta оставляет на будущее
К достигнутому результату Meta относит сам подход Index as Model и пишет, что он уже широко используется внутри компании в разных приложениях. Это нужно отделять от следующего шага — интеграции больших языковых моделей (LLM). В статье LLM рассматривается как ещё один возможный модуль, который сможет работать в том же GPU-вычислении и разделять память с обычным оцениванием кандидатов.
Как направление развития Meta перечисляет генерацию объектов с помощью LLM, использование тех же GPU-параллельных приёмов для фильтрации, обновление знаний об объектах через существующую потоковую инфраструктуру и отсутствие сетевого переноса данных между отдельным LLM-сервисом и оцениванием. Для этой LLM-интеграции в статье нет отдельного производственного сравнения или A/B-результата, поэтому её нужно читать как план развития архитектуры, а не как уже измеренный эффект SilverTorch.
За более подробными техническими деталями исходная публикация отправляет к работе “SilverTorch: A Unified Model-based System to Democratize Large-Scale Recommendation on GPUs”, принятой как полная исследовательская статья на SIGIR 2026. В этой главе дополнительные результаты из работы не добавляются: фактическая основа ограничена инженерной статьёй Meta.
“Looking Ahead” и “Read the Paper”Итог: путь запроса и границы результата
SilverTorch показывает, что предел производительности раннего отбора задаёт не только ANN-алгоритм, но и границы между индексом, фильтрами и моделями. Meta объединила ключевые стадии в одной PyTorch-модели и перепроектировала дорогие операции под GPU. На сквозной оценке с 80 млн объектов система обслуживала в 23,7 раза больше запросов в секунду, чем сильная традиционная многосервисная система, построенная на той же архитектуре модели. Показатель 20,9× означает оценённую эффективность вычислительных затрат относительно FAISS-CPU при описанных условиях; это не снижение общего бюджета Meta. Бюджет меньше 100 мс относится к стадии отбора кандидатов, а не ко всему продукту.
- 01
1. Вектор пользователя
Башня пользователя получает признаки запроса и строит представление текущих интересов.
- 02
2. Поиск и проверка допуска
ANN выбирает перспективные области индекса, а Bloom-проверка применяется внутри них; это совместный план probe-then-filter, а не проверка всего каталога до ANN.
- 03
3. Нейронная переоценка
Более выразительная модель уточняет оценки большого пула кандидатов с учётом взаимодействия пользователя и объекта.
- 04
4. Составная оценка
Прогнозы нескольких действий пользователя объединяются в итоговую оценку, по которой список дополнительно сокращается и упорядочивается.
- 05
5. Передача дальше
Получившийся пул кандидатов передаётся следующим, более дорогим стадиям ранжирования.
Обучение и обновление состояния идут отдельно от пути запроса. Полные снимки модели периодически публикуются, а между публикациями потоковый сервис точечно меняет тензоры для новых объектов, признаков и правил допуска без остановки обслуживания. Это обновление состояния не следует автоматически считать градиентным обучением: общий интерфейс nn.Module не делает каждый индекс или фильтр обучаемым. Обратное распространение ошибки Meta позднее включила только для отдельных модулей, написанных вручную. Масштабирование строится от локальности памяти одного GPU к нескольким GPU, разделению каталога по узлам и TorchRec. Интеграция LLM в статье остаётся следующим направлением, а не уже измеренным промышленным результатом.
Синтез всей статьи; рабочий путь запроса — “Inside the Model” и исходная схема Index as Model