Разбор готов
Как AiGenda адаптировала Mistral 7B для русскоязычных встреч
Автоматический протокол встречи выглядит простой связкой: распознать речь, определить говорящих, передать стенограмму языковой модели и получить краткое содержание с задачами. В AiGenda этот путь оказался сложнее. Базовый Mistral 7B плохо следовал русскоязычным инструкциям, ошибался в формах слов и терял смысл в длинных диалогах, а качество итогового протокола зависело ещё и от распознавания речи и разделения участников. Команда поэтому разделила задачу на несколько этапов: построила сервисную архитектуру вокруг нескольких ML-компонентов, отдельно усилила русский язык модели полным дообучением всех весов, затем вернула LoRA уже для узкой диалоговой инструкции и параллельно адаптировала Whisper к записям встреч. В этой главе разберём именно причинный ход экспериментов: почему первая LoRA не решила языковую проблему, что изменилось после полной языковой адаптации, как интерпретировать MERA и BertScore и где заканчиваются подтверждённые выводы статьи.
Глава полезна ML-инженерам и разработчикам LLM-сервисов, которые работают с длинными русскоязычными диалогами, автоматическим протоколированием или адаптацией открытых моделей под предметную задачу. Особенно полезен разбор тем, кто выбирает между полным дообучением и LoRA, строит систему из нескольких моделей и хочет не смешивать тренировочные графики, общие языковые бенчмарки и качество конечной задачи.
Статья · на русском
LoRA не помогла: как мы дообучали Mistral 7B на русском и что в итоге сработалоЕвгений Гутин · Опубликовано: 31 марта 2026 г.
Из видеовстречи нужно получить структурированный протокол
AiGenda решает не одну задачу генерации текста, а последовательную задачу обработки встречи. Исходный материал — видеозапись с несколькими участниками, а полезный результат — протокол, по которому можно быстро восстановить обсуждение, задачи и основные темы. Простая схема «Whisper плюс готовая LLM» не дала требуемого качества: Mistral 7B ошибался в русских склонениях, хуже следовал русскоязычным инструкциям и терял смысл на длинных диалогах.
Команда разделила обработку на четыре этапа. Сначала Whisper превращает речь в текст. Затем система определяет, кто говорит: для сегментации используется pyannote/speaker-segmentation, а ResNet34 на VoxCeleb участвует в кластеризации речевых фрагментов и выделении активности спикеров. После этого смена темы определяется по расстоянию между эмбеддингами предложений. Только затем текст попадает в языковую модель. Для последнего этапа искали мультиязычную модель до 7 млрд параметров с контекстным окном не меньше 8 тысяч токенов и остановились на Mistral 7B как компромиссе качества, скорости и ресурсов.
Вступление; раздел «Что внутри задачи»Архитектура отделяет пользовательский контур от ML-моделей
При проектировании авторы формулируют четыре требования: сервис должен масштабироваться, оставаться безопасным для пользователя, позволять быстро менять функциональность и переживать сбои отдельных компонентов. Поэтому пользователь не обращается к модели напрямую. FrontEnd работает с Backend, а уже Backend отправляет запрос в ML-контур и возвращает результат клиенту.
На схеме Backend является центральной границей доступа: он связан с PostgreSQL и S3-хранилищем, а ML Controller работает с моделями, очередями и отдельным хранилищем эмбеддингов. Такая граница важна не из-за конкретного алгоритма модели, а потому что поведение генеративной системы может быть непредсказуемым, а пользовательские данные и управление файлами остаются за Backend.
Вывод из схемы: ML-часть здесь не самостоятельный публичный сервис. Доступ к данным и хранилищам разделён по компонентам, а модели можно менять внутри ML-контура, не открывая их напрямую клиенту.
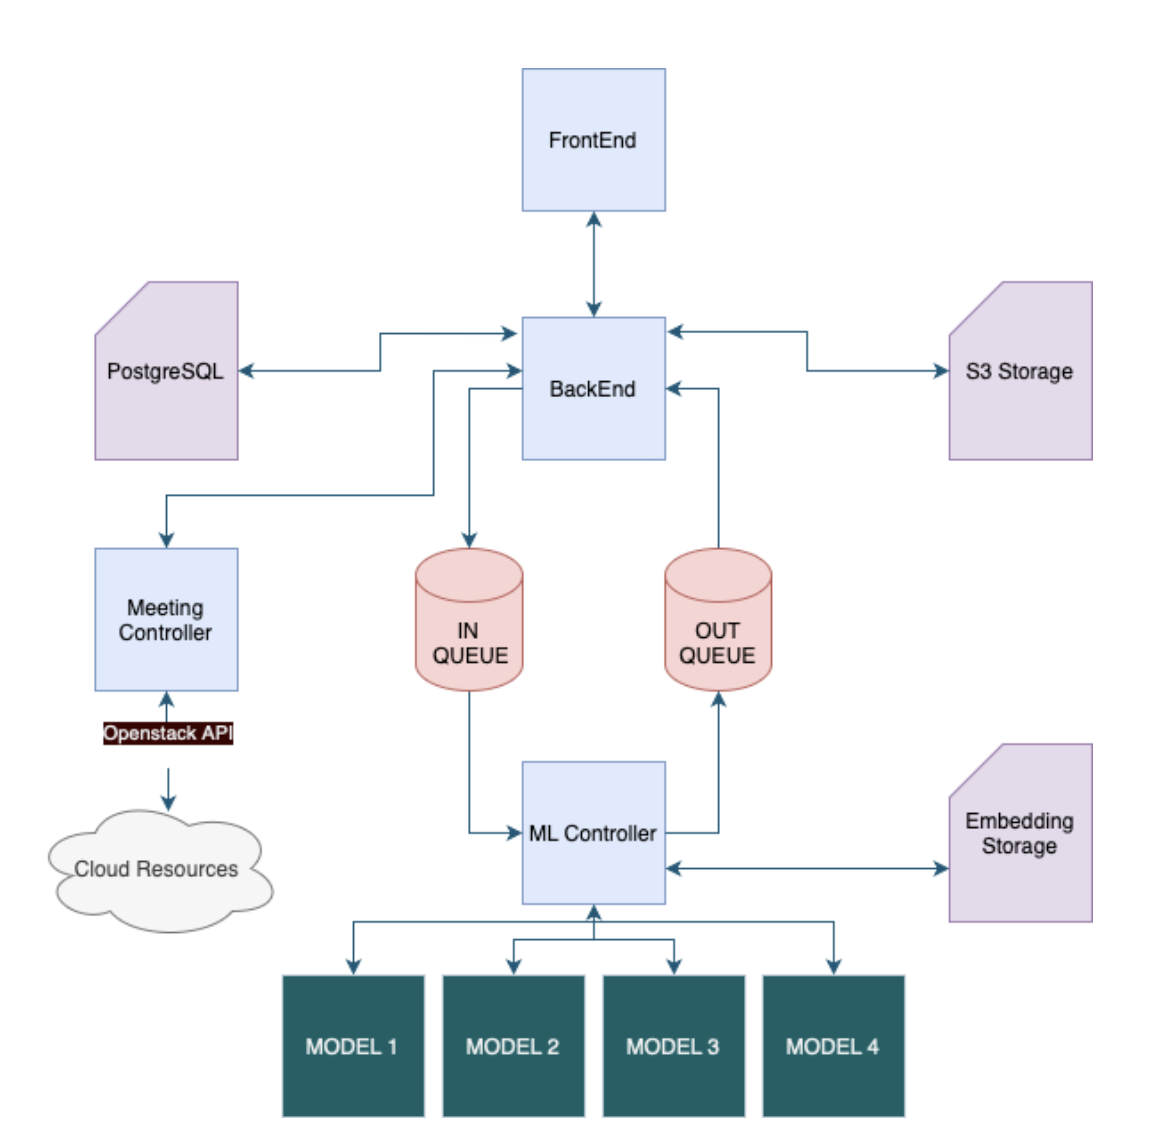
Пользовательские данные доступны ML-контуру через Backend. ML Controller связан с входной/выходной очередями и моделями; исходная схема сохраняет границы компонентов.
Источник: Евгений Гутин · AIGendaОчереди и ML Controller развязывают обработку
Между Backend и ML добавлена очередь RabbitMQ. Очередь — это промежуточный буфер, в который один компонент кладёт задания, а другой забирает их для обработки. В статье это решение связывается с пакетной обработкой запросов и меньшим ожиданием при высокой нагрузке. Управление несколькими моделями вынесено в ML Controller — сервис-оркестратор, который маршрутизирует запросы между моделями и упрощает их замену или добавление.
ML Controller также обращается к векторному хранилищу, где лежат эмбеддинги текста и спикеров. Эмбеддинг — это числовое представление объекта, в котором близкие по смыслу или признакам элементы можно сравнивать как векторы. Основная пользовательская база при этом изолирована и доступна через Backend.
Запись видеоконференций вынесена в Meeting Controller. Он получает ресурсы через OpenStack API и, по описанию автора, динамически выделяет их, чтобы не держать лишние мощности постоянно. Для наблюдения за системой упомянуты Grafana и Sentry. Численных SLA, пропускной способности или стоимости обработки одной встречи статья не приводит.
Раздел «Архитектура», абзацы о RabbitMQ, ML Controller, Embedding Storage и Meeting ControllerПервая LoRA улучшила форму русского текста, но не решила языковую основу
LoRA — способ дообучать небольшие низкоранговые добавки к весам модели вместо изменения всех параметров. Такой подход требует меньше памяти и вычислений, поэтому он был естественной первой гипотезой для адаптации Mistral 7B к русскому языку.
По наблюдению команды, после первой LoRA модель стала лучше выражаться по-русски и часть неточностей сгладилась, однако логика предложений оставалась слабой. Авторы связывают это с тем, что в исходном обучении модели не хватало русскоязычной информации, и делают практический вывод: для этой стадии нужно изменять все веса, а не только адаптеры.
Это не вывод о бесполезности LoRA как метода. Здесь LoRA проверялась как способ исправить базовое владение русским языком. Позже, после полной языковой адаптации, команда снова использует LoRA — уже для узкой задачи протоколирования.
Раздел «Почему LoRA не сработала»Полная языковая адаптация: 5,35 млрд токенов и две RTX A6000
Для полной адаптации всех весов команда собрала русскоязычный корпус объёмом 5 млрд 350 млн токенов. Токен — единица текста, на которую модель разбивает вход при обучении. В набор вошли тексты, диалоги и инструкции из открытых источников; часть материалов была получена машинным переводом с других языков. Статья не раскрывает точные пропорции источников, правила дедупликации или размер отдельных выборок.
Обучение запускали через Hugging Face Transformers. Чтобы уложиться в ограниченные ресурсы, использовали несколько оптимизаций. Mixed Precision с bfloat16 уменьшает стоимость хранения и вычислений по сравнению с полной точностью. Padding-free sampler старается не тратить вычисления на служебное дополнение коротких последовательностей и, по заявлению автора, дал ускорение до 10 раз. Flash Attention 2 ускоряет вычисление механизма внимания и уменьшает потребление видеопамяти.
Кроме того, использована оптимизация ZeRO-2 с выгрузкой части состояния на CPU; в статье также указаны continuous gradients как часть набора мер по снижению расхода ресурсов. Обучение прошло на двух Nvidia RTX A6000 с 48 GB памяти каждая. Метрики и артефакты логировались в Weights & Biases. Автор подчёркивает, что именно сочетание оптимизаций позволило выполнить полное дообучение на этих двух GPU.
Раздел «Как мы дообучили модель с нуля»Тренировочные графики показывают ход обучения, а не качество протоколов
На первом тренировочном графике функция потерь постепенно снижается: в начале она заметно выше, затем быстро падает и дальше медленнее выходит на плато. Функция потерь — величина, которую оптимизатор минимизирует во время обучения. Здесь её снижение означает, что модель лучше решает свою учебную задачу на тех данных и с той постановкой, по которым строится график.
Вывод из рисунка: обучение сходится в том смысле, что оптимизируемая ошибка уменьшается. Этот график нельзя читать как MERA, BertScore, долю правильных протоколов или онлайн-эффект.
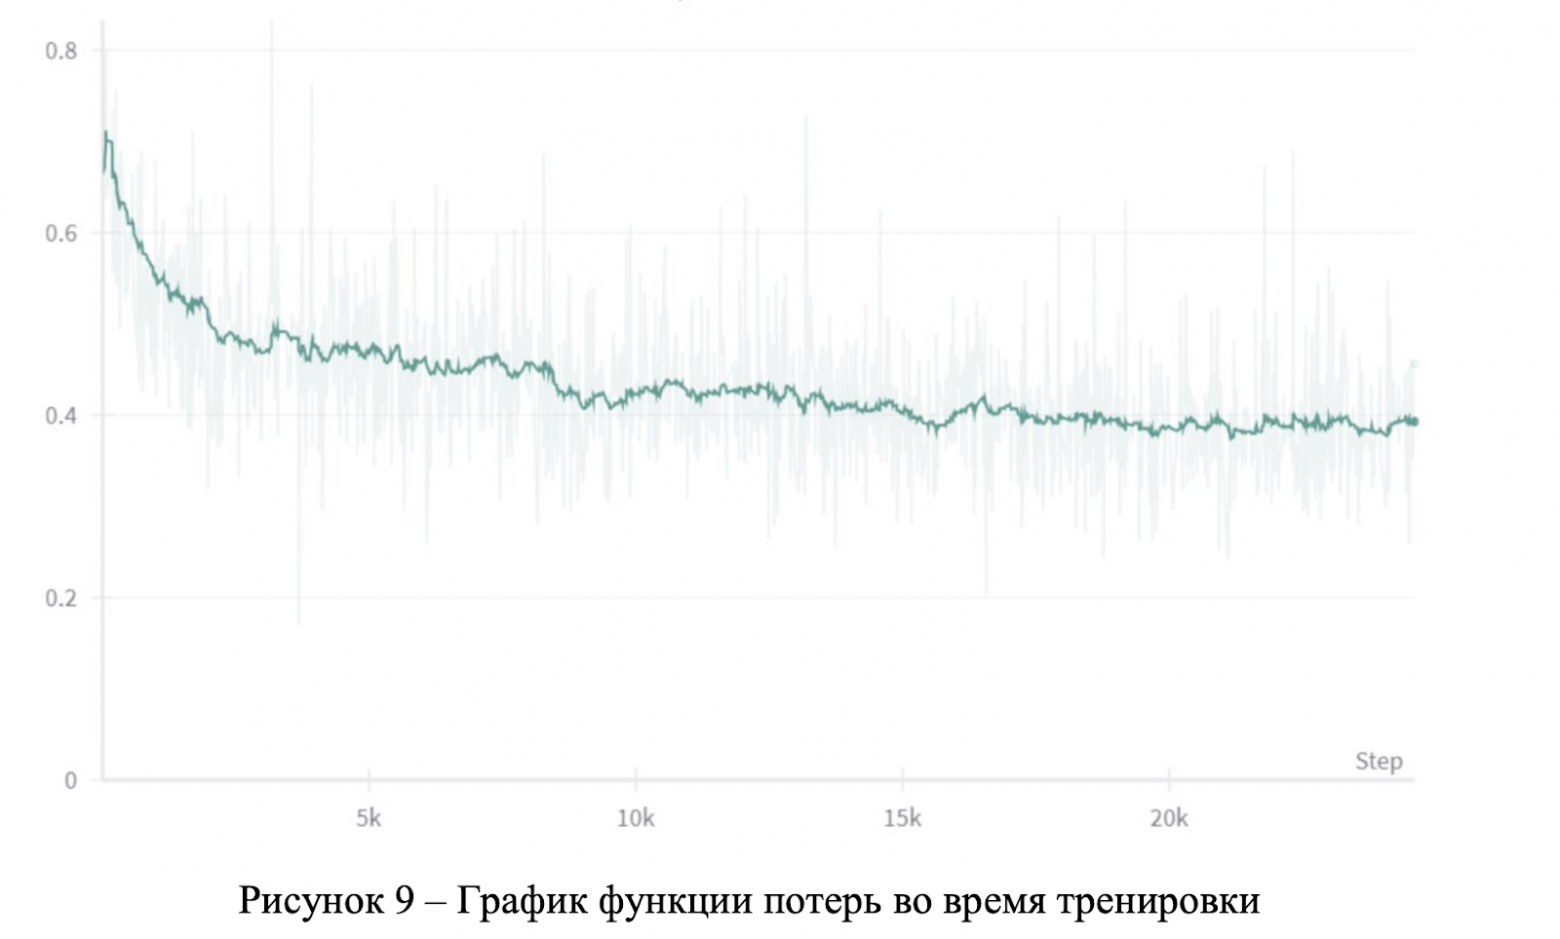
График обучения из статьи. Снижение функции потерь само по себе не является оценкой качества протоколов встреч.
Источник: Евгений Гутин · AIGendaРост тренировочной accuracy — отдельный внутренний сигнал
Второй график показывает тренировочную accuracy — долю правильных предсказаний в той внутренней задаче, которую считает обучающий код. Кривая растёт примерно от середины диапазона 0.8 к значениям около 0.89 и затем стабилизируется.
Вывод из рисунка такой же осторожный: по мере обучения внутренняя точность повышается. Это не означает «89% правильных протоколов» и не заменяет отдельную проверку общей языковой модели на MERA или оценку суммаризации после финальной специализации.
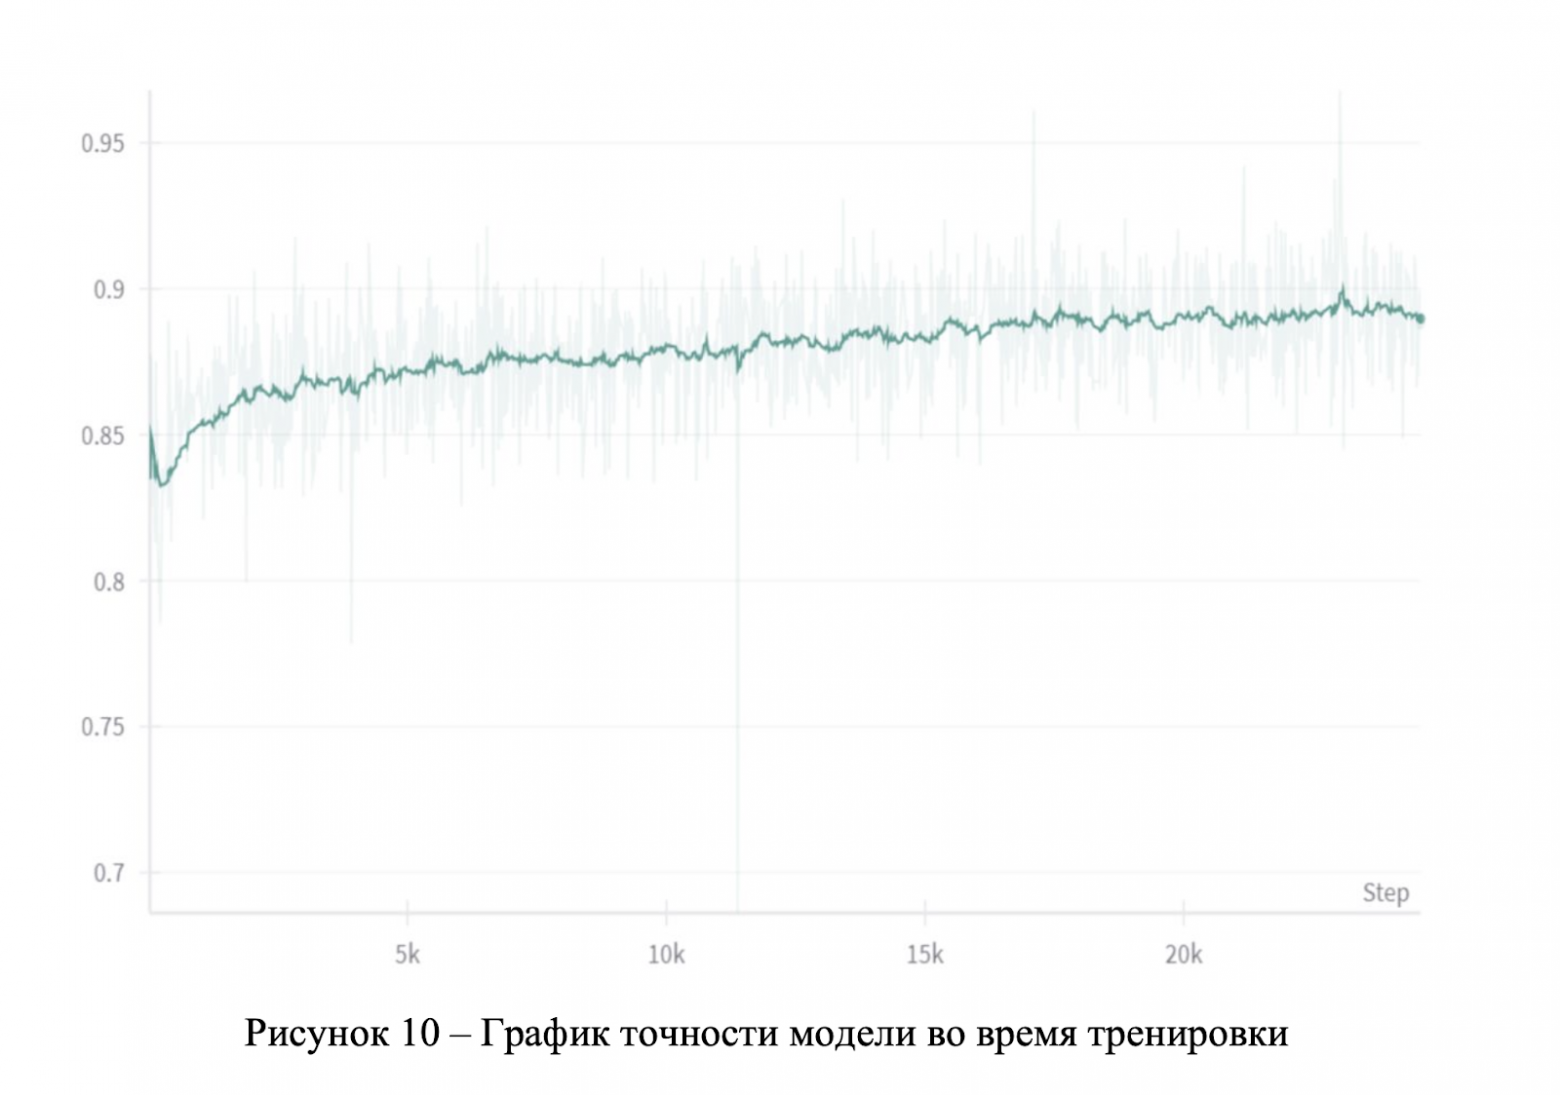
Тренировочная точность из статьи, отдельно от MERA и BertScore на задаче суммаризации.
Источник: Евгений Гутин · AIGendaMERA проверяет общие способности русскоязычной модели
После языкового дообучения команда использовала MERA — открытый набор задач для оценки фундаментальных моделей на русском языке. Это важное разделение уровней проверки: MERA показывает поведение модели на разных русскоязычных задачах, но не измеряет качество протоколов встреч как продукта.
Для отправки результатов использовали библиотеку MERA и закрытый лидерборд. Тестовый сервер указан отдельно: Ubuntu 20.04.6 LTS, Nvidia RTX 4090 с 24 GB VRAM, 16 ядер Intel Ice Lake, 32 GB RAM и 64 GB SSD. Эта конфигурация описывает среду запуска оценки и не является конфигурацией обучения, где использовались две RTX A6000.
Раздел «Как оценивали качество языковой модели»Результаты MERA: улучшение относительно Mistral 7B, но не победа на всех задачах
Таблица сравнивает AiGenda LLM с базовым Mistral 7b, GigaChat Lite+ и MTS Chat 7b. Метрики различаются по задачам, поэтому строки нельзя усреднять в один несуществующий «процент качества». В CheGeKa приведены F1 и EM, в большинстве задач — Accuracy, в ruHumanEval — pass@k, в ruWorldTree и ruOpenBookQA одновременно Avg. F1 и Accuracy, а для ruDetox указана метрика Complex.
Таблицу можно прокрутить по горизонтали.
AiGenda LLM превосходит базовый Mistral 7b на многих строках и лидирует, например, на LCS, PARus, SimpleAr и ruHHH. Но это не универсальная победа: GigaChat Lite+ выше на CheGeKa, ruWorldTree и ruOpenBookQA; MTS Chat 7b выше на RWSD и MathLogicQA. В ruHumanEval AiGenda и MTS Chat имеют одинаковые три значения.
У ruHumanEval указано три значения pass@k, но сами значения k в таблице не подписаны. Поэтому их нельзя называть pass@1, pass@5, pass@10 или приписывать им другие конкретные k. Для ruDetox таблица выделяет другое лучшее значение, но статья не объясняет направление метрики Complex; безопаснее сохранить число без дополнительной интерпретации.
Вывод из таблицы: полное языковое дообучение заметно изменило поведение Mistral 7B на русском и улучшило многие измеренные задачи, но профиль качества остаётся неоднородным. Это аргумент в пользу адаптации, а не доказательство превосходства над всеми сравниваемыми моделями по любой русскоязычной задаче.
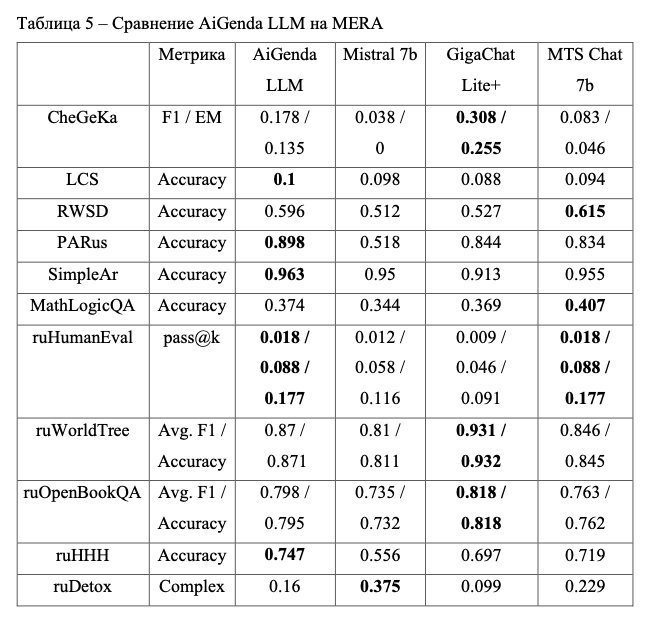
Исходная таблица MERA. Модель выигрывает не на каждом наборе: важно сохранять разные метрики и все варианты сравнения.
Источник: Евгений Гутин · AIGendaПосле MERA автор отдельно отмечает работу в длинном контексте
Помимо бенчмарка автор сообщает о двух практических наблюдениях: ошибок в диалоговом общении стало заметно меньше, а извлечение информации хорошо работает в контексте 8192 токенов при низком уровне галлюцинаций. Отдельной методики, размера выборки или численной оценки для этих утверждений в статье нет.
Поэтому эти наблюдения стоит читать как инженерный опыт команды после языковой адаптации, а не как новую количественную метрику и не как подтверждение качества реальных протоколов на пользовательском трафике.
Абзац после таблицы MERAВторая LoRA решает уже узкую задачу протоколирования
После общей языковой адаптации постановка меняется. Теперь модель уже должна не «научиться русскому», а стабильно выполнять конкретную инструкцию над диалогом. Для этого команда снова применяет LoRA, но на других данных и с другой целью.
Собран мультиязычный набор диалогов с инструкциями. Аннотации получали двумя способами: вручную и через API GPT-4. Набор покрывает три задачи: суммаризацию, выделение action items — конкретных задач после обсуждения — и выделение топиков. Размер этого датасета, доля ручной разметки и способ разделения на обучающую и тестовую части в статье не указаны.
Раздел «Финальное дообучение под задачу»Валидационная функция потерь показывает устойчивое улучшение LoRA
Для task-specific LoRA автор показывает функцию потерь на валидационном наборе. В отличие от тренировочного графика, validation loss считается на данных, которые не используются непосредственно для обновления параметров на этом шаге, и поэтому помогает следить, переносится ли улучшение за пределы текущего пакета обучения.
Кривая на рисунке снижается по мере шагов. Это подтверждает улучшение именно выбранной учебной цели на валидации, но всё ещё не является итоговым измерением качества протокола. Финальная предметная метрика в статье появляется отдельно — BertScore F1.
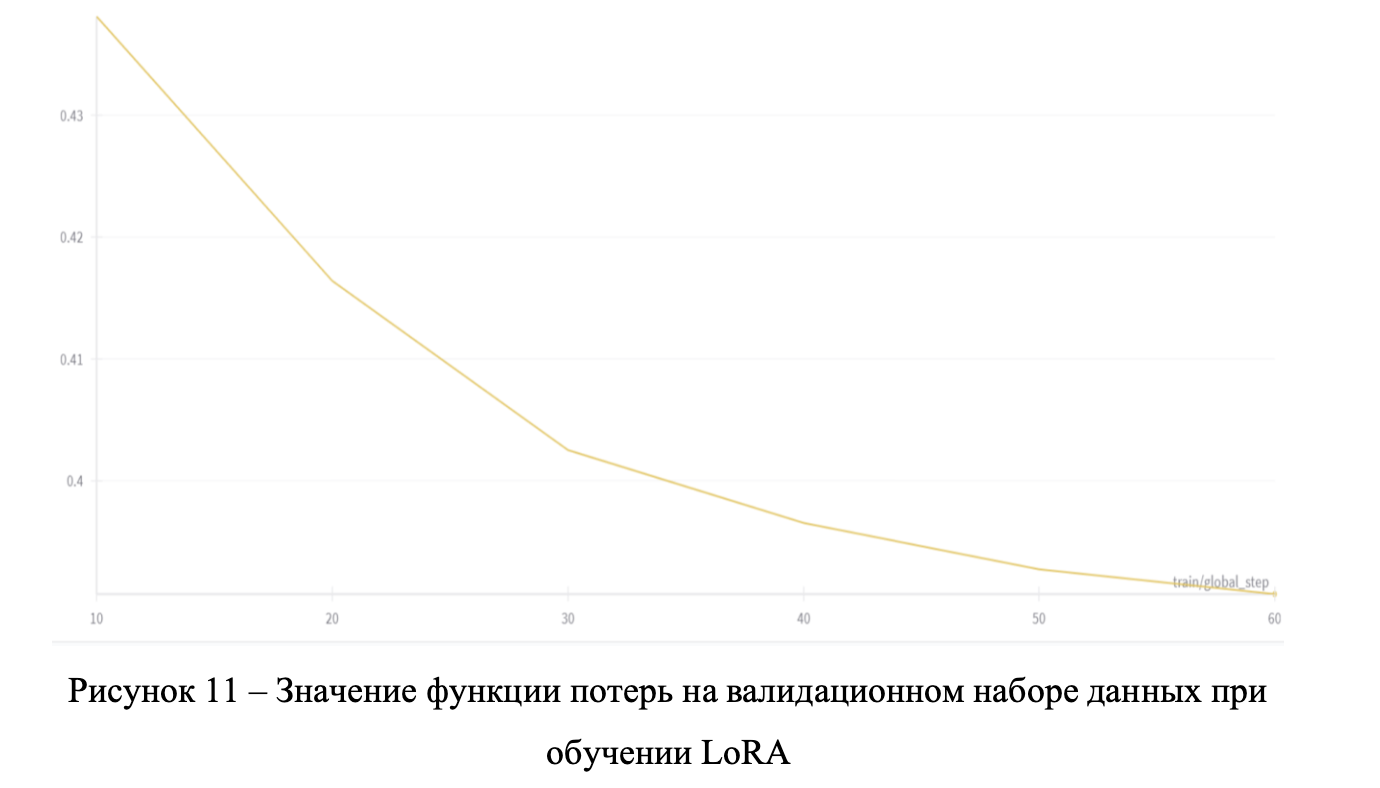
Дообучение под суммаризацию после языковой адаптации. Валидационный график не заменяет итоговую оценку задачи.
Источник: Евгений Гутин · AIGendaРазные rank и alpha не дали существенного различия
Для LoRA автор сравнивает несколько сочетаний rank и alpha. Rank задаёт размер низкорангового представления обновления весов, а alpha масштабирует вклад LoRA-адаптера. На графике представлены конфигурации R16/A16, R16/A8, R8/A8 и R8/A16.
Кривые близки, и автор прямо пишет, что значительной разницы между вариантами не обнаружено. Поэтому из небольшого расхождения конечных значений нельзя выбирать универсально «лучший» rank или alpha. Вывод рисунка ограничен этим экспериментом: в проверенном диапазоне конфигурация не оказалась главным фактором итогового качества.
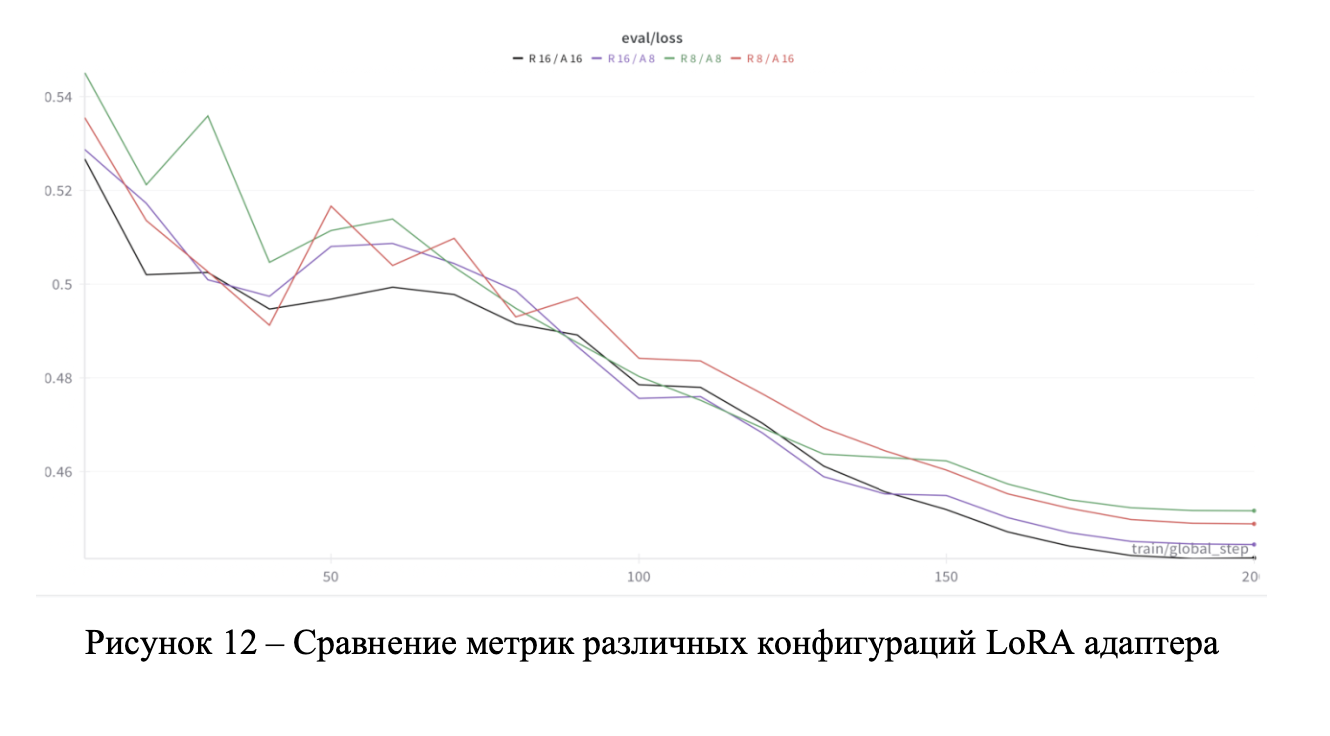
Автор не сообщил существенной разницы между вариантами. Из рисунка нельзя объявлять один вариант универсально оптимальным.
Источник: Евгений Гутин · AIGendaBertScore F1 0.93 относится к суммаризации диалогов
После финального дообучения статья сообщает BertScore F1 = 0.93 для суммаризации диалоговых данных. BertScore сравнивает семантическую близость сгенерированного текста и эталона через контекстные представления токенов. Это не доля полностью правильных протоколов и не процент встреч без ошибок.
Автор также пишет, что модель выделяет все три требуемых типа ответа и возвращает их в фиксированном формате. На примере видно отдельные поля для краткого содержания, задач и заголовка. Этот пример показывает структуру выдачи, но сам по себе не является дополнительной метрикой.
Вывод из примера: финальная LoRA используется как специализация уже адаптированной языковой модели — она должна не переучить русский язык, а стабилизировать типы полей и способ ответа на диалоговую инструкцию.
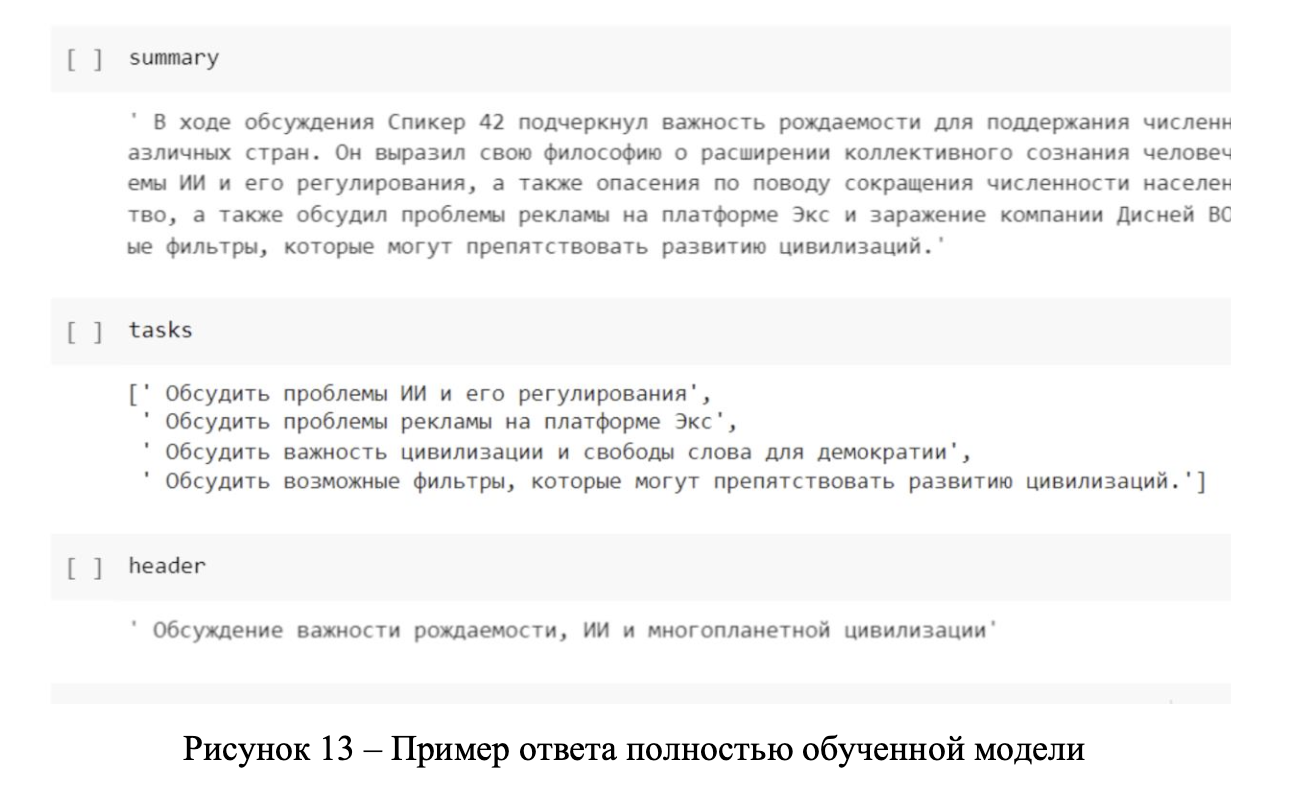
Оригинальный пример фиксированного формата ответа модели: краткое содержание, задачи и заголовок/тема. Это иллюстрация, не отдельный показатель качества.
Источник: Евгений Гутин · AIGendaWhisper дообучали отдельно на аудио, похожем на реальные встречи
Качество протокола ограничено качеством стенограммы, поэтому речевая модель развивалась отдельной веткой. Базовый Whisper, по описанию автора, не был оптимизирован под встречи с плохим звуком и посторонними шумами. Для адаптации собрали данные из трёх типов источников: лекций, конференций и интервью. Более половины материалов были русскоязычными.
Первичную разметку получали псевдолейблингом: существующая модель автоматически строит транскрипцию, которая затем становится черновиком для человека. После этого использовали полу-ручную правку. Чтобы быстрее находить ошибки, транскрипцию сопоставляли со словарём. Пример из статьи: если модель пишет «ЭТМО» вместо «ИТМО», подозрительный фрагмент подсвечивается для проверки.
После разметки данные очищали и отбирали в формат, пригодный для обучения. В статье не приведён объём корпуса в часах или число записей, поэтому из описания можно восстановить процесс подготовки, но не масштаб датасета.
Раздел «Дообучение модели распознавания речи»После дообучения WER снизился на обоих показанных наборах
Для распознавания речи используется WER — Word Error Rate, доля ошибок на уровне слов с учётом замен, удалений и вставок. Чем ниже WER, тем ближе транскрипция к эталонному тексту.
На графике сравниваются базовый и дообученный Whisper на двух наборах данных. В обоих случаях столбец Fine-Tune ниже столбца Base, что согласуется с текстовым выводом автора о снижении ошибок русской речи.
Точные значения столбцов на рисунке не подписаны, поэтому их нельзя восстанавливать по высоте столбцов или превращать в точный относительный процент улучшения. Подтверждённый вывод только один: WER после дообучения уменьшился на обоих показанных наборах.
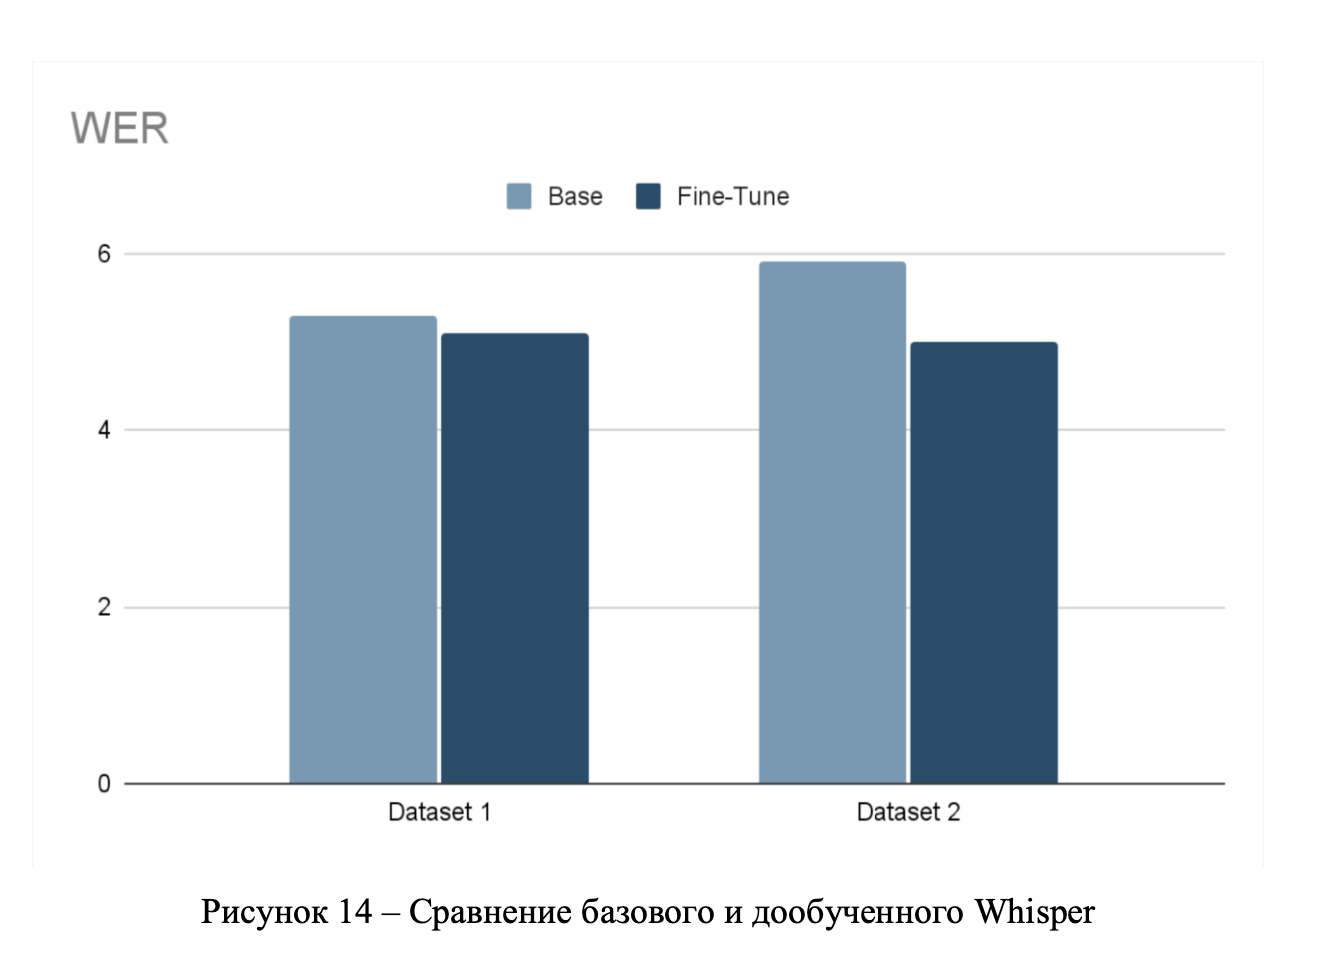
Исходный график показывает снижение WER. Точные значения столбцов и единицы шкалы не подписаны; они не восстановлены по пикселям.
Источник: Евгений Гутин · AIGendaСледующие шаги: контекст 128k и новые базовые архитектуры
Автор подчёркивает, что модель рассматривается как постоянно развивающаяся система. В планах два технических направления: расширить контекстное окно до 128 тысяч токенов и экспериментировать с более свежими базовыми архитектурами.
Параллельно команда продолжает собирать обратную связь пользователей. В статье это обозначено как направление дальнейшей работы, а не как уже измеренный эффект. Нет описания бизнес-A/B-теста, размера пользовательской выборки, доверительных интервалов, SLA или стоимости обработки одной встречи.
Раздел «Что дальше»Итог: как встреча проходит через систему и как отдельно проверяют модели
История AiGenda показывает две разные задачи адаптации. Сначала команде пришлось улучшить фундаментальную работу Mistral 7B с русским языком: первая LoRA сгладила отдельные ошибки, но не исправила слабую логику, поэтому все веса дообучили на корпусе из 5,35 млрд токенов. Затем уже адаптированную модель снова дообучили через LoRA, но теперь на диалоговых инструкциях для суммаризации, задач и топиков. Параллельно отдельно адаптировали Whisper к шумным встречам.
- 01
Запись встречи
Meeting Controller организует запись видеоконференции и получает для неё необходимые облачные ресурсы через OpenStack API.
- 02
Распознавание речи
Дообученный Whisper превращает аудио в текст; качество этого шага отдельно проверяется метрикой WER.
- 03
Разделение говорящих
Компоненты сегментации и кластеризации выделяют речевые участки и связывают их с разными участниками.
- 04
Разделение на темы
Система ищет смену темы по расстояниям между эмбеддингами предложений и подготавливает структуру длинного диалога.
- 05
Формирование протокола
Языковая модель получает подготовленный текст и возвращает фиксированный результат с кратким содержанием, задачами и тематическим заголовком.
Обучение и оценка при этом идут отдельными контурами. Полное языковое дообучение контролировали по тренировочным графикам, а общую русскоязычную способность проверяли на MERA: AiGenda LLM улучшила многие строки относительно Mistral 7B, но не была лучшей в каждой задаче. Финальную LoRA оценили отдельно: для суммаризации заявлен BertScore F1 0.93, что означает семантическую близость к эталону, а не 93% безошибочных протоколов. Whisper оценивали по WER; рисунок подтверждает снижение ошибки, но не даёт подписанных точных значений. В статье нет бизнес-A/B-теста, N, доверительных интервалов или SLA, поэтому её результат — инженерная история построения и адаптации системы, а не доказательство бизнес-эффекта.
Итог по разделам «Что внутри задачи», «Архитектура», языковое дообучение, финальная LoRA, Whisper и «Что дальше»