Разбор готов
Яндекс Маркет: как LLM превращает историю действий в долгосрочные интересы
В рекомендательной ленте Яндекс Маркета мало знать, что покупателю нравятся беговые кроссовки: он может заниматься бегом, а может носить их каждый день как часть своего стиля. Прежняя система уже находила предпочтительные категории товаров, но не объясняла, какие увлечения и потребности за ними стоят. Владислав Уржумов рассказывает, как команда стала извлекать более содержательные интересы из истории действий с помощью YandexGPT и связывать их с товарами через существующие генераторы кандидатов. Разбор проходит весь путь: от ограничений LightFM и идеи внешнего RecGPT до сжатия истории, фиксированного списка интересов, продуктовых результатов и вопросов о холодном старте, семейных аккаунтах и изменении увлечений.
Материал полезен тем, кто знаком с основами рекомендаций и хочет понять, как встроить LLM в действующую систему, не заменяя весь подбор товаров. Особенно интересны сохранение смысла длинной истории, переход от интереса к категориям и параметрам, переиспользование профиля и различие между техническими показателями и поведением покупателей.
Видео · на русском
LLM в рекомендациях: теперь мы знаем почти всё о стиле жизни и вкусах покупателя / Владислав УржумовВладислав Уржумов · Опубликовано: 31 марта 2026 г.
Исходный доклад · Открыть оригинал
Зачем видеть за действиями историю покупателя
Доклад начинается с различия между отдельным наблюдением и историей. По одной фотографии трудно понять человека; последовательность событий даёт гораздо больше контекста. Для рекомендаций такой историей становятся действия покупателя на маркетплейсе. Задача — увидеть за ними не только востребованные товары, но и устойчивые увлечения, предпочтения и связанные потребности.
Автор связывает это с тремя продуктовыми ожиданиями. Более подходящие товары должны удерживать внимание в рекомендательной ленте, помогать переходу от корзины к заказу и открывать категории, в которых человек ещё ничего не делал. Последняя цель особенно важна: новая категория может оказаться релевантной уже известному увлечению, хотя прямого взаимодействия с ней в истории пока нет. В начале выступления это именно мотивация разработки, а не перечень измеренных результатов.
Сквозной пример устроен так же, как предлагаемая персонализация. Докладчик сначала почти ничего не рассказывает о себе, затем показывает категории и более подробные интересы, а ближе к концу раскрывает, кому принадлежала история. Такой ход позволяет сравнить два представления одного аккаунта: перечень товарных предпочтений и более понятный профиль увлечений. Дальше важно проследить не только, как получить этот профиль, но и как превратить его в реальные рекомендации.
Доклад · 00:00:18Исходная система: LightFM предсказывает интерес к категориям
На схеме долгосрочные интересы — одна из параллельных ветвей рекомендательной системы. Она начинается с действий пользователя в категориях, проходит через LightFM и профиль интересов, затем передаёт результат генераторам кандидатов. Другие ветви продолжают поставлять свои товары. Поэтому улучшение этой части не означает замены всей ленты одной моделью.
LightFM автор объясняет через гибридную матричную факторизацию. Модель работает с матрицей взаимодействий, но представление пользователя собирается из векторов его признаков: такие векторы складываются в общее представление. В Маркете используется несколько изменённый вариант этого подхода. Подробности модификации не раскрываются.
Целевая сущность здесь — категория, а не отдельный товар. Модель оценивает, насколько пользователю интересны, например, беговые кроссовки, холодильники или мобильные телефоны. Это промежуточный уровень: он хорошо объединяет товары, но ещё не задаёт их подробные характеристики. Категории с наиболее высокими оценками сохраняются в профиль пользователя.
Дальше работают генераторы кандидатов — модели, которые подбирают конкретные товары. Они получают предпочтительные категории и приносят релевантные пользователю позиции из этих категорий. В этой границе между профилем и товарным подбором заключена возможность последующего переиспользования: способ описывать интерес можно изменить, не разрабатывая все генераторы заново.
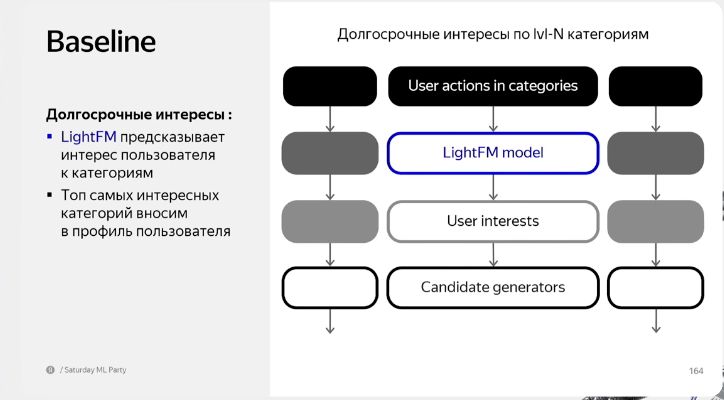
LightFM оценивает интерес к категориям; верхняя часть списка попадает в профиль пользователя и используется генераторами кандидатов.
Источник: Владислав Уржумов · Яндекс МаркетЧто уже давал источник долгосрочных интересов
Слайд характеризует исходный вариант на LightFM. Источник уже занимал заметное место в ленте и приносил новые взаимодействия, поэтому команда улучшала работающий подход, а не начинала персонализацию с нуля.
Таблицу можно прокрутить по горизонтали.
Доля 20–25% определяется динамически, а не задаёт постоянную квоту для каждого пользователя. Топ-16 относится к этому исходному способу наполнения профиля. И +1,85%, и долю в ленте следует отличать от результатов новой версии с LLM: это исходная точка сравнения, а не эффект последующего изменения.
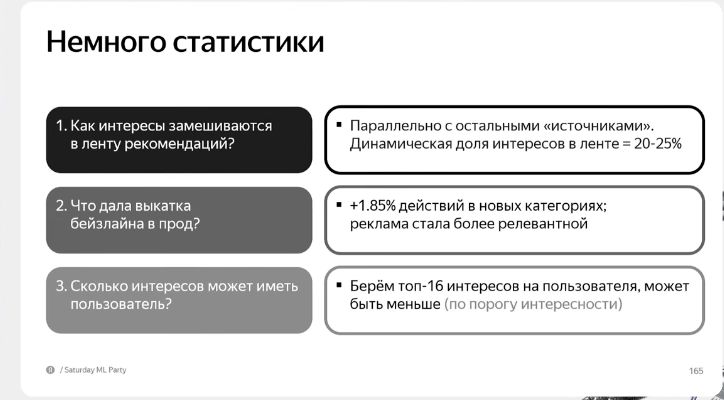
Интересы занимают 20–25% ленты; после запуска baseline автор сообщил +1,85% действий в новых категориях. Эти показатели относятся к исходному решению.
Источник: Владислав Уржумов · Яндекс МаркетПочему любимая категория ещё не объясняет интерес
Список категорий может быть полезен для подбора товаров и одновременно оставлять непонятным намерение покупателя. Автор разбирает шесть предпочтений одного профиля. Каждое допускает несколько объяснений, причём от объяснения зависит, что стоит рекомендовать дальше.
Вместо механического повторения категорий автор предлагает ориентироваться на заботливого знакомого: тот помнит, чем человек увлекается, и замечает связанные потребности. В примере с пробежкой рекомендацией может стать подходящая еда после занятия, а не только ещё одна пара кроссовок. Это объяснение желаемого поведения системы, а не отдельный измеренный сценарий.
Отсюда появляется задача для LLM: прочитать совокупность действий, сформулировать более содержательный интерес и затем связать его с товарами. Интерес не должен оставаться красивым описанием человека — ему нужен понятный путь обратно в каталог.
Доклад · 00:07:48Внешний RecGPT: от широкого интереса до объяснения товара
Команду заинтересовал RecGPT, подход рекомендательной команды TaoBao. На иллюстрации показана его финальная часть: LLM получает интересы и таблицу товаров с оценками релевантности, после чего объясняет конкретную рекомендацию. Это завершение более длинной цепочки, которую автор пересказывает в четырёх шагах.
- 01
Широкие интересы
История взаимодействий за всё время активности пользователя поступает в LLM вместе с промптом. Модель возвращает интересы вроде рыбалки с берега или пробежек на улице.
- 02
Узкие товарные теги
LLM получает ту же историю и интересы предыдущего этапа. Она уточняет их до товарных описаний с характеристиками: например, непромокаемых походных ботинок или удочки определённого типа, материала и цвета. Такой тег соответствует уже небольшой группе товаров, а не целому увлечению.
- 03
Подбор и оценка товаров
Трёхбашенная модель строит векторные представления пользователя, тегов и товаров. Затем нейросеть вычисляет оценки релевантности товаров конкретному пользователю в контексте тега. Эти оценки позволяют упорядочить кандидатов.
- 04
Объяснение рекомендации
LLM получает набор интересов и таблицу товаров с оценками и отвечает, почему именно этот товар рекомендован. На слайде также предлагается впоследствии использовать такие объяснения как лог рекомендаций.
Здесь последовательно меняется уровень описания: история превращается в увлечение, увлечение — в товарный тег, тег связывается с конкретными позициями, а результат можно объяснить. Иллюстрация не доказывает, что Маркет внедрил генерацию объяснений или трёхбашенный подбор. Она показывает возможность внешнего подхода, из которого команда выбрала свою отправную точку.
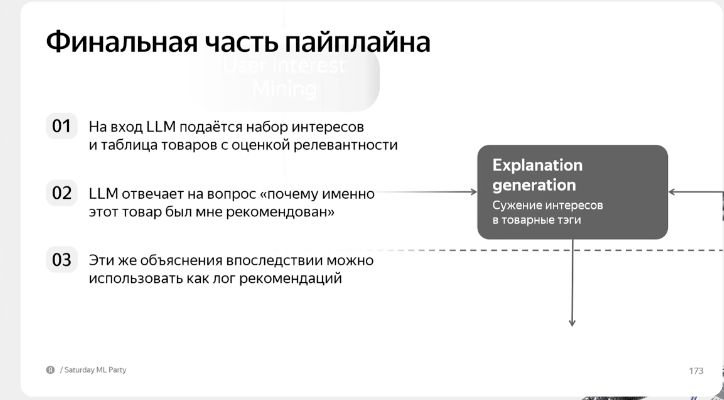
Часть внешнего подхода RecGPT: модель объясняет рекомендации по интересам и оценкам релевантности. Это не собственное внедрение Маркета.
Источник: Владислав Уржумов · Яндекс МаркетДля начала выбрали извлечение широких интересов
Команда Маркета не стала начинать с воспроизведения всех четырёх блоков RecGPT. Первоначальный фокус — извлечь широкие интересы пользователя. Это именно та часть, которая меняет смысл профиля: вместо предпочтительных категорий появляется описание того, зачем человеку могут быть нужны разные товары.
Даже этот этап нельзя свести к одному запросу в LLM. Нужно подготовить длинную историю, сгруппировать действия, определить допустимые интересы, сохранить результат в профиль и организовать его использование. Таким образом, выбранная граница работы охватывает не только текстовый ответ модели, но и его совместимость с существующим продуктом.
Доклад · 00:12:31Результаты TaoBao: мотивация, а не метрики Маркета
Слайд с результатами RecGPT относится к TaoBao. Он показывает изменения поведения пользователей и взаимодействий с рекомендованными товарами. Это не офлайн-проверка полноты поиска кандидатов и не результат внедрения новой версии в Маркете.
Таблицу можно прокрутить по горизонтали.
Автор отдельно обращает внимание на корзину и время в карточке: человек не только замечает товар, но и рассматривает его характеристики и описание. Рост добавлений в корзину он связывает с потенциальным дальнейшим ростом заказов, однако сам слайд не измеряет такой переход. Dwell Time здесь также не означает время во всей рекомендательной ленте.
Эти результаты объясняют интерес команды к идее, но не заменяют проверку на собственном продукте. Следующая часть доклада посвящена именно тому, почему перенести подход без изменений не получилось.
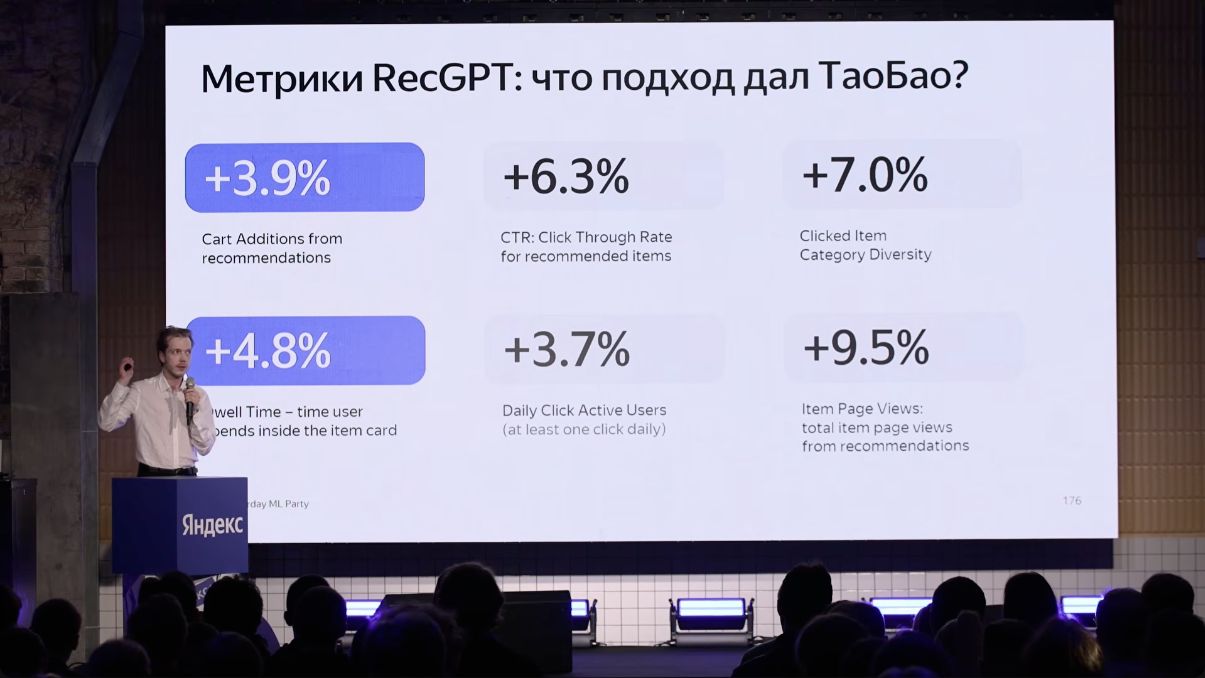
Результаты другого продукта — TaoBao. Его показатели CTR, добавлений в корзину и просмотров нельзя приписывать Маркету.
Источник: Владислав Уржумов · Яндекс МаркетТри причины не переносить решение буквально
Первая причина — различия в истории, доступной модели. Системы логирования двух маркетплейсов складывались независимо и выделяют разные действия. В примере автора раскрытие описания внутри карточки в Маркете не выделяется в отдельный тип действия, тогда как TaoBao рассматривает его отдельно от других кликов. Поэтому одинаково названная история пользователя ещё не означает одинаковый вход для LLM.
Вторая причина связана с аудиторией. Автор считает различия поведения, привычек и ожиданий российских и китайских покупателей важными для адаптации. Для Маркета нужен способ интерпретировать собственные действия в контексте своего продукта, а не просто повторить чужую инструкцию модели.
Третья причина — уже работающая инфраструктура долгосрочных интересов. Команда хотела сохранить профиль пользователя и существующий товарный подбор. Эти условия определяют дальнейший выбор: собственная LLM, более компактная история и такой формат интересов, который можно передать прежним генераторам кандидатов.
Доклад · 00:14:30Выбор YandexGPT, промпт и сведения об обучении
На слайде выбранная модель названа YandexGPT (Alice AI LLM). Автор поясняет, что работа начиналась с YandexGPT. Выбор мотивирован адаптацией к российскому рынку, возможностью легче дорабатывать собственную модель, более дешёвым использованием и большей скоростью вычислений.
Возможность работать с моделью внутри Яндекса упрощает её использование и доработку под задачу. Вместе с моделью применяется адаптированный промпт. При этом точный текст инструкции, состав обучающей выборки, протокол дообучения и его параметры в докладе не приведены. Описанные способы подготовки входа и ограничения ответа не следует превращать в неописанную процедуру обучения.
Компромисс — контекстное окно от 30 до 64 тысяч токенов в зависимости от версии, меньшее, чем у модели из разбираемого RecGPT. В него нужно поместить историю за всё время активности покупателя. Поэтому экономичность выбранной модели не отменяет отдельной задачи: сохранить полезное содержание истории, сократив её размер. Денежная стоимость обработки одного профиля и абсолютная скорость генерации здесь не названы.
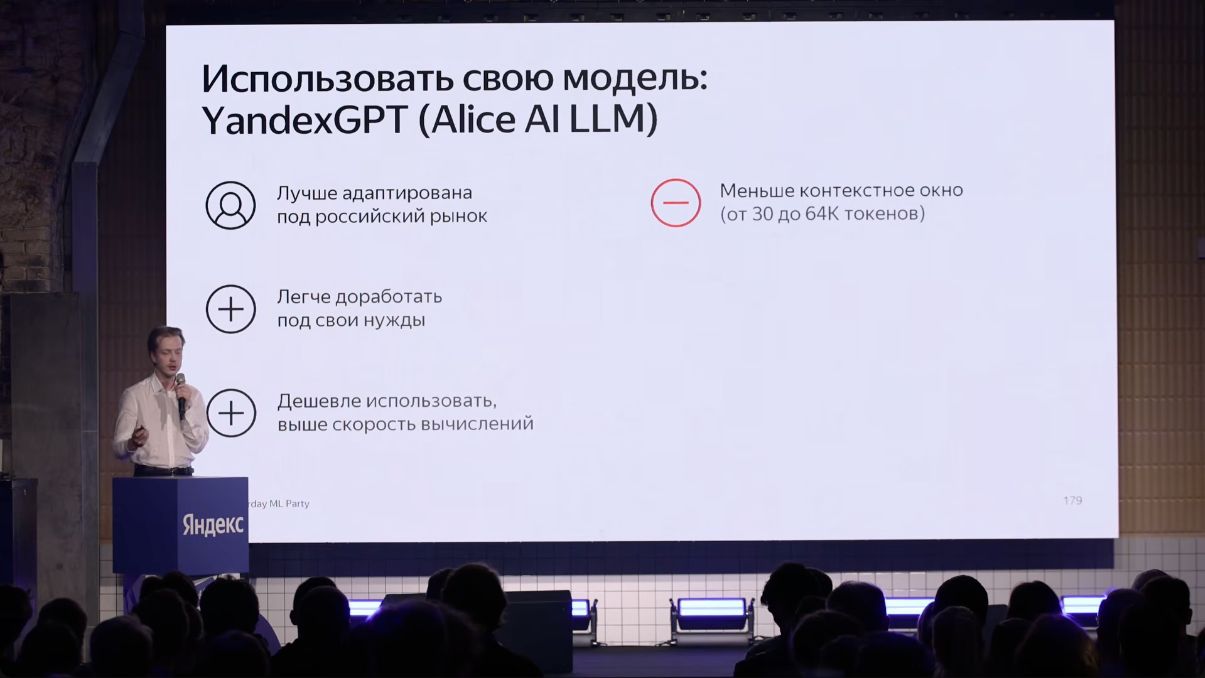
Команда выбирает YandexGPT / Alice AI LLM; контекстное окно от 30 до 64 тысяч токенов и причины выбора собственной модели.
Источник: Владислав Уржумов · Яндекс МаркетКак сократить историю, не превратив её в набор случайных кликов
Шесть правил на слайде решают одну задачу: убрать избыточные записи, сохранив сведения, по которым можно восстановить интересы. Сжатие не сводится к обрезке истории до последних событий. Автор старается оставить сильные сигналы, временной контекст и подробности наиболее важных для покупателя категорий.
Пример с датами показывает, почему важен не только размер. При точности до половины месяца остаётся возможность отделить покупки к 23 февраля от покупок к 8 марта. Если же оставить только тип товара и совсем убрать время, эта часть истории исчезнет.
А пример с заказом показывает, почему число действий не равно количеству полезных сведений. Несколько записей могут описывать движение к покупке одного товара. Сохранение заказа вместо всей такой последовательности освобождает место для других событий. Правило любимых категорий дополняет это решение: система не стремится одинаково сильно сокращать все части истории.
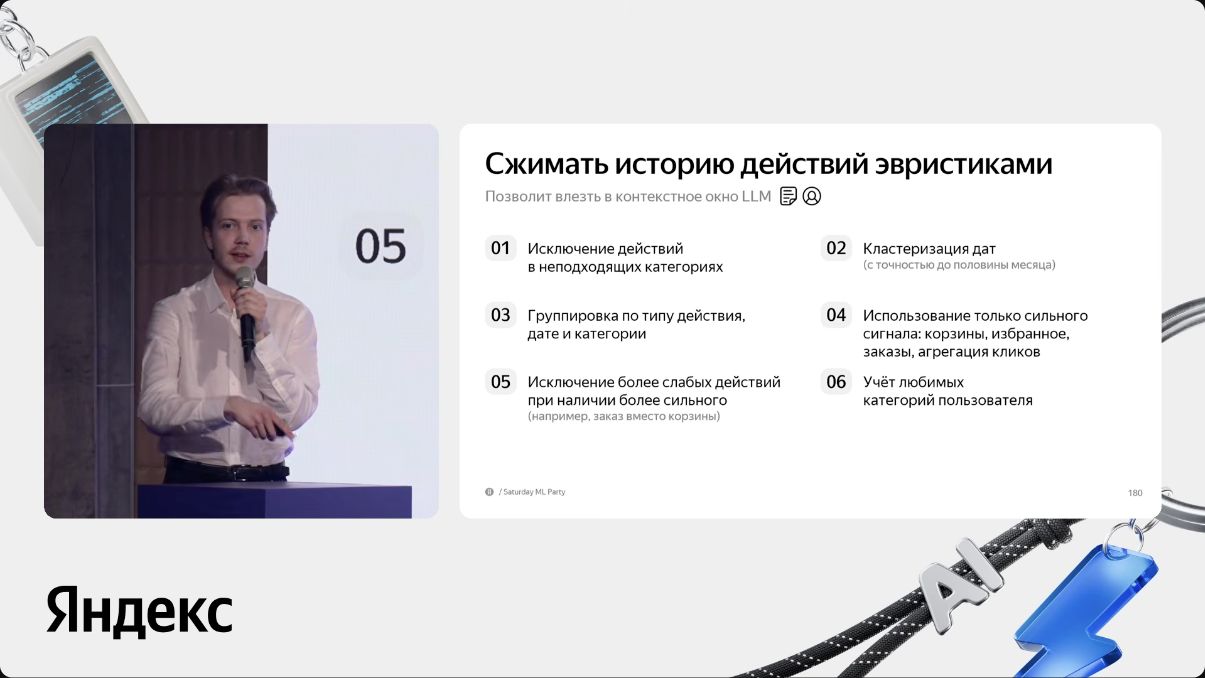
Группировка действий и дат, сильные сигналы и удаление избыточных действий позволяют поместить историю в контекст LLM.
Источник: Владислав Уржумов · Яндекс МаркетЧто изменилось после сжатия истории
Результат сжатия на слайде описан сразу в нескольких измерениях: сколько поведения сохранилось, насколько уменьшилось число действий, какой стала длина входа и как изменилась вычислительная эффективность. Эти показатели отвечают на разные вопросы и не заменяют оценку рекомендаций.
Таблицу можно прокрутить по горизонтали.
Для показателя 98% автор устно упоминает категории, подкатегории и сигналы в сторону товаров, которые остаются отражены в сокращённой истории. Однако методика вычисления не раскрыта: нет формулы и точного правила, по которому поведение считается сохранённым. Поэтому это число нельзя переименовать в accuracy, recall или утверждение о сохранении 98% всей информации.
Практический вывод из остальных чисел более определённый: средний вход стал короче, а p95 истории оказался ниже 30 тысяч токенов — нижней указанной границы окна выбранной модели. Это объясняет, как команда справлялась с длинными историями. При этом p95 не является максимальной длиной и не гарантирует, что поместится каждая история. Рост вычислительной эффективности также не означает два отдельно доказанных эффекта: ускорение на 29% и снижение денежных затрат на 29%.
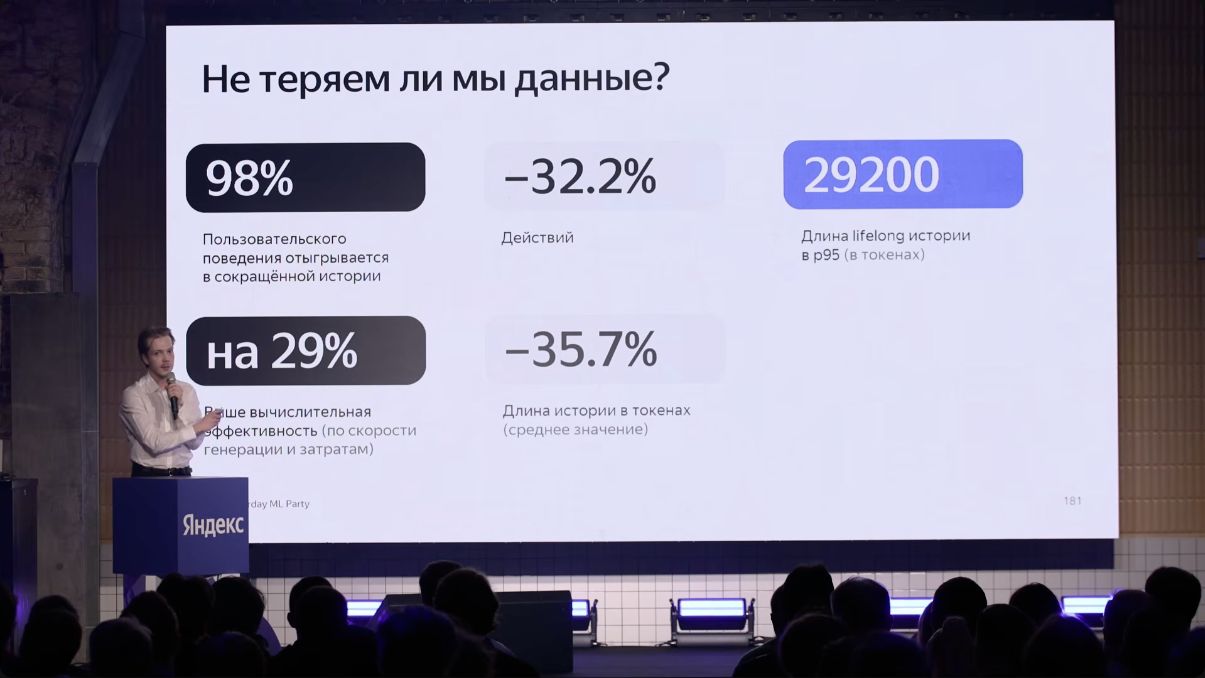
−32,2% действий, −35,7% средней длины в токенах, p95 29 200 токенов. 98% описывает сохранение поведения по оценке автора, а не точность рекомендаций.
Источник: Владислав Уржумов · Яндекс МаркетФиксированный список интересов и совместимый профиль
На слайде переиспользование начинается не с генераторов, а с самого результата LLM. Свободные формулировки плохо подходят для стабильного профиля: «ботинки походные» и «походные ботинки» могут обозначать одно и то же, но записаться как разные интересы. Другая крайность — ответы вроде «одежда» или «одежда и обувь», которые объединяют слишком много разных предпочтений.
Автор рассматривает два пути: строить векторные представления текстов и объединять похожие формулировки либо заранее зафиксировать допустимые интересы. Команда выбирает второй. Модель по-прежнему анализирует историю, но результат должен принадлежать определённому набору интересов, а не произвольному множеству текстовых описаний.
Для этого используются Structured Outputs: JSON-схема задаёт формат ответа, а декодирование с ограничениями — constrained decoding — ограничивает пространство возможных ответов. В описанной задаче это нужно, чтобы LLM возвращала именно допустимые интересы. Стабилизируется не только написание слов, но и форма данных, которую получает следующая часть системы.
Полученные интересы сохраняются в профиль пользователя так же, как в исходной системе. На слайде отдельно указана возможность использовать их вместо существующего решения или вместе с ним и сравнивать метрики. Это первая часть переиспользования: меняется способ наполнения профиля и содержательность интересов, но не требуется заново придумывать место их хранения и использования. Следующая часть — перевод этих интересов в область поиска товаров.
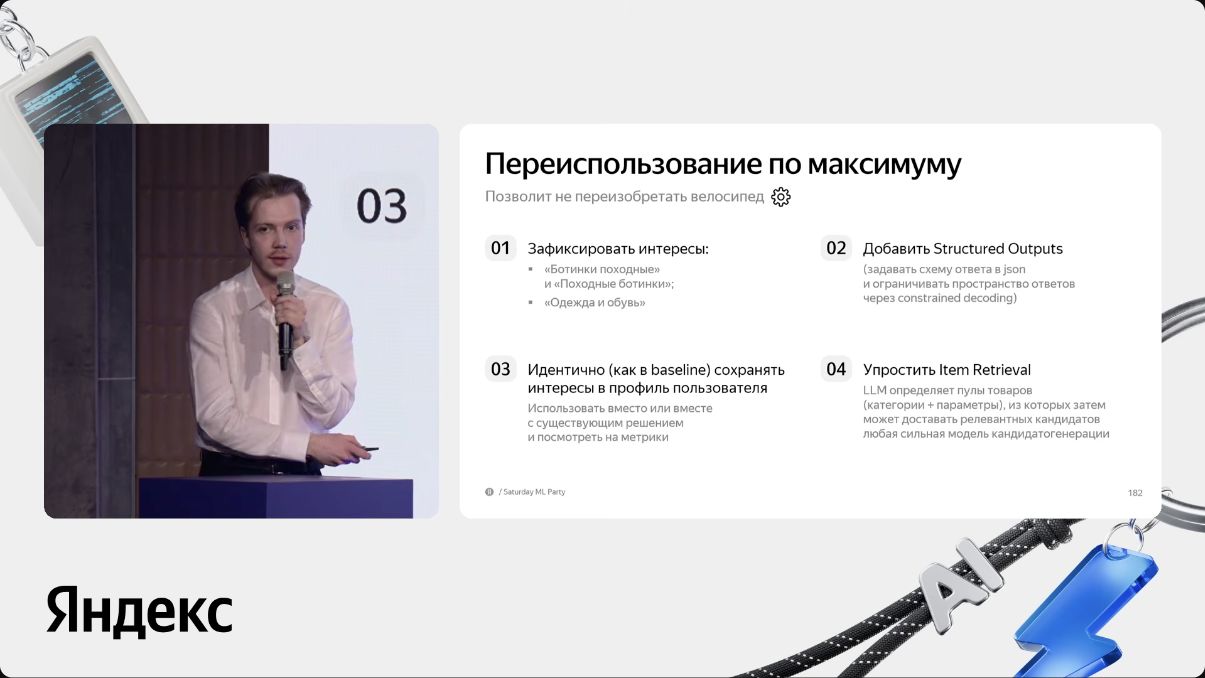
Фиксированный список интересов и структурированный JSON связывают LLM с профилем пользователя; категории и параметры задают область поиска кандидатов.
Источник: Владислав Уржумов · Яндекс МаркетОт интереса к товарам через прежние генераторы
В исходной схеме генераторы получали категории. В новой LLM просят для каждого интереса определить категории и параметры внутри них: например, бренд, цвет или объём памяти. Одному интересу могут соответствовать несколько наборов «категория + параметры». Так широкое увлечение превращается в конкретные области каталога, из которых имеет смысл выбирать товары.
Затем эти наборы передаются тем же генераторам кандидатов. LLM не обязана сама выбирать окончательный список товаров из всего маркетплейса: она определяет подходящие товарные группы, а существующие модели достают релевантные позиции. В этом и состоит вторая часть переиспользования — сохраняется товарный подбор, уже работавший с предыдущей версией интересов.
Поэтому реализация Маркета отличается от полного RecGPT. Вместо обязательного внедрения описанной трёхбашенной модели она связывает новые интересы с прежней инфраструктурой через категории и параметры. Новое содержание профиля не остаётся отдельным текстом: у него появляется рабочий переход к кандидатам. Как часто пересчитывается это соответствие и как устроено последующее объединение товаров в ленту, в этой части доклада не раскрывается.
Доклад · 00:21:09Один аккаунт: от товарных категорий к узнаваемым увлечениям
После устройства системы автор возвращается к примеру. Он показывает небольшой фрагмент истории, в котором разные действия отмечены разными цветами. В такой истории можно искать повторяющиеся сочетания и замечать события, которые выбиваются из общей картины. Но сам фрагмент — только часть значительно более длинной активности аккаунта.
Новый профиль описывает пробежки на улице, создание парфюмерии, предпочтения в перекусах, рыбалку с берега и стиль одежды. По сравнению с перечнем категорий он отвечает на более содержательные вопросы: не просто какая обувь интересна, а какое занятие за этим стоит; не только какие средства покупаются, а какое конкретное хобби объединяет потребности.
Здесь выясняется, что все показанные истории и интересы принадлежали докладчику. Он подтверждает, что бегает, рыбачит с берега и действительно делает парфюмерию как хобби. Материалы для её создания в ленте оказываются для него особенно приятной рекомендацией. Так завершается начальная аналогия: по истории получилось узнать о человеке больше, чем по нескольким названиям категорий.
Это наглядная проверка осмысленности на одном знакомом автору аккаунте. Она помогает понять желаемый результат, но не даёт общей численной оценки того, насколько точно модель определяет увлечения всех покупателей. Продуктовые результаты обсуждаются отдельно.
Доклад · 00:21:42Результаты Маркета: заказы, покрытие и слепое сравнение
На итоговом слайде Маркета три результата. Первый относится к атрибутированным заказам, второй — к широте категорий, связанных с интересами, третий — к предпочтению нового варианта при слепом сравнении. Их важно читать отдельно: расширение профиля и выбор пользователя не являются другими названиями роста заказов.
Таблицу можно прокрутить по горизонтали.
Расширение покрытия согласуется с исходной идеей: один содержательный интерес может приводить в несколько категорий, а не повторять одну. В слепом сравнении новый и прежний подход не помечаются для пользователя; автор говорит о предпочтении товаров нового источника. Это свидетельство пользовательского выбора, а не точность определения интересов.
Доклад не раскрывает размер выборки, длительность, доверительные интервалы и подробный дизайн эксперимента. Не приведено и правило атрибуции заказов. Поэтому +2,5% следует сохранять именно как изменение атрибутированных заказов: оно не задаёт рост всех заказов или общего оборота Маркета. Результаты TaoBao, показатели исходного LightFM и эти три числа относятся к разным сравнениям и не складываются.
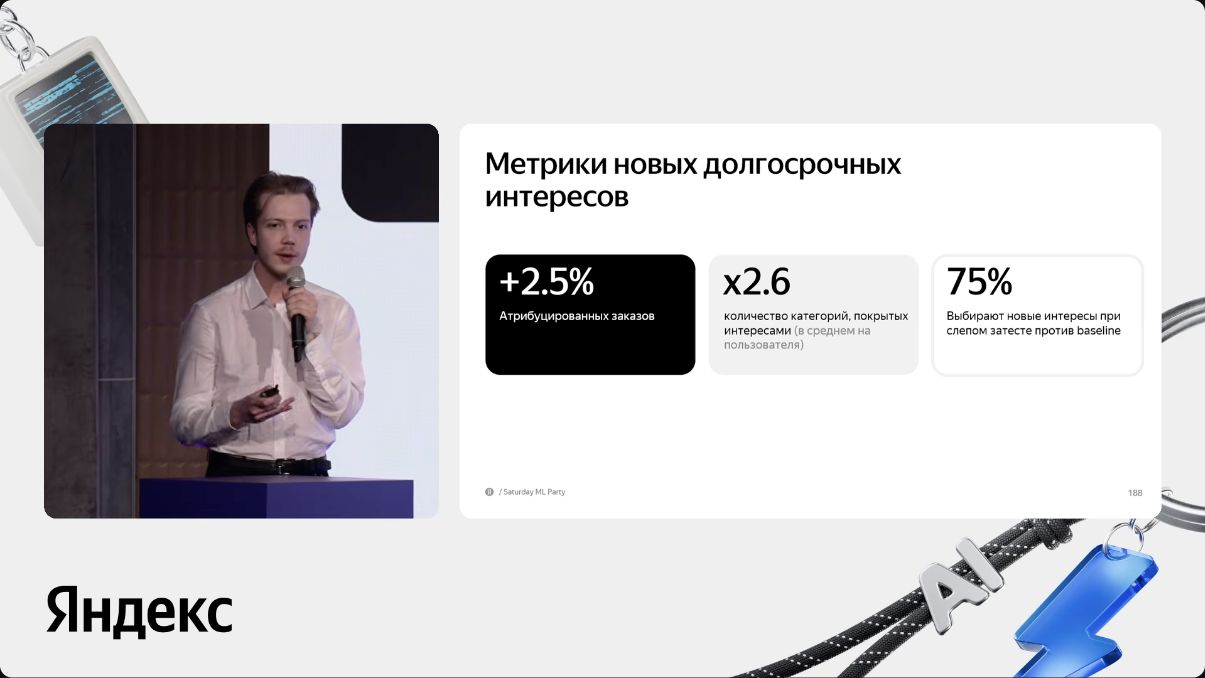
Маркет сообщил +2,5% атрибутированных заказов, в 2,6 раза больше категорий, покрытых интересами, на пользователя и 75% предпочтений нового варианта в слепом тесте против baseline.
Источник: Владислав Уржумов · Яндекс МаркетКак автор проверял собственную ленту перед экспериментом
В финальном примере автор возвращается к просмотру ленты перед запуском эксперимента. Ему последовательно попались парфюм, коллекционная машинка, обувь для рыбалки, семена чиа и одежда. В какой-то момент он начал добавлять товары в корзину и лишь затем вспомнил, что проверяет результат собственной разработки.
История показывает, каким должен ощущаться более содержательный профиль: разные товары оказываются связаны с разными сторонами жизни одного покупателя. При этом это личный просмотр, а не ещё один количественный эксперимент. После него по рассказу автора следовал запуск проверки на пользователях. Дальнейшие вопросы из зала уточняют, где описанный подход остаётся зависимым от истории и других источников рекомендаций.
Доклад · 00:24:24Холодный старт: сначала нужна история
На прямой вопрос о помощи LLM при холодном старте автор отвечает с ограничением: если у пользователя нет истории, извлекать персональные интересы не из чего. В таком случае можно использовать усреднённые интересы либо приносить товары из других источников, чтобы постепенно накопить действия.
В уточняющем вопросе он объясняет роль этих источников. Некоторые подбирают товары, которые в среднем нравятся похожим пользователям; в качестве примеров сходства названы пол и возраст. Эти признаки упоминаются в ответе о других источниках, а не как раскрытый список входов LLM.
После накопления истории можно построить интересы уже для конкретного аккаунта. Поэтому новый способ дополняет механизмы знакомства с покупателем, но не устраняет их необходимость. Сколько действий или времени достаточно для перехода к персональному профилю, автор не уточняет.
Доклад · 00:25:28Сезонность и появление новых долгосрочных интересов
Вопрос о сезонной рыбалке возвращает к решению сохранить даты при сжатии. История нужна не только для ответа «интересовался ли человек этим вообще», но и для понимания, когда интерес был актуален. Автор говорит, что даты позволяют отслеживать сезонность и периоды релевантности конкретных увлечений.
На вопрос о новых категориях он поясняет, что история не заморожена. Покупатель продолжает взаимодействовать с товарами, и новое направление со временем начинает отражаться в профиле. Именно долгосрочные интересы подхватывают его позже — когда события повторяются и интерес становится устойчивым. Раньше товар может появиться благодаря другим источникам, в том числе через популярность у других людей.
Здесь раскрыта логика изменений, но не расписание обновления. Автор не называет частоту пересчёта профиля, пороги устойчивости или правило удаления остывшего интереса. Ответ о новых действиях также не описывает, как расширяется сам фиксированный набор допустимых интересов. Обновление истории и развитие этого набора — разные вопросы.
Доклад · 00:26:03Почему долгосрочные интересы остаются одной из частей ленты
Автор различает несколько задач источников: показать то, чем пользователь уже интересовался, предложить то, чего в его истории ещё не было, и вернуться к долгосрочному увлечению, которое не проявлялось недавно. У разных источников могут быть небольшие доли в общей ленте.
Это продолжает исходную архитектуру с параллельными ветвями. Долгосрочный профиль не должен единолично объяснять каждый показ: другие источники помогают и новым пользователям, и знакомству с новыми товарами. На отдельный вопрос о точном количестве источников автор число не сообщает. Полного перечня алгоритмов и устройства их объединения в записи нет.
Доклад · 00:27:30Другие сервисы Яндекса и цифровые двойники пока не используются
Один из вопросов предлагает обогатить портрет данными других сервисов Яндекса: например, связать музыкальные предпочтения с одеждой. Ответ автора — на момент доклада такие данные не используются. Значит, нельзя объяснять продемонстрированные интересы уже работающим объединением активности человека во всей экосистеме.
Аналогичный ответ дан на вопрос о цифровом двойнике пользователя для тестирования рекомендаций: на тот момент такого решения нет. Фраза о будущих новостях не задаёт ни сроков, ни подтверждённого плана внедрения. В описанную систему не следует добавлять симуляцию пользователей или межсервисный профиль как достигнутые возможности.
Доклад · 00:26:41Семейный аккаунт: интересы аккаунта, а не разделение людей
Покупки в одном аккаунте не обязательно принадлежат одному человеку. Пользователь может приобретать вещи для себя, делать подарки или пользоваться аккаунтом вместе с семьёй. Автор предлагает рассматривать такую историю как интересы аккаунта: описанная система не разделяет её на кластеры отдельных людей.
При этом более подробная история, по его словам, может помочь понять контекст покупок. В примере с игрушечными наборами возникает вопрос, покупают ли их себе или детям; в других случаях речь может идти о покупках супруги или подарках ей. LLM предлагается использовать для рассуждения о таких связях, а не только о названиях категорий.
Это возможность предположить контекст, а не показанный механизм надёжного разделения семьи на персональные профили. В докладе нет оценки качества различения покупки себе и подарка. Группировка событий по датам, действиям и категориям при сжатии также не означает, что система установила, кто именно из членов семьи совершил каждую покупку.
Доклад · 00:29:31Как предлагать следующий шаг, а не замыкаться в прошлом
Последний содержательный вопрос касается ограничения самой персонализации: если система всё время воспроизводит текущий портрет, она может не помогать человеку открывать новое. Автор возвращается к сценарию расширения интереса. Даже для уже понятного увлечения можно предложить не только точное продолжение прошлых покупок.
В примере с пробежками небольшую долю ленты можно занять товарами, которые связаны с этим интересом менее напрямую и соответствуют его возможному следующему шагу. Если предложение не подошло, можно попробовать близкое направление, но немного в другую сторону. Так речь идёт не о случайном выходе за пределы профиля, а о развитии уже обнаруженной связи.
Автор объясняет принцип такого подмешивания, но не задаёт конкретную долю, алгоритм выбора следующего направления или критерий неудачной попытки. Поэтому это содержательная часть описанного сценария рекомендаций, а не ещё один отдельно измеренный результат. Долгосрочные интересы должны помогать понимать пользователя, не превращаясь в неизменный список разрешённых ему увлечений.
Доклад · 00:30:25Итог: более содержательный профиль внутри существующей системы
В Маркете LLM меняет не всю рекомендательную систему, а способ описать долгосрочные интересы покупателя. Вместо одного перечня предпочтительных категорий появляется более содержательный профиль, связанный с увлечениями. Его ценность раскрывается через две сохранённые части: профиль пользователя и генераторы конкретных товаров.
- 01
История действий
Система собирает взаимодействия аккаунта за всё время активности на маркетплейсе, сохраняя сведения о действиях, категориях и датах.
- 02
Сокращённый контекст
Эвристики группируют события и даты, оставляют сильные сигналы и бережнее сокращают любимые категории, чтобы история помещалась в окно модели.
- 03
Фиксированные интересы
YandexGPT получает подготовленную историю и промпт. JSON-схема и ограничение декодирования направляют ответ в допустимый набор интересов.
- 04
Профиль и товарные группы
Интересы сохраняются в прежнем профиле. LLM определяет для них наборы категорий и параметров, связывающие увлечения с каталогом.
- 05
Кандидаты и лента
Существующие генераторы выбирают товары из заданных групп. Источник долгосрочных интересов работает рядом с другими источниками рекомендаций.
Подготовка модели — отдельный вопрос: автор называет выбранную LLM и адаптированный промпт, но не раскрывает процедуру дообучения.
Оценка отделена от выдачи: сжатие проверяется по своим показателям, а продуктовый результат — по атрибутированным заказам, покрытию категорий и слепому сравнению.
Для Маркета сообщаются +2,5% атрибутированных заказов и ×2,6 категорий, покрытых интересами, в среднем на пользователя; 75% пользователей выбирают новые интересы в слепом сравнении с baseline. Это не метрики TaoBao и не точность профиля. Без истории LLM не решает холодный старт; сезонность требует дат, семейный аккаунт остаётся общим, а частота обновления не раскрыта. Главный результат — способ сделать профиль содержательнее, сохранив рабочий путь от интереса к товару.
Доклад · 00:15:46