Разбор готов
Яндекс Маркет: как MarketAI помогает продавцам работать со справкой и аналитикой
Продавцу на Яндекс Маркете приходится разбираться не только с товарами и заказами, но и с показами, услугами, логистикой, географией продаж и акциями. Информация уже есть в личном кабинете и документации, однако найти нужный ответ бывает трудно даже опытному пользователю. MarketAI предлагает другой способ работы: продавец задаёт вопрос в чате, а система выбирает подходящий сценарий и получает сведения из справки или инструментов кабинета. В докладе Владислав Вихров показывает путь от первого справочного помощника до аналитического агента и гибкого диспетчера. Главная инженерная задача здесь — не просто подключить языковую модель, а сделать данные понятными, правильно направить запрос и отличить полезный ответ от правдоподобного, но нерелевантного.
Материал полезен тем, кто знаком с основами языковых моделей и хочет понять устройство помощника внутри действующего продукта. Особенно подробно разобраны подготовка документации, проектирование инструментов над существующим бэкендом, выбор сценария с учётом диалога и оценка качества при ограниченных данных.
Исходный доклад · Открыть оригинал
Почему продавцу нужен помощник в личном кабинете
Личный кабинет продавца объединяет разные стороны работы на маркетплейсе. Здесь нужно следить за показами и продажами, понимать условия услуг, разбираться в логистике и акциях. Наличие всех этих данных в одном продукте ещё не означает, что пользователю легко найти нужное. По наблюдению автора, даже опытные продавцы нанимают персональных менеджеров, чтобы упростить навигацию; для новичков сложность ещё выше.
MarketAI — помощник в чате, который отвечает на вопросы по документации, товарам и продажам. Пользователь формулирует задачу словами, а система выбирает способ получить ответ. Так исходная проблема навигации превращается в инженерную задачу: понять вопрос и связать его с подходящим источником информации.
Общая схема начинается с диспетчера: он получает вопрос продавца и направляет его в один из сценариев. Дальше автор последовательно разбирает справку, агента аналитики, саму маршрутизацию и оценку качества. Такое разделение важно: поиск документа и получение числовых данных из кабинета требуют разных действий, хотя для продавца остаются частями одного разговора.
Доклад · 00:13:09Первый сценарий: ответить по большой и неоднородной справке
Работу начали с документации. Корпус включает справку Яндекс Маркета, правовые документы и инструкцию к API — программному интерфейсу. Это не набор коротких ответов на типовые вопросы, а подробные материалы, которые готовят технические писатели. Они качественные, но различаются по размеру и назначению.
Число документов относится к исходному корпусу, до разбиения на фрагменты. Размер самого длинного документа указан в символах, а общий объём — в токенах используемой модели. Эти единицы нельзя подменять друг другом.
Из-за объёма справки продавцы обращаются в поддержку даже тогда, когда нужная информация уже опубликована. Автор приводит вопросы о компенсациях, услугах и акциях Маркета. Задача помощника — найти основание для ответа внутри этих материалов, а не заменить их свободным рассуждением модели.
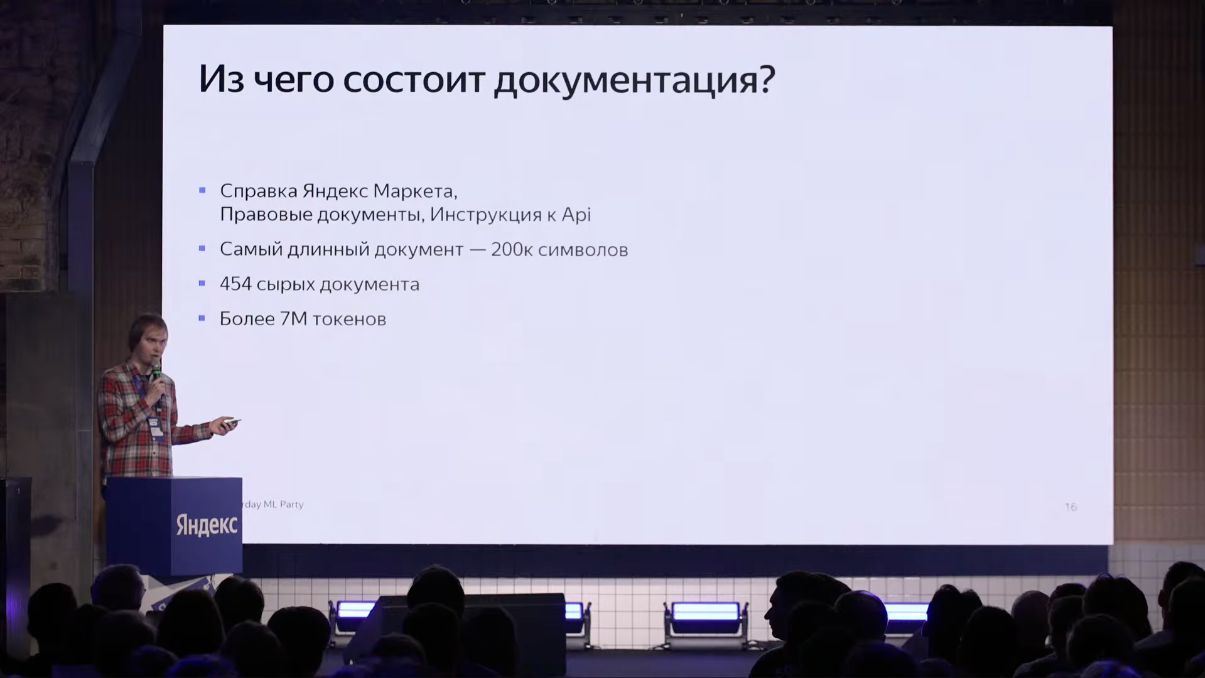
454 исходных документа, более 7 млн токенов; самый длинный документ — около 200 тысяч символов. Источники включают справку, правовые документы и инструкцию к API.
Источник: Владислав Вихров · Яндекс МаркетПочему RAG из коробки оказался недостаточным
Самый прямой подход — передать модели всю справку вместе с вопросом — не подходит из-за объёма. Поэтому сначала ищут подходящие документы, а затем помещают верхнюю часть выдачи в контекст генератора. Такой поиск материалов перед генерацией ответа называется RAG.
Первый вариант RAG уже мог отвечать, но допускал ошибки двух видов: иногда не отвечал на поставленный вопрос, иногда неточно использовал терминологию Маркета. Одного подключения поиска оказалось мало. При этом отдельные неудачные примеры не показывали, насколько хороша система в целом и достаточно ли её качества для запуска.
Дальнейшая работа строилась в определённом порядке. Сначала понадобилась измеримая точка отсчёта. Затем — представление документации, в котором модель реже путается. И только после этого имело смысл улучшать поиск по подготовленным материалам. Так ошибки первого прототипа задали три связанные задачи: оценку, подготовку данных и обучение поисковой модели.
Доклад · 00:15:43Как отделили качество поиска от качества ответа
Реальных обращений на старте было недостаточно для обучения, но хватало, чтобы понять распределение вопросов по темам. Вместе с поддержкой и аналитиками команда собрала эталонный набор — golden set. Вопросы в нём имитировали обращения продавцов, а для каждого фиксировали документ, который следует использовать при ответе. В устном описании автор называет 500 пар «вопрос — документ».
На этом наборе зафиксировали качество исходного решения. Поисковый компонент оценивают через Top-k accuracy: удалось ли найти нужный документ среди первых k результатов. Это проверка выбора материала для ответа, а не того, что генератор правильно объяснил его продавцу.
Для ответа всей системы используют coverage. В определении автора учитывается либо хороший ответ, либо корректное сообщение о том, что ответить невозможно. Следовательно, успешный исход не обязательно содержит искомую информацию: обоснованный отказ тоже входит в эту оценку. Долю содержательных ответов и долю отказов доклад отдельно не приводит.
Такое разделение позволяет не смешивать два разных вопроса: нашла ли система нужное основание и как она повела себя с доступными материалами. Подробности проверки обоснованности отказа автор позднее уточняет в ответах на вопросы.
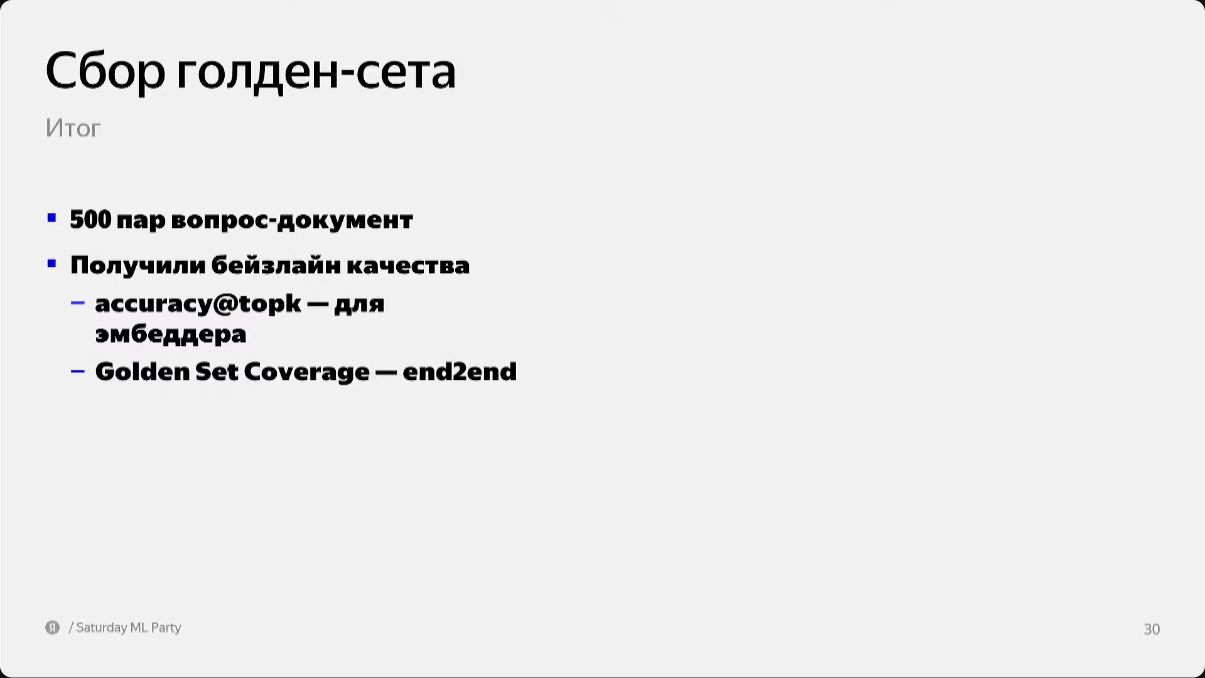
500 пар «вопрос — документ». Accuracy@top-k оценивает эмбеддер; Golden Set Coverage — ответ системы целиком.
Источник: Владислав Вихров · Яндекс МаркетКак готовят документы и поддерживают индекс
В исходной документации есть не только полезный текст, но и метаданные, элементы для отображения на сайте и таблицы. Если просто передать всё это модели, ей придётся одновременно разбираться в содержании и восстанавливать смысл технической разметки. Поэтому индекс хранит подготовленное представление документов и заранее вычисленные векторы — эмбеддинги, которые используются при поиске.
Сначала из документа удаляют лишнюю информацию, прежде всего служебные метаданные. Затем преобразуют полезные элементы, на которых модель ошибается. В частности, таблицы в Markdown перекладывают в JSON. На слайде одна строка таблицы превращается в объект с явными ключами: родительская категория, категория и названия тарифов. Так значение сохраняет связь с названием своей колонки, а не остаётся рядом с другими числами в строке разметки.
После очистки документ разбивают на фрагменты. Для этого используют уже существующие смысловые границы и абзацы, подготовленные для читателя. Команда не начинает с произвольного одинакового размера каждого фрагмента: структура самих документов даёт опору для разбиения.
Индекс обновляют ежедневно, поскольку в справке появляются изменения. По словам автора, такой частоты достаточно для их задачи. Это обновление доступных материалов и их поискового представления, а не ежедневное обучение модели заново.
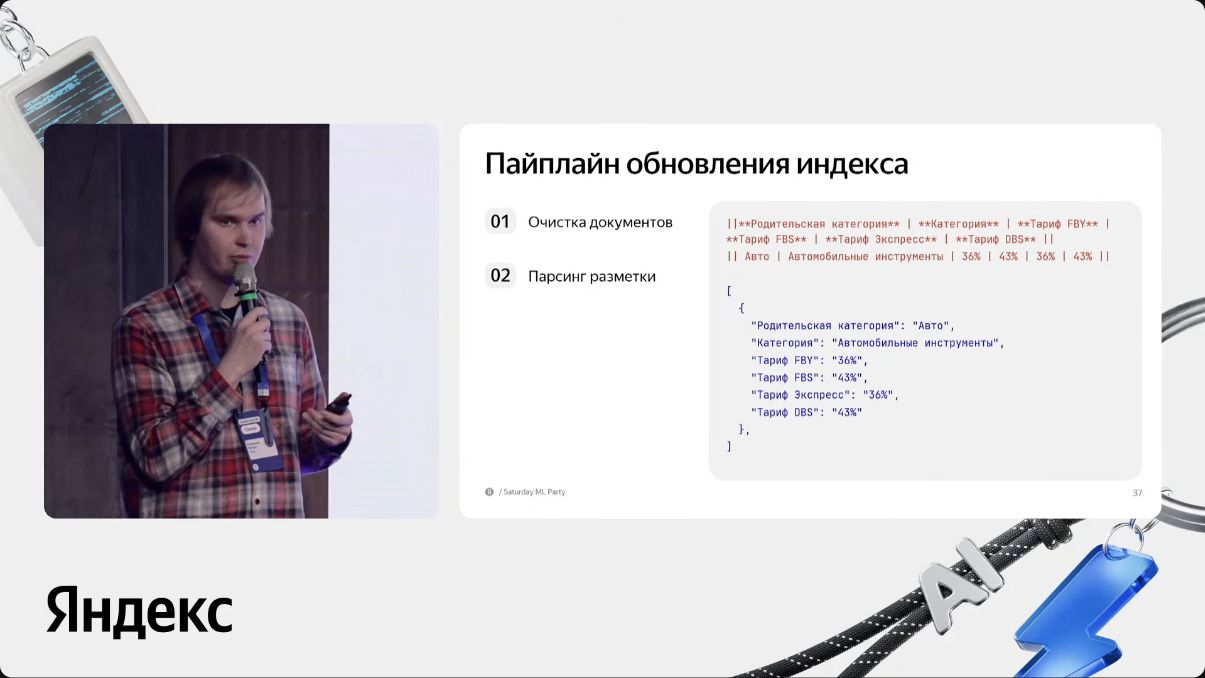
Слайд обновления индекса: служебная разметка очищается, таблица переводится в JSON с явными названиями колонок.
Источник: Владислав Вихров · Яндекс МаркетКак получили разнообразные вопросы для обучения поиска
Когда документация подготовлена, следующий вопрос — на чём обучать собственную поисковую модель. Команда использует сами статьи справки как основу для генерации обучающих вопросов. Чтобы вопросы не сводились к одной общей теме документа, из него выбирают случайную подстроку и просят языковую модель задать вопрос к ней.
У случайного фрагмента есть недостаток: вне документа он теряет часть смысла. Поэтому генератор получает не только выбранную подстроку, но и полный текст статьи. Дополнительно передают путь, по которому статья расположена в справке. Он помогает понять, к какому разделу относится материал и в каком контексте следует его читать.
Ещё одна часть запроса к модели — несколько примеров обращений в стиле продавцов. Такие примеры в промпте называются few-shot. Полный документ и его путь поддерживают осмысленность вопроса, а примеры показывают, как пользователь может его сформулировать. Это разные функции входных данных, а не взаимозаменяемые способы увеличить контекст.
Полученные вопросы используют для обучения эмбеддера — модели, строящей векторные представления для поиска. Объём синтетического набора и подробный рецепт обучения в докладе не раскрыты; описана прежде всего логика получения подходящих вопросов.
Доклад · 00:19:01Что показал поиск и с чем запустили справочный MVP
После обучения эмбеддера команда получила следующие значения Top-k accuracy. Таблица показывает качество извлечения нужного документа при разной глубине выдачи; это не точность конечных ответов.
В генератор передают переменное число найденных документов. Оно зависит от их размера и доступного объёма контекста; автор описывает обычный порядок величины как несколько десятков. Поэтому строка Top-50 не означает, что каждый запрос всегда обрабатывается с ровно пятьюдесятью документами.
Для связки этого эмбеддера и генеративной модели в выступлении названо 95% golden set coverage. Смысл показателя остаётся прежним: хороший ответ либо обоснованное сообщение, что ответить нельзя. Он не означает, что система содержательно решила 95% всех обращений продавцов. Его также нельзя напрямую сопоставлять с 0.80 для Top-50: метрики проверяют разные этапы и по-разному учитывают отказ.
С этим решением запустили MVP — первую работающую версию справочного помощника. Автор связывает запуск с возможностью уже решать первые проблемы продавцов. Сравнительных чисел для исходного RAG здесь нет, поэтому показанные значения описывают получившееся решение, а не измеренный прирост относительно старого.
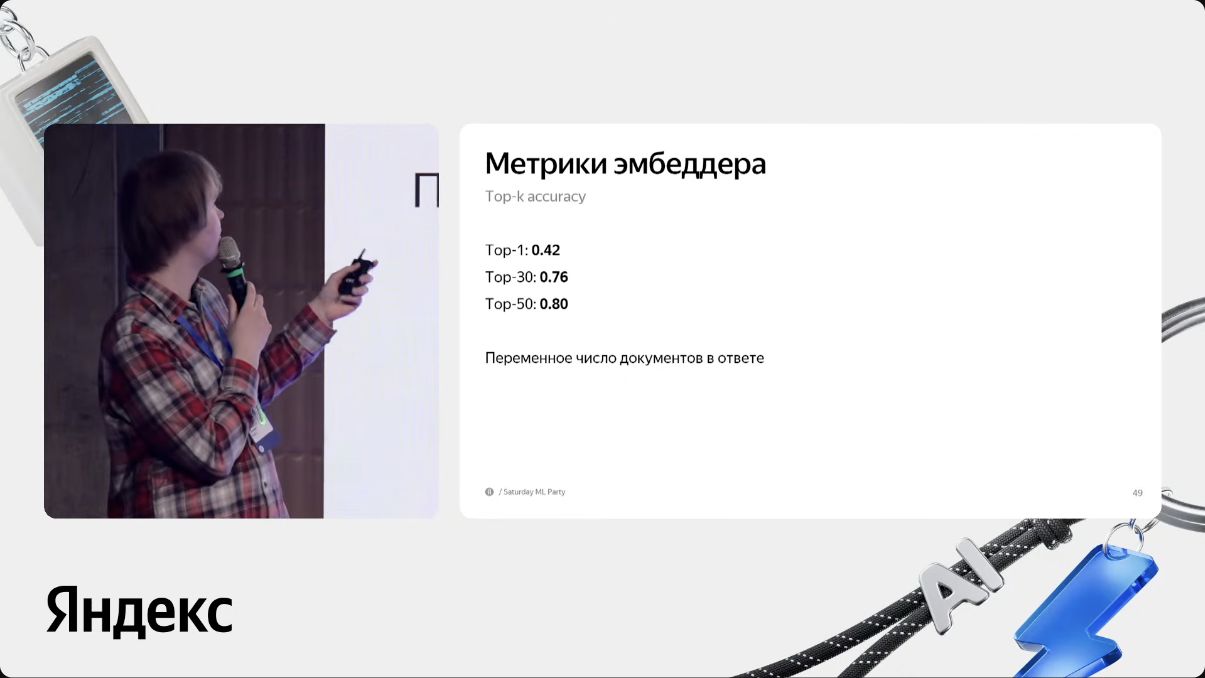
Top-1 — 0,42; Top-30 — 0,76; Top-50 — 0,80. Это качество извлечения документов, не точность конечного ответа.
Источник: Владислав Вихров · Яндекс Маркет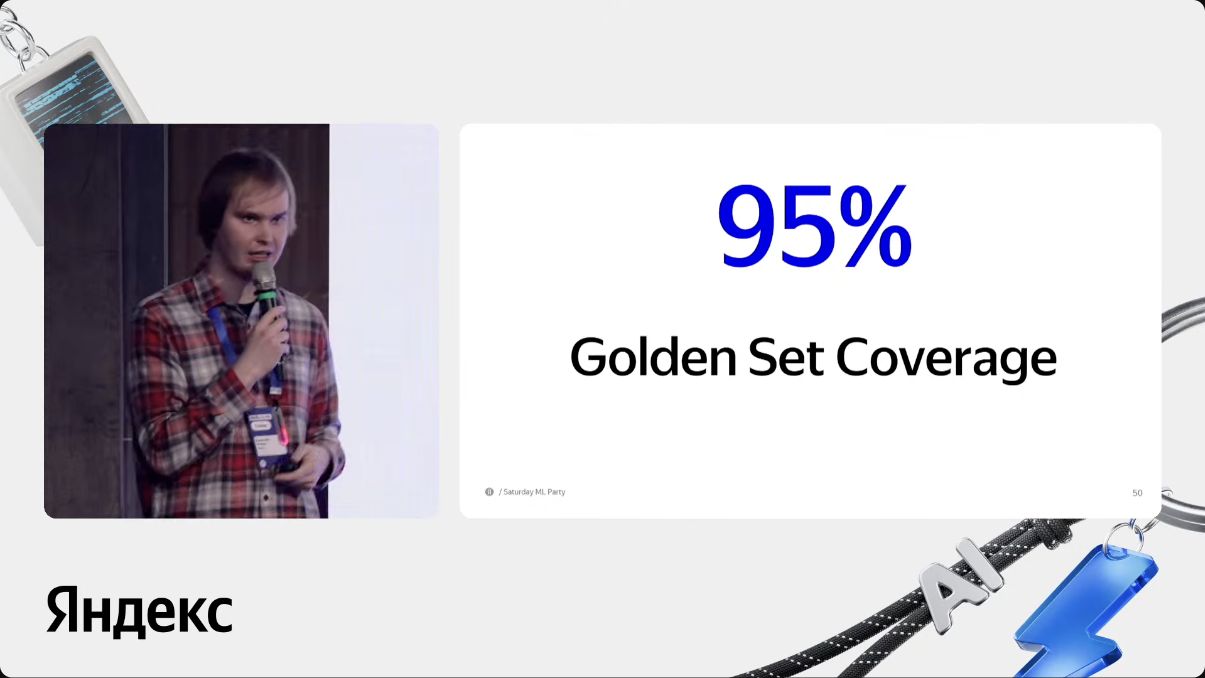
95% на эталонном наборе. По объяснению автора, метрика учитывает хороший ответ и обоснованный отказ; это не доля содержательно решённых обращений на всём трафике.
Источник: Владислав Вихров · Яндекс МаркетАгент аналитики: использовать существующие данные кабинета
Справочный сценарий работает с опубликованными документами. Для ответа о продажах и других показателях нужны данные конкретного продавца. Они уже поступают в партнёрский интерфейс через методы бэкенда, которые возвращают текстовое представление данных. Агент аналитики должен вызывать инструменты над этими методами и формировать ответ на основании результатов.
Но существующий программный интерфейс не обязательно удобен языковой модели. Его писали разработчики для разработчиков: в результатах есть служебные поля для фронтенда, а названия и структура могут быть непонятны без знания продукта. Поэтому возможность вызвать метод сама по себе ещё не решает задачу.
Команда адаптирует инструменты и их ответы до передачи модели. В докладе последовательно разбираются выбор размера инструмента, понятные названия, ограничение объёма данных, распределение параметров между сервисом и агентом, а также явное указание терминов и единиц. Доступ к данным показан именно через эти инструменты; устройство баз данных и прямые запросы к ним не описываются.
Доклад · 00:20:49Почему инструменты объединяют, переименовывают и ограничивают
Первый принцип — объединять близкую функциональность. В разобранном автором примере четыре блока страницы кабинета соответствуют разным инструментам. У них одинаковые или близкие входные параметры и схожие результаты. Их разумно представить модели одним инструментом, а не заставлять её по очереди собирать сведения несколькими вызовами.
Такое объединение решает сразу несколько локальных проблем: уменьшается число вариантов, из которых выбирает модель, сокращается необходимость последовательных вызовов и освобождается место, занятое описаниями инструментов во входном контексте. Автор не формулирует правило «объединить всё»: основанием служит сходство параметров и возвращаемой информации.
Второй принцип — осмысленное название. Для языковой модели имя функции тоже является текстом, из которого можно понять её назначение. С этим связан выбор идентификаторов: где возможно, используют понятное имя категории вместо числового ID. Такой идентификатор несёт смысл непосредственно в аргументе вызова.
Третий принцип относится к объёму результата. Когда инструмент возвращает слишком много данных, их делят на страницы и запрашивают продолжение по мере необходимости. Дополнительно применяют фильтрацию, чтобы ограничить состав получаемой информации. Это позволяет работать с большим ответом, не пытаясь поместить его целиком в контекст.
Наконец, описание инструмента должно объяснять не только входные параметры. В нём указывают, когда функцию следует использовать и когда она не подходит. Работа над такими инструкциями остаётся отдельной частью разработки: понятная сигнатура не заменяет объяснения назначения.
Доклад · 00:21:59Что выбирает агент, а что передаёт сервис
Не все аргументы одного инструмента должны проходить через модель. На слайде разобран get_merchant_orders_in_category_by_date: метод получает идентификатор бизнеса, категорию и границы периода. Хотя технически это параметры одного вызова, источник значений у них разный.
Таблицу можно прокрутить по горизонтали.
business_id не меняется в рамках сессии, поэтому сервис передаёт его напрямую. Категорию и даты, напротив, нужно выбрать по смыслу пользовательского запроса — это работа агента. На схеме эти две ветви сходятся перед вызовом orders_in_category.
Смысл решения — не просить модель заново создавать значение, которое уже известно сервису. На слайде этот принцип сопровождается фразой «Промпт не дает гарантий». Показана конкретная граница ответственности за аргументы; отдельный механизм проверки прав и полномочия на изменение данных в этом примере не раскрываются.
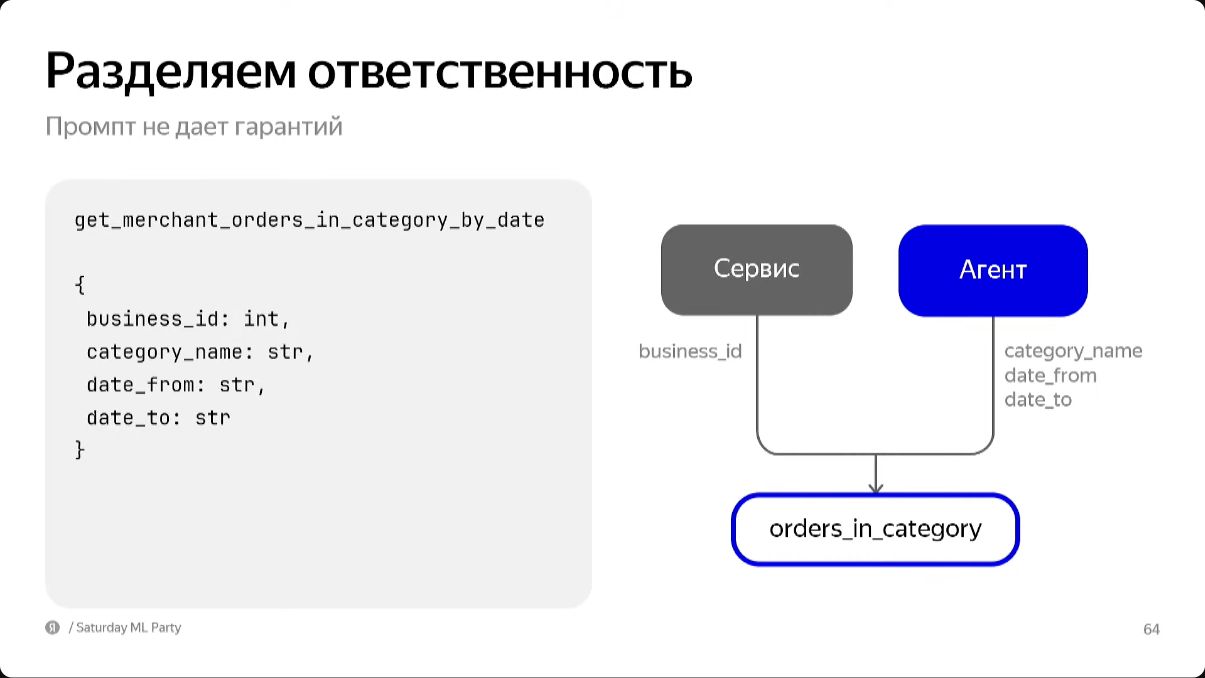
business_id передаёт сервис; агент выбирает category_name, date_from и date_to. Промпт не заменяет контроль границ доступа.
Источник: Владислав Вихров · Яндекс МаркетПочему термин и единица должны приходить вместе с числом
Даже успешно вызванный инструмент может вернуть неудобный ответ. В примере на слайде поле revenue имеет значение 100500. Что это означает для продавца: выручка, прибыль или доход? И в каких единицах дано число — в рублях, долларах или чём-то ещё? На Маркете принята определённая терминология, которой пользователи уже привыкли пользоваться.
Поэтому перед передачей результата модели ключ приводят к нужному термину и добавляют единицу измерения: вместо «revenue: 100500» получается «Выручка, руб.: 100500». Число не изменяется; меняется его однозначность для дальнейшего ответа. Это пример формата данных, а не финансовый результат использования помощника.
Автор предпочитает такое преобразование отдельному правилу в промпте. Вместо того чтобы каждый раз надеяться на правильный перевод и восстановление единицы, сервис передаёт уже подписанный показатель. Так из работы модели убирают одну конкретную возможность ошибиться.
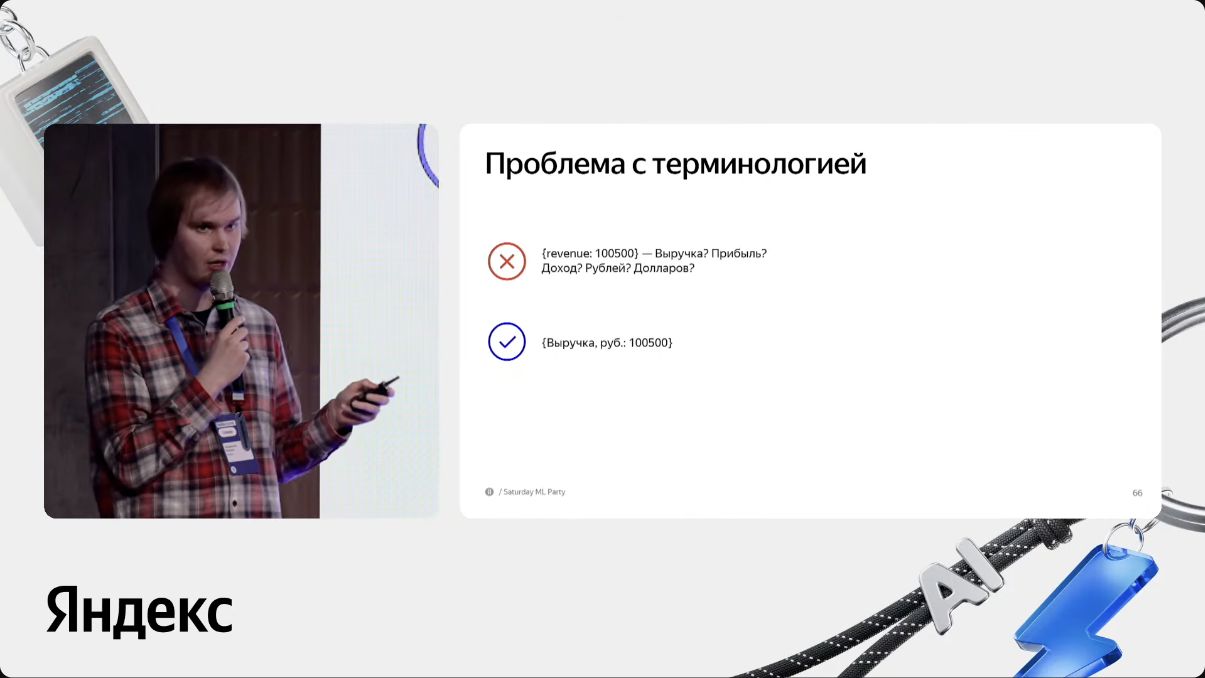
Вместо неоднозначного revenue модель получает «Выручка, руб.». Число 100500 на слайде — учебный пример формата, не финансовый результат.
Источник: Владислав Вихров · Яндекс МаркетЗачем аналитический сценарий запустили до полного покрытия кабинета
После реализации первых инструментов команда запустила пилот аналитики. Он покрывал далеко не весь партнёрский интерфейс. Тем не менее запуск позволил продавцам получать начальную пользу, а разработчикам — увидеть реальные способы обращения к помощнику.
Один из таких примеров — сообщение, состоящее только из цифр. Аналитики помогли понять, что продавец прислал идентификатор заказа. Пользователь не объяснил, что это за номер и что с ним сделать: он ожидал, что чат поймёт привычный для него рабочий контекст. Автор описывает обработку таких обращений как задачу, которой систему ещё нужно научить.
Другой показанный запрос относится к функциональности, которой в пилоте ещё нет. Он важен как сигнал спроса: реальные сообщения показывают, каких сведений продавцам недостаёт. По ним команда может выбирать, что подключать дальше, не принимая первоначальный набор инструментов за полный список пользовательских задач.
Появление работающих примеров также делает содержательнее экспертные сессии с продавцами. Они могут обсуждать уже опробованный продукт: что понравилось, что мешает и какие возможности хотелось бы получить. Пилот здесь одновременно проверяет полезность и помогает уточнить следующий этап разработки.
Доклад · 00:25:18Первый диспетчер: выбрать сценарий с учётом разговора
Появление аналитического сценария потребовало выбирать, куда отправить вопрос. На схеме диспетчера показаны пять направлений: документация, аналитика, генерация описаний, «Просто поболтать» и «Позвать оператора». Генерация описаний появилась позже первых двух сценариев; её внутреннее устройство автор отдельно не разбирает.
Первый диспетчер обучали как классификатор намерений на синтетических данных, полученных похожим способом, что и вопросы для справки. Экспериментировали с разной длиной контекста. Важность истории видна на последовательности обращений: вопрос о сборке заказа относится к справке, просьба проанализировать продажи — к аналитике, а следующий вопрос можно понять правильно только с учётом предыдущего разговора о продажах.
Таблицу можно прокрутить по горизонтали.
Precision характеризует точность назначения данного сценария, а Recall — полноту обнаружения относящихся к нему запросов. В показанном результате для справки полнота выше, чем для аналитики, но точность ниже. Команда сочла качество достаточным и запустила этот вариант в рабочем продукте.
Таблица относится именно к первому обученному классификатору. Позже его заменили другим способом маршрутизации, поэтому переносить эти четыре значения на последующий LLM-диспетчер нельзя.
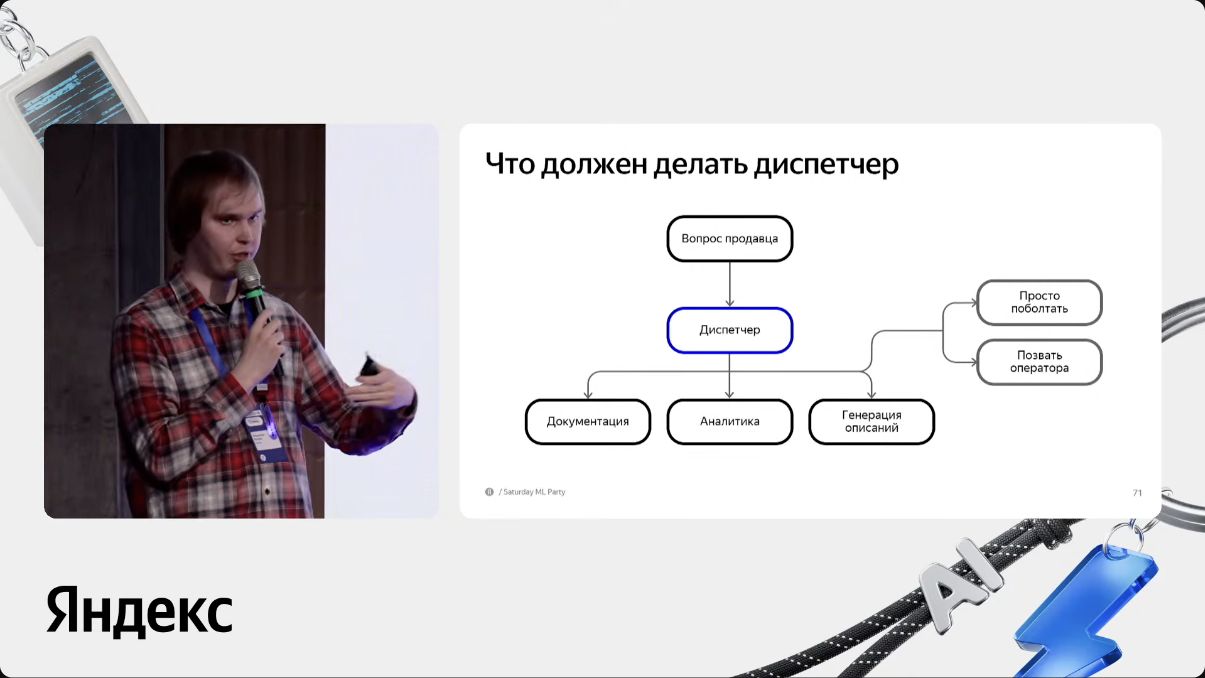
Вопрос направляется в документацию, аналитику, генерацию описаний, разговорный сценарий или к оператору.
Источник: Владислав Вихров · Яндекс Маркет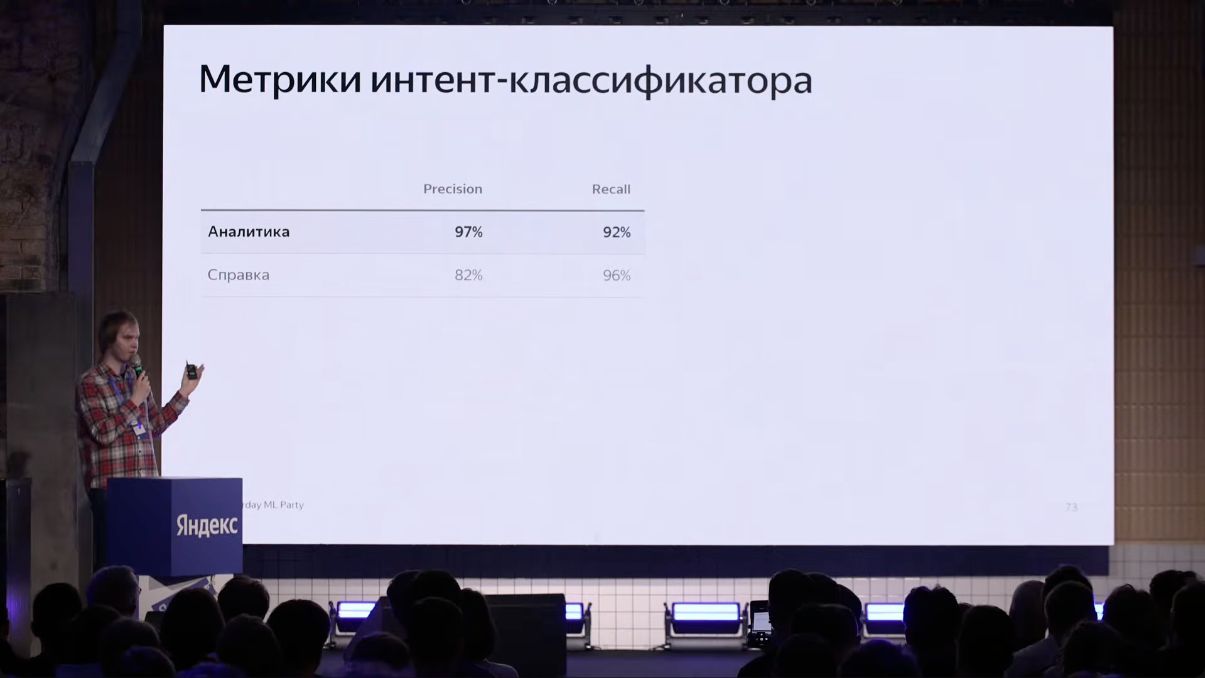
Для аналитики Precision 97% и Recall 92%; для справки — 82% и 96%. Эти результаты относятся к показанному интент-классификатору.
Источник: Владислав Вихров · Яндекс МаркетПочему маршрутизацию передали небольшой языковой модели
После запуска продукт продолжил меняться. Команда добавляла и отключала сценарии, включала отдельные возможности внутри них, проверяла гипотезы и возвращалась к доработке. Диспетчер должен был учитывать не только название сценария, но и то, что система умеет делать в текущей конфигурации. Переобучать классификатор под каждую комбинацию становилось неудобно.
Для большей гибкости использовали небольшую языковую модель с ограниченным форматом ответа — structured output. Автор описывает ограничение набора токенов, которые модель может сгенерировать, чтобы результат имел заданный формат. В данном случае выход — имя агента, которому нужно передать вопрос.
В сравнении с первым диспетчером качество, по словам автора, оказалось близким: в отдельных случаях немного выше или ниже, а в целом статистически неотличимым. Полная таблица нового варианта и процедура проверки статистической значимости в докладе не приведены. Главным выигрышем стала возможность гибче экспериментировать со сценариями.
За эту гибкость заплатили скоростью маршрутизации. Однако замеры команды показали, что основное время ответа уходит на генерацию, а не на диспетчер. Поэтому более медленный выбор сценария оказался допустим для их продукта. Автор оставляет в силе оба подхода: обученный классификатор и LLM имеют разные преимущества в зависимости от важности скорости и частоты изменений.
Ограниченный формат решает задачу формы результата, но не устраняет семантические ошибки выбора. Диспетчер всё ещё может направить правильно оформленный запрос не в тот сценарий — к этой проблеме обсуждение возвращается в конце вопросов и ответов.
Доклад · 00:27:26Правильная цифра может оказаться неправильным ответом
Основой оценки качества служит экспертная разметка сотрудников поддержки Яндекс Маркета. Но даже профессиональный разметчик может принять фактически корректный ответ за полезный, не заметив, что система ответила на другой вопрос.
На слайде продавец спрашивает: «Сколько у меня доставок в декабре?» Помощник отвечает про заказанные товары, хотя требуется показатель по доставленным. Оба числа могут быть верными для своих показателей, но взаимозаменяемыми от этого не становятся.
Таблицу можно прокрутить по горизонтали.
Слайд сравнивает денежные суммы: 20 млн и 19 млн рублей. Это не количество доставок и не число единиц товара. Существенная ошибка примера — подмена доставленного заказанным. При оценке нужно проверять не только соответствие числа данным, но и соответствие выбранного показателя смыслу запроса.
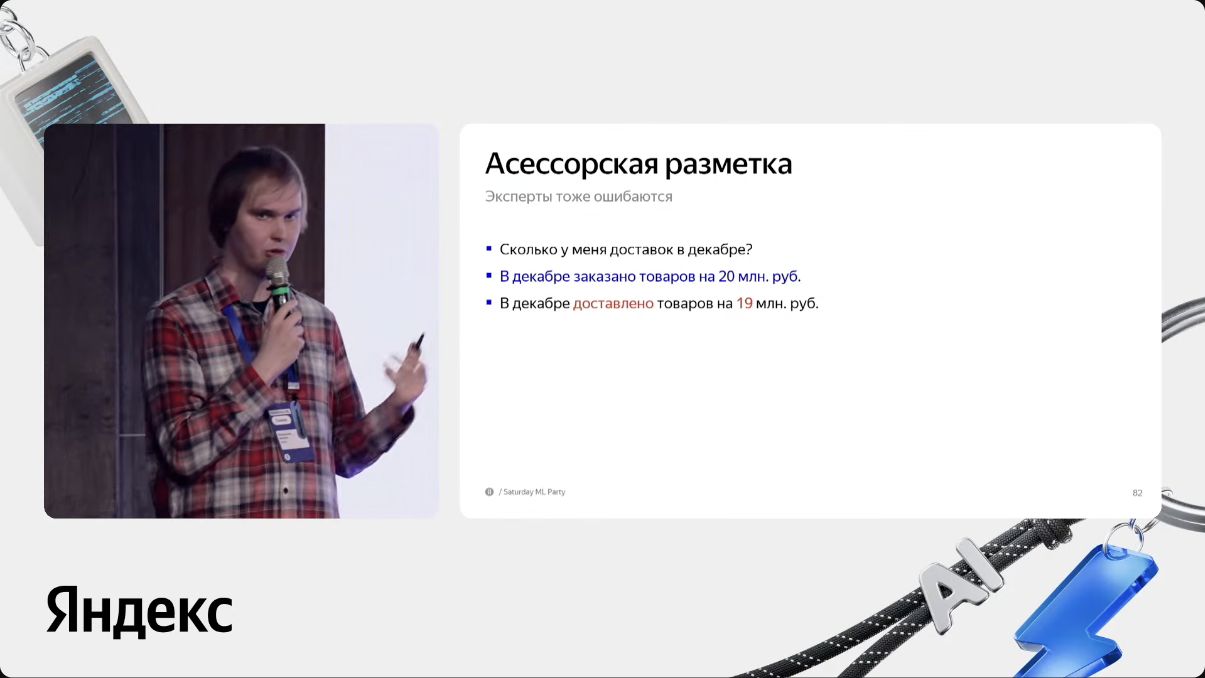
Продавец спрашивает о доставках в декабре. Сумма заказов 20 млн рублей не заменяет сумму доставленных товаров 19 млн рублей.
Источник: Владислав Вихров · Яндекс МаркетКак проверяют самих разметчиков и собирают итоговую оценку
Первое условие доверия к разметке — перекрытие: один и тот же вопрос оценивают несколько экспертов. Тогда единичная ошибка человека не определяет результат целиком. Само наличие экспертов не снимает потребности проверять, насколько согласованно они применяют критерии.
Для оценки согласия используют коэффициент AC1. Автор описывает его через различие между наблюдаемым и ожидаемым согласием. Сильное расхождение оценок рассматривают прежде всего как повод проверить формулировки критериев, а не как доказательство плохой работы разметчиков.
В одном из случаев команда действительно обнаружила ошибку в формулировке критерия. После исправления выросли и согласие экспертов, и качество разметки. Численных значений до и после автор не приводит; важна сама обратная связь от расхождений к инструкции.
Итоговые метки получают алгоритмом Давида–Скина (Dawid–Skene). В объяснении доклада он взвешивает голоса разметчиков вместо простого выбора большинства. Перекрытие даёт несколько оценок одного объекта, AC1 помогает увидеть несогласие, а агрегация превращает оценки в итоговую метку. Это три разные задачи.
Даже после этих мер остаётся ограничение: экспертная оценка занимает много времени и стоит дорого. Поэтому следующий шаг касается не отказа от людей, а более разумного использования их работы.
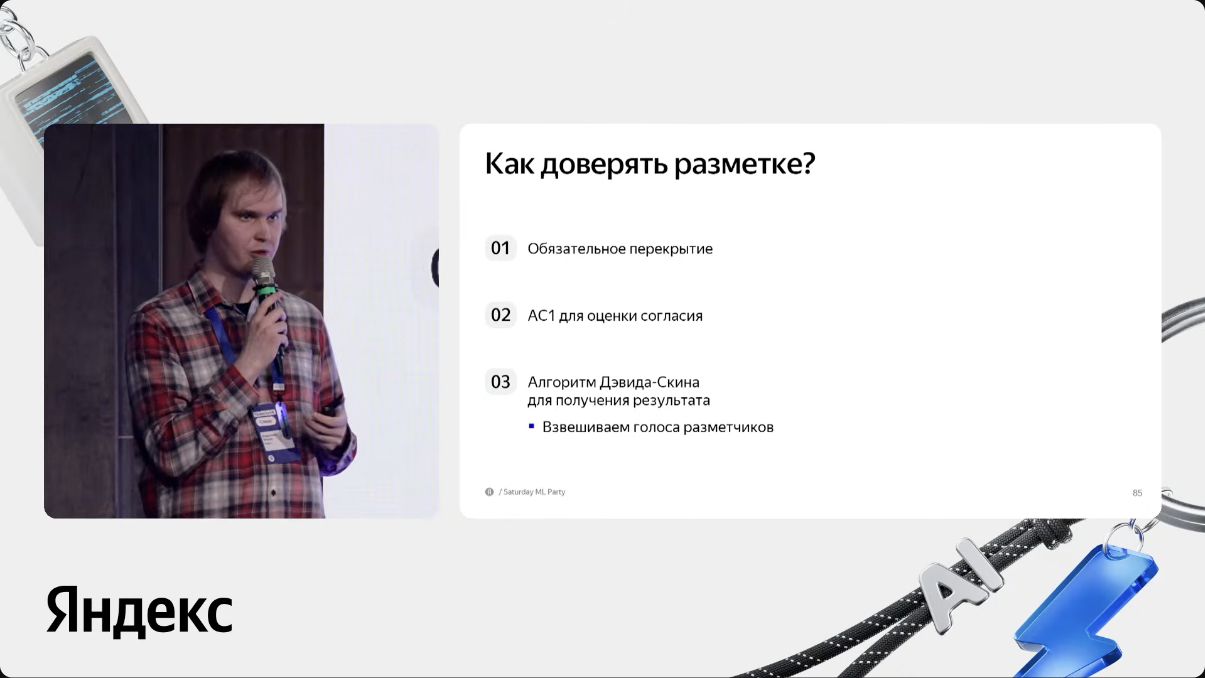
Перекрывающаяся разметка, AC1 для оценки согласия и алгоритм Давида–Скина для взвешивания голосов разметчиков.
Источник: Владислав Вихров · Яндекс МаркетАвтоматические проверки как предварительный отбор гипотез
Команда работает над автоматическими метриками для разных сценариев. Для справки уже есть опорный документ, который должен использоваться при ответе. Для аналитики на момент доклада ещё собирают эталонный набор инструментов, необходимых для решения вопроса.
Такой набор позволит проверять, выбрал ли агент подходящие способы получить данные. Но правильный выбор инструмента ещё не равен хорошему ответу: остаются интерпретация результата и соответствие вопросу. В докладе автоматические проверки поэтому прямо противопоставлены идее полной замены экспертной оценки.
Предполагаемый порядок работы — быстро проверять гипотезы автоматическими метриками и отправлять наиболее успешные варианты на более тщательную разметку. Это процесс разработки и сравнения версий, а не описанный обязательный проверяющий агент на пути каждого пользовательского запроса.
Доклад · 00:30:50Что уже запустили и что ещё проверяют
К моменту рассказа справочный MVP и пилот аналитики уже были запущены. Дальнейшее развитие автор связывает с расширением аналитических и контентных сценариев: подключением большего числа данных кабинета и новых возможностей генерации. Полное покрытие партнёрского интерфейса не заявляется.
Отдельный уже проведённый эксперимент — изменить справочный сценарий. Вместо заранее заданной последовательности поиска и генерации попробовали агента, который при необходимости сам запрашивает дополнительные документы. По словам автора, качество немного выросло, но время ответа увеличилось сильно. Команда продолжает эксперименты с ускорением; точные величины этого компромисса не приводятся.
Ещё одно направление сформулировано как намерение: научить агента аналитики обращаться к документационному сценарию, чтобы точнее отвечать на вопросы. Это не описание уже действующего обязательного обмена данными между агентами.
Разница между этими стадиями существенна. Рабочий справочный поиск, пилот аналитики, эксперимент с дополнительным поиском и будущие межагентные обращения решают связанные задачи, но находятся на разных этапах внедрения.
Доклад · 00:20:39Вопросы и ответы: вход диспетчера, модели и подготовка данных
На вопрос о входе оркестратора автор отвечает, что специальной дополнительной информации у него нет: используются сам вопрос, контекст разговора и сведения о доступных сценариях. Он также подтверждает, что в текущем решении эту функцию выполняет LLM. Диспетчер не получает какой-то отдельно описанный скрытый источник знаний о намерении продавца.
На разных этапах системы применяются модели разного размера. Для генерации итогового ответа автор в устном ответе называет модели более чем со 100 млрд параметров. Это характеристика генерации, а не размер небольшого диспетчера. Конкретные названия и архитектуры моделей не раскрываются.
Вопрос об оптимальном размере фрагмента документа возвращает к смысловому разбиению. Команда использовала уже имевшиеся логические блоки: структура, понятная человеку, подошла и модели. Результатов перебора размеров или отдельного численного оптимума автор не сообщает.
Вопрос о покупающем агенте автор относит к коллегам, которые делают продукт для покупателей, и говорит, что такой продукт существует. Его устройство и возможности в этом выступлении не разбираются. На вопрос об автоматической транскрибации звонков в поддержку ответ относится к своей команде: такой обработкой она не занимается.
Похожесть синтетических вопросов на реальные проверяют через тематику и возможность ответить по справке. Распределение по темам задаёт сама команда; дополнительно смотрят, получается ли у модели дать ответ с использованием документации. Отдельной численной оценки реалистичности или подробного протокола фильтрации синтетики в ответе нет.
Доклад · 00:33:03Вопросы и ответы: взаимодействие агентов, оператор и проверяющая модель
На вопрос о сложном запросе, требующем нескольких агентов, автор снова обозначает границу: взаимодействие между ними пока остаётся пространством экспериментов. Рассматриваемая схема состоит в том, что один агент вызывает другого как инструмент, передаёт входные данные, ждёт завершения и затем работает с его текстовым ответом. Это замысел взаимодействия, а не подтверждение общей уже запущенной системы обмена результатами.
Маршрут к человеку, напротив, уже существует: это сценарий «Позвать оператора». Его используют прежде всего там, где помощник пока не умеет отвечать, а также по прямой просьбе пользователя. Продавца не заставляют продолжать разговор с роботом, когда он хочет оператора. Автор не описывает этот маршрут как универсальную автоматическую проверку опасности или сложности любого вопроса.
Текущий LLM-диспетчер работает без дообучения. Дообученный вариант пробовали, но заметной пользы команда не увидела. Это уточнение относится к новой языковой модели для маршрутизации и не отменяет обучение первого интент-классификатора на синтетике.
Для проверки ответов пробовали использовать другую языковую модель в роли судьи. Однако основным ориентиром осталась экспертная разметка. Проблема особенно заметна в числовой аналитике: проверяющая модель получает те же данные, которые запросил исходный агент, и не имеет независимой картины показателей кабинета.
Поэтому такой проверяющий может столкнуться с тем же ограничением данных, что и отвечающий агент. Сотрудник поддержки способен открыть кабинет и вручную сверить актуальные цифры. Неудача автоматической проверки здесь связана не только с качеством текста модели, но и с тем, на какие сведения она опирается.
Доклад · 00:35:53Вопросы и ответы: скорость, обратная связь и обновления
На вопрос о задержке ответа автор даёт качественную оценку: скорость удовлетворительна для пользовательского опыта, продавцы скорее довольны, но работа над ускорением продолжается. Время в секундах, перцентили и обязательства по уровню сервиса не названы. Это оценка пригодности текущей скорости, а не численное обещание времени ответа.
Обратную связь нельзя свести к длине диалога. В разных сценариях хорошим результатом может быть как короткая, так и длинная сессия. Команда прежде всего смотрит, возвращается ли продавец, продолжает ли использовать те же сценарии и что спрашивает дальше. Характер последующих вопросов помогает понять его отношение к ответам. Единой формулы успешной сессии автор не задаёт.
Эмбеддер итеративно переобучают примерно раз в несколько месяцев. На момент доклада команда работает над регулярным переобучением, а качество проверяет на синтетических вопросах и небольшой выборке реальных. Этот цикл отличается от ежедневного обновления документного индекса: свежесть справки и обновление весов модели поддерживаются разными процессами.
В отдельном уточнении подтверждается, что текущая маршрутизация опирается на few-shot, то есть примеры в промпте, а не на дообучение LLM. Точный набор примеров и промпт диспетчера не приводятся.
Уточняется и смысл перекрытия в оценке: разметчики — люди, несколько экспертов получают один и тот же вопрос. Это нужно для устойчивости к единичным ошибкам и последующего анализа согласия, а не для голосования нескольких автоматических моделей.
Доклад · 00:38:01Вопросы и ответы: что известно о реализации диспетчера
На вопрос о том, почему команда не использует упомянутый участником облачный классификатор, автор отвечает, что не знаком с этим проектом. Технического сравнения решений из этого ответа не следует.
Бенчмаркинг проводят самостоятельно. Конкретный инструмент или платформа в коротком ответе не названы. Аналогично вопрос о семействе LLM не раскрывает состав системы: автор говорит об экспериментах с разными моделями, но отказывается называть детали.
Зато роль диспетчера определена прямо: он не составляет план ответа, а только выбирает, кому передать запрос. За дальнейшую работу отвечает конкретный агент, в обсуждаемом примере — агент аналитики. Поэтому иерархию «диспетчер — сценарий» не следует понимать как центральный планировщик, который сам разбивает задачу на шаги для всех агентов.
Вопрос также затрагивал возможную переработку ответов агентов, но отдельного механизма такого переписывания автор не описывает. Известная функция диспетчера остаётся маршрутизацией.
Доклад · 00:40:16Вопросы и ответы: обоснованный отказ и диспетчер как точка отказа
Обоснованность отказа проверяют разметкой. В автоматическом случае команда знает, попал ли нужный документ в верхнюю часть выдачи. Если его там нет, у генератора не было необходимого материала для ответа. При человеческой оценке к выводу о возможности ответить должны прийти эксперты.
Здесь важно различать два утверждения: нужный документ не попал в контекст генератора и нужного документа вообще нет в справке. Первое не доказывает второе. По описанному способу автоматической проверки видно, почему генератор не мог опереться на материал из своей выдачи, но это не независимое доказательство полноты поиска по всему корпусу. Именно в этих границах следует читать coverage с учётом отказов.
Общую память между агентами на момент доклада не разделяют. В качестве доступного контекста подтверждается переписка и предыдущий диалог. Отдельное межагентное хранилище состояния или обмен внутренней памятью не описаны.
Последний содержательный вопрос касается уязвимости иерархической схемы: если диспетчер ошибся, запрос попадает не туда и дальнейшая обработка может оказаться бесполезной. Автор признаёт диспетчер важной точкой отказа.
Рассматриваемый способ смягчить эту зависимость — позволить одному агенту запросить сведения у другого. По замыслу команды, такая возможность могла бы компенсировать часть ошибок маршрутизации. Но она не исправит всё: например, ошибочное направление к оператору требует улучшать качество самого диспетчера.
Автор считает текущее качество диспетчера хорошим, не называя новых чисел. Выбирая лучший вопрос, он ещё раз выделяет именно эту проблему. Таким образом, расширение возможностей агентов не снимает необходимости отдельно проверять правильность первого решения о маршруте.
Доклад · 00:41:37Итог: понятные данные, выбранный сценарий и проверяемый ответ
MarketAI вырос из задачи помочь продавцу ориентироваться в документации и данных кабинета. Ключевой результат доклада — не универсальный автономный агент, а разделение работы: диспетчер выбирает сценарий, справка ищет материалы, аналитика получает показатели через подготовленные инструменты. В каждом месте команда убирает неоднозначность, которую иначе пришлось бы разрешать модели.
- 01
Вопрос и история
Система получает сообщение продавца. Диспетчеру доступны вопрос, контекст переписки и сведения о текущих сценариях.
- 02
Выбор маршрута
LLM возвращает имя сценария, не составляя общий план. При соответствующем выборе запрос передают оператору; автоматический ответ готовит выбранный сценарий.
- 03
Получение оснований
Справка отбирает документы в пределах контекста. В аналитике агент выбирает инструменты и параметры вопроса, а business_id передаёт сервис.
- 04
Подготовка ответа
Генератор работает с найденными материалами или результатами инструментов, где показатели снабжены названиями и единицами. В справочном сценарии возможен ответ о невозможности помочь.
- 05
Продолжение разговора
Продавец получает ответ в чате. Последующие вопросы интерпретируются с учётом переписки, без описанного общего хранилища памяти между агентами.
Подготовка и оценка происходят отдельно: документацию очищают, таблицы переводят в JSON, индекс обновляют ежедневно; эмбеддер обучают на синтетических вопросах. Проверки поиска, маршрутизации и конечного ответа не заменяют друг друга. Экспертное согласие контролируют через AC1, итоговые метки получают алгоритмом Давида–Скина.
Запуск справочного MVP и пилота аналитики дал работающий продукт и реальные обращения для развития. Межагентные вызовы и расширенная автоматическая оценка остаются направлениями работы. Главный вывод: рост возможностей полезен лишь вместе с понятными основаниями ответа и контролем ошибок маршрутизации.
Доклад · 00:14:05