Разбор готов
Как Сбер оценивает качество множества банковских агентов
В цифровых каналах Сбера один помощник объединяет агентов разных продуктовых команд: они помогают подобрать вклад, разобраться с расходами или оценить возможность ипотечной сделки. Платформе нужно понимать не только то, кому передали запрос, но и удалось ли дальше помочь человеку. При большом потоке диалогов проверять каждое взаимодействие финансовым экспертом слишком дорого, а массовая ручная и модельная разметка оказались недостаточно надёжными. Артём Хусаенов рассказывает, как команда перенесла экспертную работу на кластеры запросов, ответов и диалогов, а персональные финансовые факты выделила в отдельную проверку. Это история о регулярной оценке действующей платформы: как сделать ошибки видимыми, сохранить экспертизу и связать измерения с изменениями продукта.
Материал полезен ML-инженерам, аналитикам и продуктовым командам, которые оценивают помощника с несколькими агентами или инструментами. На банковском примере видно, почему качество роутинга, успешность диалога и точность личных финансовых данных требуют разных проверок, а экспертная разметка может оставаться частью системы без проверки каждого запроса в момент ответа.
Исходный доклад · Открыть оригинал
Один помощник, разные команды и две зоны качества
Платформа Сбера соединяет две стороны. Продуктовая команда приносит агента с определённым навыком — например, подбором вклада. Канал взаимодействия, такой как Сбербанк Онлайн, предоставляет место, где пользователь общается с помощником. В докладе такой канал называется поверхностью. Платформа должна быстро подключать новые навыки и переносить их на разные поверхности, сохраняя общие правила работы.
Общими становятся мониторинг и практики улучшения качества, средства подключения агентов, SDK и пользовательский интерфейс. Поэтому задача шире, чем проверка отдельной языковой модели: изменение одного агента может затронуть выбор инструментов и опыт пользователя в других частях платформы.
Таблицу можно прокрутить по горизонтали.
Эти зоны связаны, но не взаимозаменяемы. Правильный маршрут ещё не означает полезного диалога, а удачная формулировка ответа не доказывает правильность выбранного инструмента. Постоянное масштабирование, мониторинг и рост качества автор рассматривает как совместные задачи платформы.
Доклад · 00:45:35Масштаб потока делает экспертизу ограниченным ресурсом
В постановке задачи автор говорит примерно о миллионе диалогов с помощником в сутки. Позже, обсуждая разметку, он называет миллион запросов в сутки. Это разные единицы: источник не определяет, сколько запросов входит в диалог и как размечены границы сессии. Суточные величины поэтому нельзя автоматически объединять с недельной схемой обработки запросов.
Продукт, по словам докладчика, существует с ноября 2025 года и уже должен поддерживать большой поток взаимодействий. Подробности запуска и период усреднения нагрузки не приведены. Существенно другое: новые агенты и поверхности появляются быстро, а вместе с ними меняется то, что нужно считать правильным поведением.
В сложных финансовых вопросах требуется не просто внимательное чтение, а предметная экспертиза. Проверять ею весь поток по одному случаю не получается: экспертов мало, их подготовка стоит дорого. Команде нужен способ сократить объём повторяющейся работы, не заменяя содержательную проверку поверхностным совпадением слов.
Доклад · 00:49:26Почему массовая ручная разметка не подошла
Первый вариант — привлечь большую группу внешних разметчиков; на слайде указан TagMe. Его преимущество понятно: доступно много исполнителей. Но в банковском домене это не заменяет квалификацию. Инструкции получаются сложными, обучение — долгим, а новые навыки заставляют часто переучивать и заново проверять разметчиков.
Сквозной пример доклада — вопрос, сможет ли пользователь войти в ипотечную сделку на 30 млн рублей к концу 2026 года с учётом потенциальных доходов и задолженностей. Сумма и дата здесь задают пример запроса, а не статистику клиентов. Разметчик может увидеть слово «ипотека» и решить, что запрос должен попасть к ипотечному агенту.
Однако пользователь спрашивает о финансовой возможности сделки: сможет ли накопить первоначальный взнос и поддерживать последующие платежи. Для правильного маршрута нужно понять эту задачу, а не только название продукта. В примере она затрагивает доход, кредитный потенциал и планирование экономии.
Команда пробовала улучшать инструкции и увеличивать перекрытие — давать одни и те же задания нескольким разметчикам. По рассказу автора, этого оказалось недостаточно. При быстром добавлении агентов приходится постоянно обновлять инструкции, проводить обучение и экзамены. Неудача относится к массовой оценке сложного банковского роутинга: она не означает, что человеческая разметка вообще бесполезна.
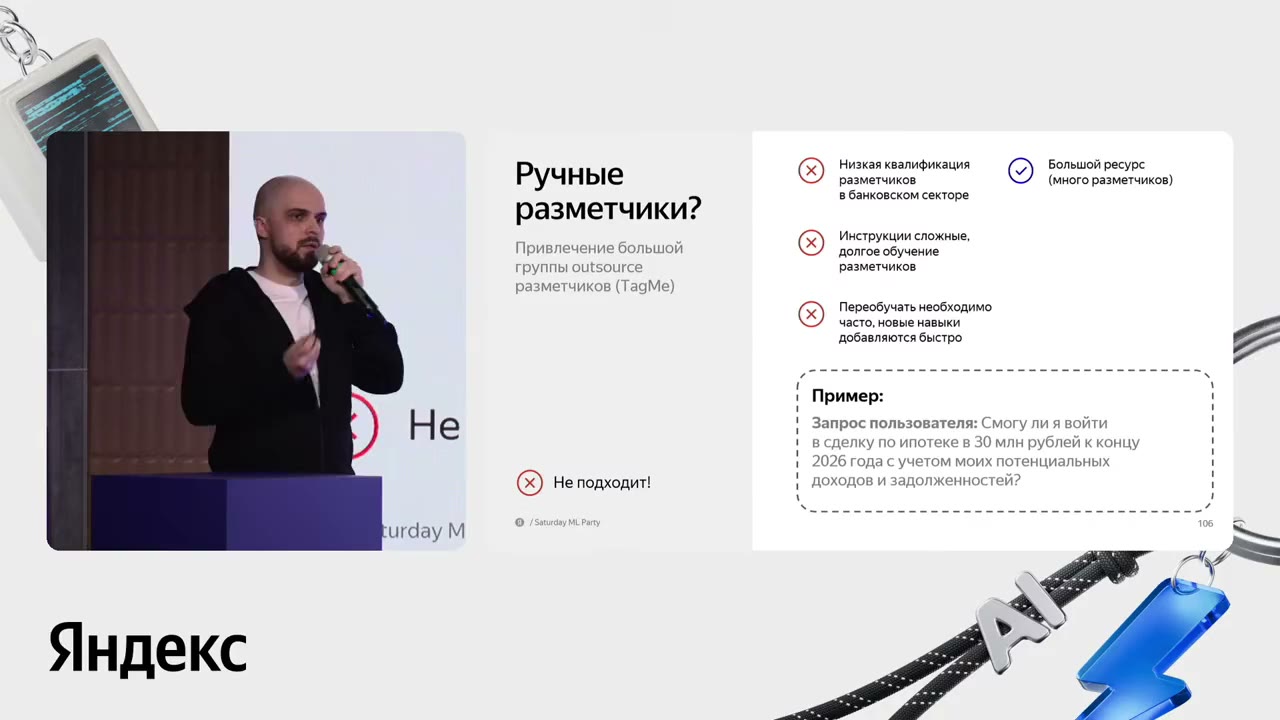
Финансовая экспертиза, длинные инструкции и новые навыки ограничивают массовую ручную разметку.
Источник: Артём Хусаенов · СберПочему LLM as a judge не заменил банковского эксперта
Следующий вариант — поручить языковой модели выставлять оценки по инструкции: LLM as a judge. Такая разметка быстрая и не требует большой команды исполнителей. Модель может понять, что вопрос с упоминанием ипотеки на самом деле касается способности накопить деньги и обслуживать обязательства.
Но в эксперименте команды модельный оценщик столкнулся с длинными инструкциями и галлюцинациями в сложных финансовых вопросах. Часть требований переносили в адаптацию с LoRA, которую затем приходилось повторять по мере появления новых навыков. Масштабирование платформы тем самым увеличивало и сложность сопровождения оценщика.
Таблицу можно прокрутить по горизонтали.
Модель, размер и состав выборки, правило совпадения оценок и доверительные интервалы не раскрыты. Из результата нельзя получить универсальную оценку всех LLM-судей. Дальше в той же системе модельная оценка остаётся допустимым инструментом для отдельных задач — например, проверки тона общения.
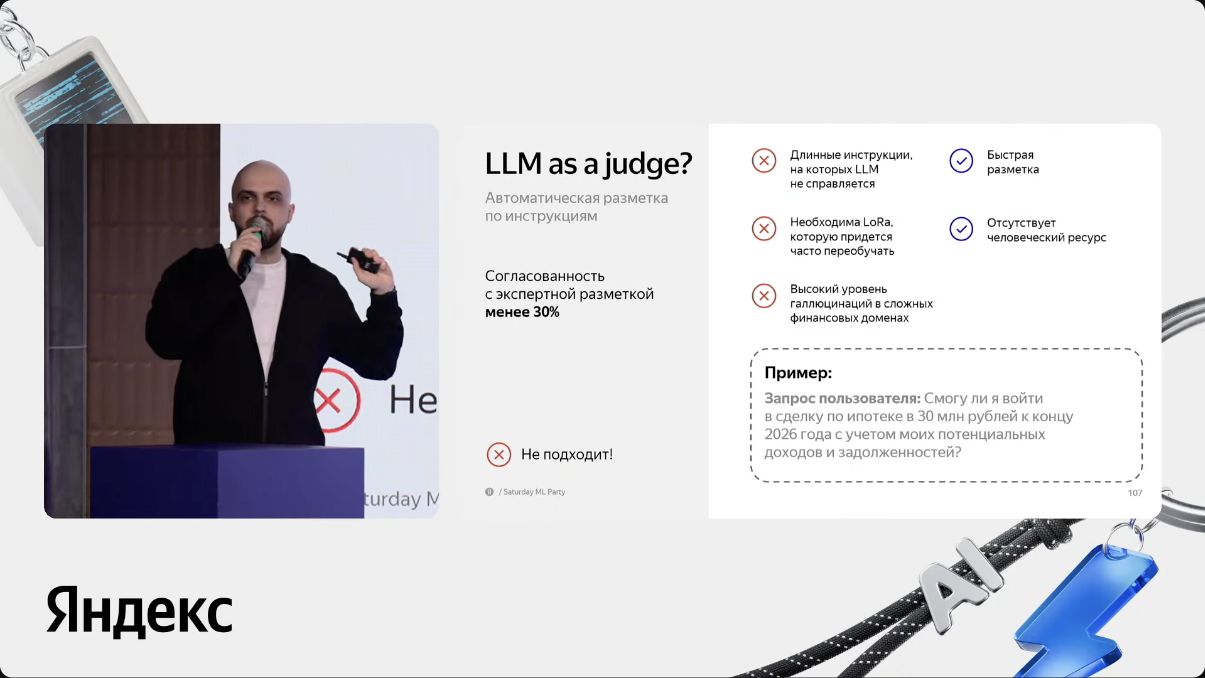
Слайд сообщает согласованность с экспертной разметкой менее 30%. Это характеристика показанной модельной разметки, не качество роутера и не универсальная оценка всех LLM-судей.
Источник: Артём Хусаенов · СберКластеры сокращают объём экспертной последней мили
Выход нашли в повторяемости запросов. Разные формулировки часто выражают близкую потребность, поэтому их можно объединять в кластеры. Вместо поштучной разметки всего потока эксперт работает с такими группами. Для роутинга его задача — оценить, правильный ли инструмент используется для конкретного кластера запросов.
Запросы собирают и кластеризуют ежедневно. Экспертную часть автор называет последней милей: автоматическая обработка сокращает объём материала, но окончательное содержательное решение остаётся за человеком. Экспертиза зависит от канала: для банковских вопросов нужны финансовые знания, для детского общения — понимание подходящего разговора с ребёнком, для инвестиционного канала — соответствующая предметная компетенция.
Это схема масштаба работы команды, а не обещание одинаковой производительности на любых запросах. Число просматриваемых примеров внутри кластера, длительность рабочего дня и отдельный протокол измерения трудозатрат не описаны. Дневная автоматическая группировка и недельная экспертная работа — разные части регулярного процесса.
В речи также названа ежедневная кластеризация примерно 80% запросов. Это покрытие потока, а не процент правильных кластеров или ответов. Эксперт работает с накопленным материалом: пользовательский запрос не ждёт его индивидуального решения перед выдачей ответа.
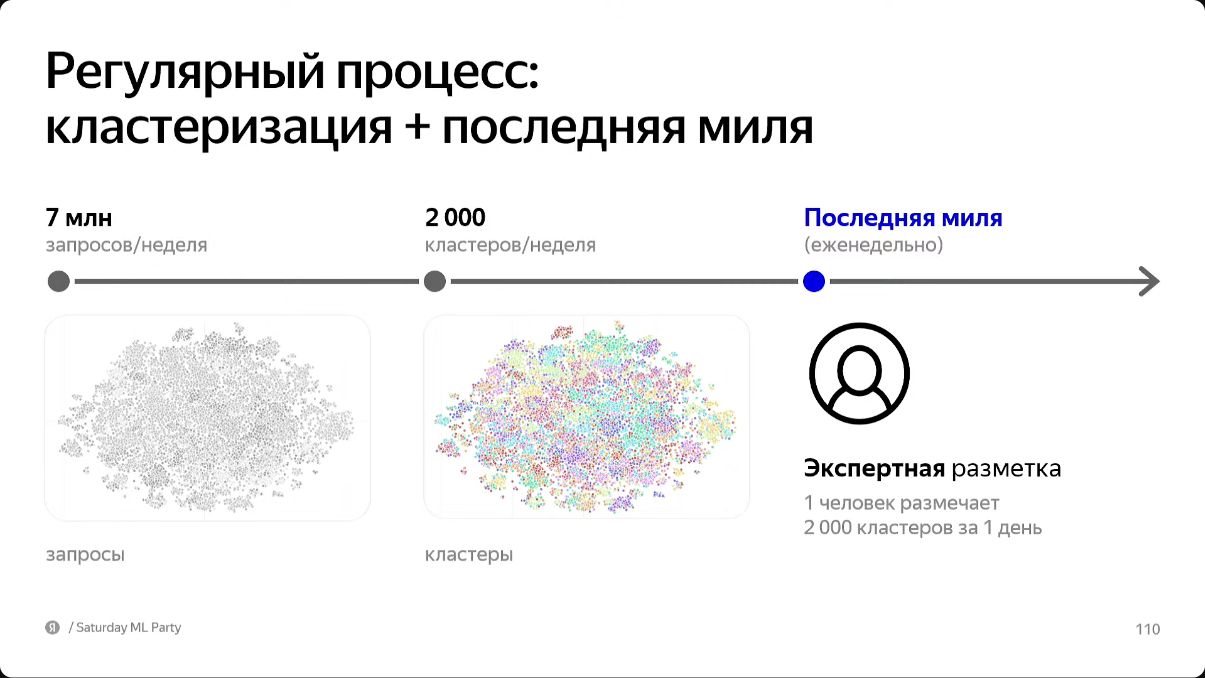
На слайде: 7 млн запросов за неделю → 2 000 кластеров за неделю. Один эксперт размечает 2 000 кластеров за день; это показанная автором схема масштаба работы.
Источник: Артём Хусаенов · СберРазметка накапливается, но не освобождает от контроля изменений
Размечать всё с нуля каждую неделю не обязательно. Если запросы и набор навыков изменились мало, уже выполненная разметка сохраняет полезность. Экспертная работа тогда сосредотачивается на новой или изменившейся части материала. Именно накопление меток объясняет, почему повторная оценка может занимать существенно меньше времени.
Это условная экономия, а не постоянная норма производительности: при заметных изменениях потока или навыков объём работы снова вырастет. В докладе не раскрыты правила сопоставления кластеров между неделями, переноса меток и пересмотра старых оценок. Поэтому речь идёт о принципе повторного использования разметки, а не о полностью описанном алгоритме её обновления.
Доклад · 00:54:14Измерение роутинга помогает исправлять ошибки и выбирать новые навыки
После появления регулярной оценки команда обнаружила ошибки, которые раньше не были видны системно, и провела исправления. Слайд связывает этот этап с ростом качества роутинга. Важно разделять охват мониторинга и качество маршрутизации: они отвечают на разные вопросы.
Таблицу можно прокрутить по горизонтали.
Размер выборки, период сравнения, доверительные интервалы и способ взвешивания запросов или кластеров не указаны. Эти результаты нельзя автоматически распространять на весь пользовательский опыт или персональную фактологию. Из охвата в 80% также не следует, что оставшаяся часть трафика ошибочна.
Не менее важен продуктовый результат: становятся видны группы запросов, для которых у платформы ещё нет подходящего навыка. Новые сценарии выбирают по наблюдаемой потребности, а не только по предположению команды о том, что стоит предложить пользователю. Слайд отдельно отмечает обнаружение низкочастотных потребностей.
Команда также заявляет о запуске статистически значимых ретротестов роутинга до выхода в A/B-тест и о подробном отслеживании эффектов A/B-тестов. Однако критерии значимости, размеры наборов, разбиение трафика и результаты отдельных экспериментов не приведены. Само это заявление не превращает рост роутинга в доказанный денежный эффект.
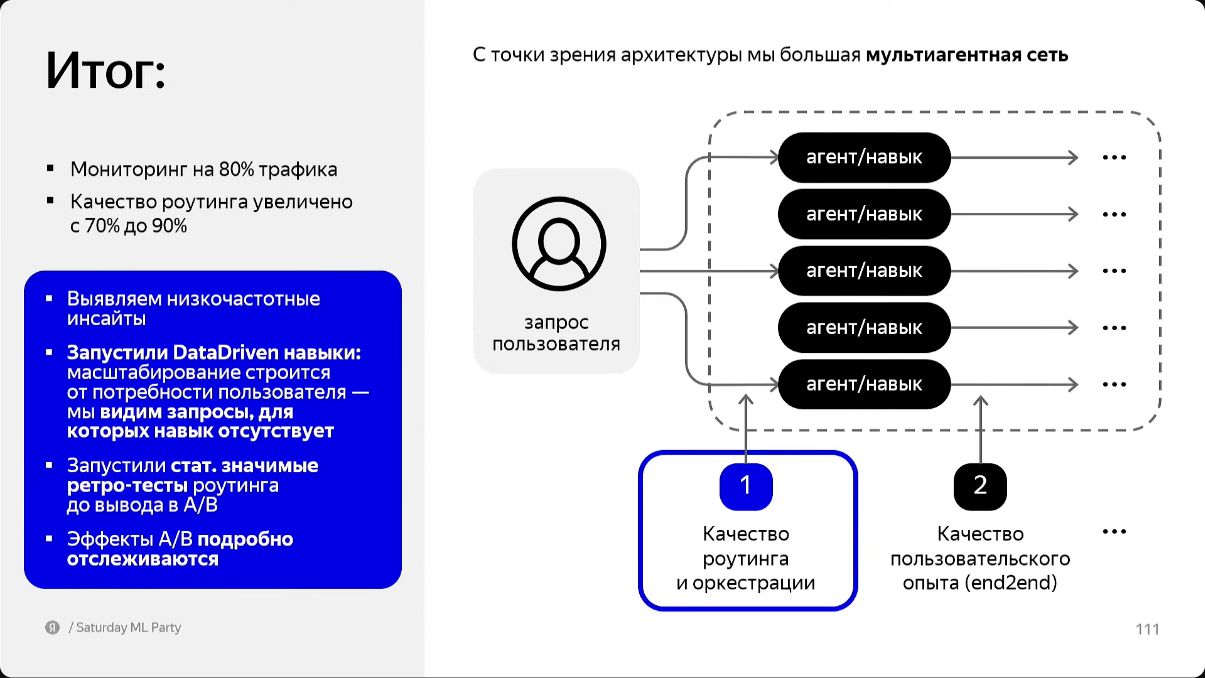
Мониторинг покрывает 80% трафика; качество роутинга выросло с 70% до 90%. Это рост на 20 процентных пунктов, а не относительный прирост на 20%.
Источник: Артём Хусаенов · СберПосле правильного маршрута остаётся весь диалог
Маршрут отвечает только на начальный вопрос: какой инструмент должен помочь. Дальше ассистент объясняет результат, уточняет запрос и поддерживает разговор. Если оценивать лишь выбор агента, ошибки на этих этапах останутся за пределами измерения.
Разные каналы требуют разного взгляда на диалог. В Сбербанк Онлайн автор называет среднюю глубину около 1,5–2 сообщений. Период измерения, состав выборки и правило подсчёта сообщений не определены; это характеристика названного канала в рассказе, а не всей платформы.
В детском общении со Сберкотом разговоры, напротив, могут быть длинными и менять тему. Ребёнок обсуждает домашнее задание, затем вспоминает историю и просит анекдот. Здесь полезность нельзя установить по первой реплике: нужно видеть развитие разговора и то, как ассистент сохраняет подходящее поведение при смене контекста.
Доклад · 00:55:53От кластеров запросов — к ответам и продолжениям диалога
Команда расширила группировку на ответы ассистента. Внутри кластера запросов теперь видны разные способы ответа: основной сценарий, альтернативная формулировка или ошибка. Затем группируются продолжения и диалоги. Получается иерархическое представление: похожие входы связаны с вариантами ответов и дальнейшим ходом взаимодействия.
На слайде разобран вопрос «Какие надбавки по Вкладу Премьер?». Он показывает, зачем различать содержание ответов внутри одной группы запросов. Это иллюстрация устройства анализа, а не отчёт о качестве всех ответов платформы.
Таблицу можно прокрутить по горизонтали.
Доли относятся только к примеру. Основание их расчёта не установлено, а подписи с количеством ответов не позволяют надёжно восстановить общий знаменатель. Поэтому 1,4% нельзя читать как частоту ошибок всего продукта или использовать для пересчёта числа неудачных диалогов.
Экспертная последняя миля сохраняется и на этом уровне. Для оценки диалогов на слайде показано: два человека размечают 6 000 кластеров за два дня. Это отдельная заявленная нагрузка, не та же единица работы, что 2 000 кластеров запросов за день у одного эксперта. Правила просмотра примеров, часы работы и условия сопоставления этих схем не раскрыты.
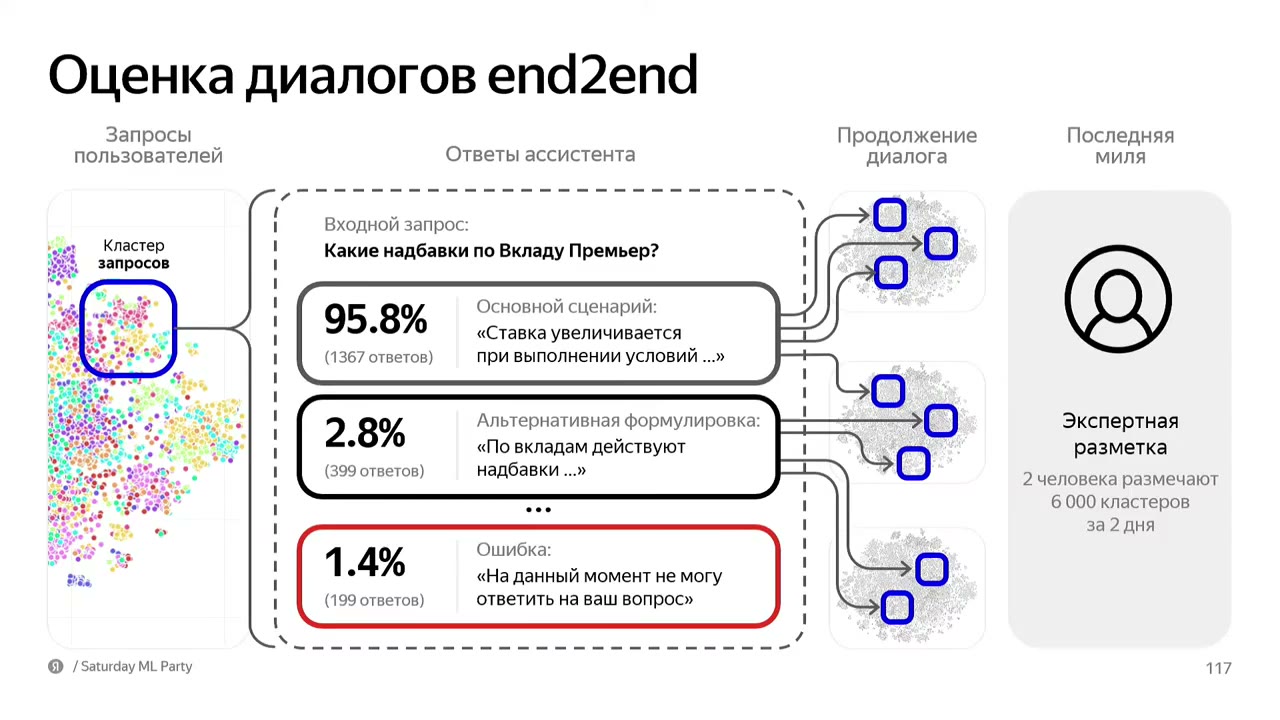
Кластеры запросов, ответов и продолжений диалога оценивает эксперт. На слайде: два человека размечают 6 000 кластеров за два дня; показанные доли относятся к примеру, не ко всему трафику.
Источник: Артём Хусаенов · СберИнтерфейс связывает примеры, доли и развитие разговора
Кластеры становятся рабочим объектом внутреннего интерфейса. Для выбранной группы доступны примеры ответов ассистента и краткая сводка, составленная языковой моделью. Рядом отслеживаются доли соответствующих запросов и ответов, участники и время взаимодействия.
Интерфейс также позволяет увидеть, где пользователь сам закончил диалог и где разговор перешёл к другому инструменту. Так эксперт получает не только название темы, но и материал для разбора того, что произошло с пользователем после первого ответа.
Модельная сводка помогает ориентироваться в группе, но не заменяет экспертную оценку. Подробный способ построения описаний кластеров и правила выбора показываемых примеров автор не раскрывает. Приведённое в речи сравнение с компактной таблицей объясняет удобство просмотра, а не размер фактического производственного набора.
Доклад · 00:57:37Поведение: что происходит в разговоре
После группировки диалогов команда может добавлять новые оценки под задачи партнёров: одним важен тон общения с ребёнком, другим — выполнение банковского запроса, проверки безопасности или качество новостной повестки в инвестиционном канале. Автор говорит примерно о 150 метриках к концу недели выступления, которые нужно оценивать и которые команда, по его словам, умеет оценивать. Полный перечень и фактические значения этих показателей не приведены.
На слайде каталог разделён на поведение, умения и знания. Поведение описывает качество диалога, умения — качество действий, знания — качество экспертизы. В таблицах ниже приведены названия, смысл и способы оценки из этого каталога. Это не результаты замеров и не доказательство автоматического расчёта всех показателей на всём трафике.
Таблицу можно прокрутить по горизонтали.
Таблицу можно прокрутить по горизонтали.
Таблицу можно прокрутить по горизонтали.
Даже знакомое название не заменяет определение из конкретной системы. Например, TTR здесь описано числом уточняющих вопросов, а не временем решения. Для Action Uplift на слайде не названы целевая величина и контрольный вариант. Формулы, шкалы экспертной оценки и правила агрегации каталог не задаёт.
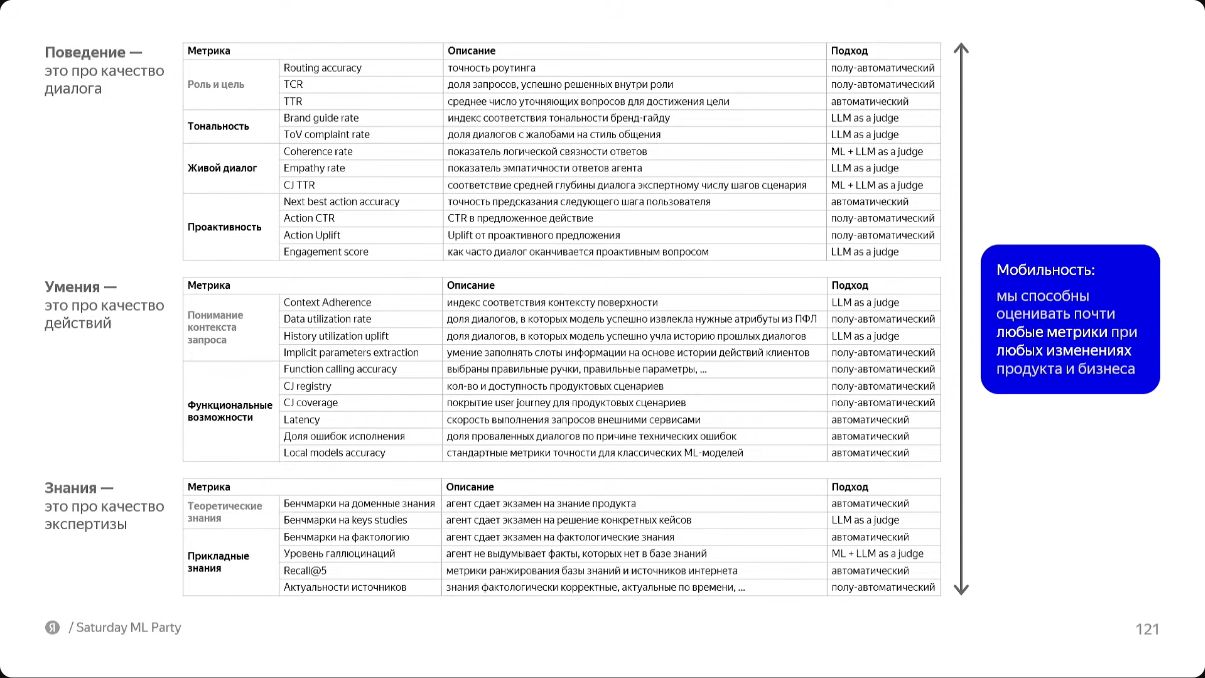
Исходная таблица связывает качество диалога, действий и экспертизы с автоматическими, экспертными и модельными способами оценки.
Источник: Артём Хусаенов · СберУмения: понимание контекста и выполнение действий
Вторая группа отделяет понимание запроса от способности выполнить действие. Можно выдержать подходящий стиль разговора, но не извлечь нужные данные, не учесть историю или вызвать функцию с неверными параметрами. Поэтому эти проверки не растворяются в общей оценке ответа.
Таблицу можно прокрутить по горизонтали.
ПФЛ — обозначение источника атрибутов на слайде; его расшифровки в материале нет. У History utilization uplift описание дано как доля диалогов с учтённой историей: отдельная формула прироста относительно контроля не приводится.
Таблицу можно прокрутить по горизонтали.
Таблицу можно прокрутить по горизонтали.
Эта часть каталога важна и для понимания границы function calling. Правильно выбрать функцию — не то же самое, что успешно выполнить её без технической ошибки. На слайде это разные показатели; значений задержки, доли ошибок и точности локальных моделей не показано.
Доклад · 00:58:14Знания: продуктовая экспертиза и опора на источники
Третья группа посвящена тому, что агент знает и насколько обоснованно использует знания. В каталоге рядом стоят проверки знания продукта, решения конкретных случаев, фактической корректности, работы с материалами базы знаний и свежести источников.
Таблицу можно прокрутить по горизонтали.
Таблицу можно прокрутить по горизонтали.
Таблица показывает, что одному семейству показателей могут соответствовать разные проверяющие механизмы. Но названия проверок не сообщают, какие задания входят в экзамен, как устроена шкала и какой результат считается достаточным. В частности, Recall@5 здесь — название метрики, а не приведённое значение качества; состав эталона и формула подсчёта не раскрыты.
Доклад · 00:58:14Эксперт, модель и простые счётчики решают разные задачи
Кластеризация делает материал обозримым и позволяет расширять набор оценок, но не означает, что всё измеряет один и тот же эксперт. В каталоге есть автоматические, полуавтоматические и модельные подходы. Для сложного банковского маршрута нужна предметная оценка; для отдельных аспектов общения команда допускает LLM as a judge.
В техническом Q&A автор уточняет, что после оценки правильности инструмента эксперт размечает и аспекты полного диалога: тон общения, GCR — Goal Completion Rate, TCR — Task Completion Rate. Для TCR на слайде дана доля успешно решённых запросов внутри роли. Отдельные правила различения цели и задачи, знаменатель GCR и шкалы разметки не описаны.
Есть и показатели, которые легко считать без содержательной разметки. Автор приводит пример: как часто последним символом переписки оказывается вопросительный знак со стороны ассистента. Это грубый признак попытки продолжить разговор. Сам докладчик называет такую метрику плохой: наличие вопроса ещё не означает, что продолжение было полезно пользователю.
Этот пример не заменяет способ оценки Engagement score из каталога, где указан LLM as a judge. Он показывает границу простой эвристики. И наоборот, неудача модельной разметки роутинга не требует отказа от модельной оценки тона общения: у этих задач разная сложность и разные основания для проверки.
Доклад · 00:58:14Персональные факты проверяют по вызовам функций и финальному ответу
Кластеризация не закрывает проверку индивидуальных финансовых значений. Два пользователя могут задать почти одинаковый вопрос и получить одинаково сформулированный ответ, но остаток на счёте, доход или кредитный потенциал у них различаются. Метка общего кластера не подтверждает правильность конкретной суммы. Ошибка в одном нуле способна радикально изменить смысл ответа.
Для таких задач команда переходит к вызовам функций — function calling. Языковая модель выбирает нужный расчёт и его параметры, а результат получает от соответствующей функции. Сквозной пример снова касается возможности ипотечной сделки на 30 млн рублей к концу 2026 года. Сумма и даты относятся только к иллюстрации, а названия функций на схеме не представлены как документированный API.
Таблицу можно прокрутить по горизонтали.
Проверка разделяется на две части. Сначала нужно сопоставить запрос с выбранной функцией и убедиться, что параметры соответствуют задаче. Затем — сравнить возвращённый результат с финальным ответом пользователю: при изложении результата модель не должна подменить число или добавить неподтверждённый факт. Подходящий тон и контекст общения при этом остаются отдельными требованиями.
На слайде сопоставление запроса и вызова названо более простой задачей, для которой можно использовать ручных разметчиков и LLM as a judge. В последнем ответе Q&A автор подтверждает разметку корректности параметров людьми. Это не утверждение, что вся проверка финальной фактологии уже автоматизирована.
Доклад опирается на детерминированность функций: при одинаковых условиях они должны давать одинаковый результат. Это позволяет отделить проверку выбора и параметров от предметного пересчёта результата, но не доказывает отсутствие ошибок реализации, данных или исполнения. Детерминированность не заменяет инженерную проверку самих функций.
В речи автор говорит именно о переходе к function calling. Формулировка на слайде про реализацию всех фактологических навыков через функции описывает подход, но не подтверждает, что перевод каждого навыка уже завершён.
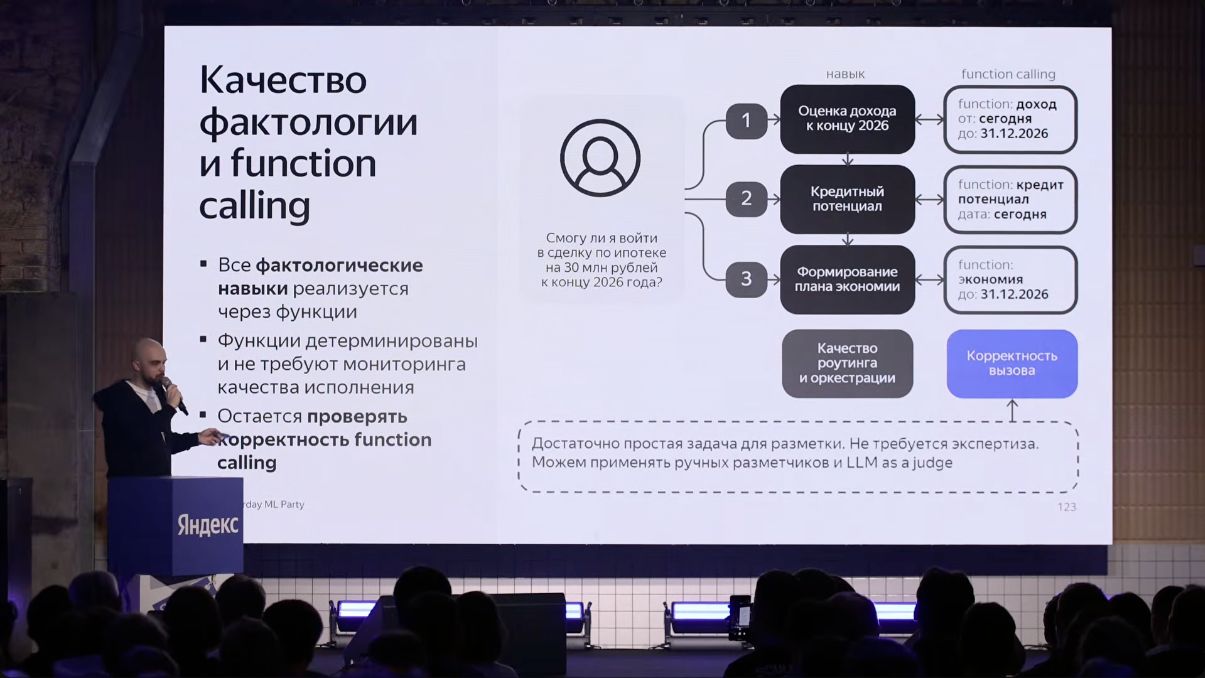
Индивидуальные финансовые значения проверяют отдельно: выбор функции, параметры вызова и соответствие финального ответа полученному результату.
Источник: Артём Хусаенов · СберSFT, LoRA и промпты — отдельный процесс улучшения
Когда ошибки стали измеримыми, возник следующий вопрос: как исправлять систему, не ухудшая соседние сценарии. Автор противопоставляет развитие по группам метрик реакции на отдельный неудачный скриншот. Быстро исправить один ответ заманчиво, но без общей проверки изменение может создать проблемы в других частях платформы.
Метрики объединяют в направления, для которых подходят общие методы улучшения. На слайде SFT связан с ролью и целью, а также с проактивностью; LoRA — с тональностью и живым диалогом. В речи отдельно названы SFT для роутинга, перенос части длинных инструкций в LoRA и подбор более удачных примеров для промптов.
Таблицу можно прокрутить по горизонтали.
Обновления сопровождают еженедельной оценкой и разметкой целых групп метрик. Смысл подхода — видеть, как общий приём влияет на разные сценарии, а не считать исправление одного случая достаточным доказательством улучшения.
Обучение и изменение промптов происходят отдельно от регулярного мониторинга и обслуживания пользовательского запроса. Экспертная оценка даёт основания для изменений и проверяет их последствия; она не означает, что модель дообучается заново на каждом запросе. SFT и LoRA в докладе не сравниваются как взаимоисключающие альтернативы.
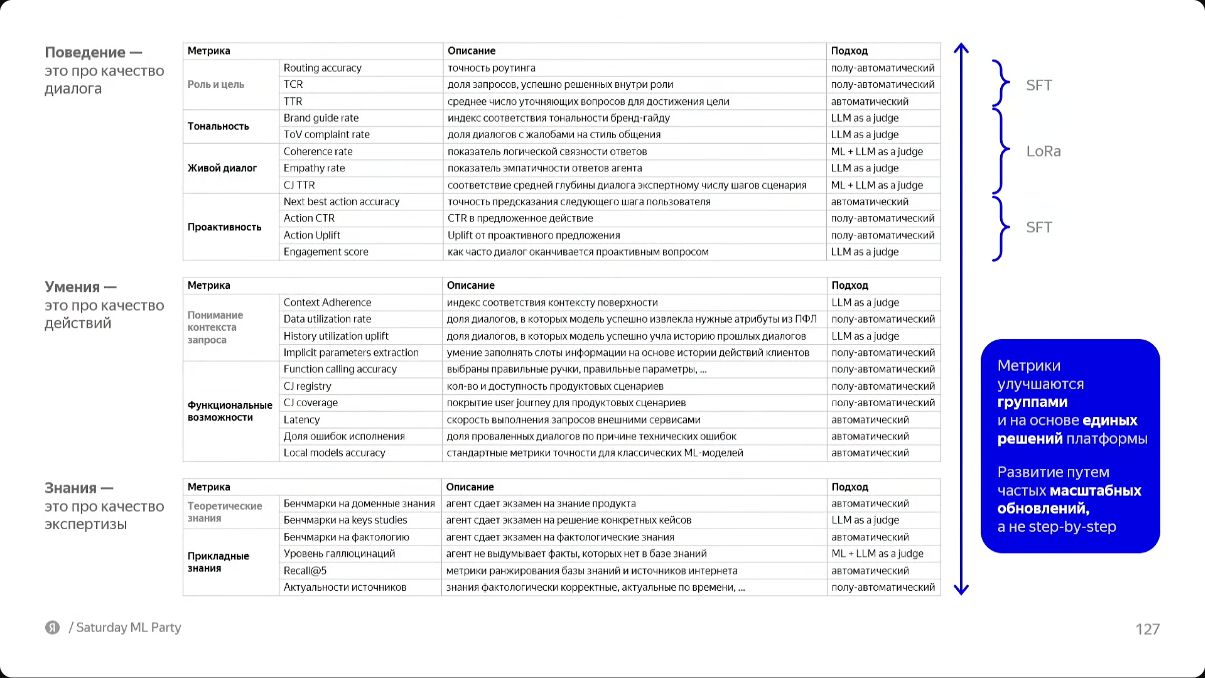
SFT и LoRA показаны как инструменты работы с группами метрик. Развитие строится на общих решениях платформы, а не только на локальном исправлении одного случая.
Источник: Артём Хусаенов · СберТехнический Q&A: один алгоритм не подходит всем каналам
На вопрос о смысле кластеров автор приводит группу запросов про доход по вкладам: пользователь может спросить, сколько заработал, каков его доход или сколько получит с вклада. В показанном объяснении это одна группа потребностей. Кластер здесь нужен для организации оценки, а не является заранее названным банковским продуктом.
Способы кластеризации различаются по каналам и навыкам. По словам автора, векторные представления текстов — эмбеддинги — хорошо работают в разговорном детском канале. Для длинных специфических запросов Сбербанк Онлайн одной кластеризации на эмбеддингах оказывается недостаточно. Детали банковского решения он не раскрывает.
Иерархические подходы автор оценивает положительно, но полного алгоритма, моделей эмбеддингов и параметров не приводит. Из двумерной картинки кластеров также нельзя вывести метод построения представлений или группировки. Поэтому доклад объясняет организацию оценки и различия каналов, а не даёт воспроизводимый рецепт конкретного кластеризатора.
Доклад · 01:06:01Отсечку подбирают по ошибкам, а не только по общей метрике
Для проверки кластеризации команда использует небольшие заранее размеченные наборы данных. Их размер, состав и конкретные показатели качества не раскрыты. Это отдельная проверка того, насколько удачно сгруппирован материал, а не оценка полезности ответов ассистента.
Другой приём — просматривать таблицу с отсортированными оценками кластеров и искать границу, где начинают встречаться ошибки. Специалист двигается по таблице в обе стороны, сужает интервал и выбирает отсечку. Автор называет такой поиск методом дихотомии и подчёркивает, что команда не сразу пришла к этому простому визуальному способу.
Эта процедура не задаёт универсальную формулу количества кластеров: неизвестны смысл сортирующей оценки, её шкала и правило принятия решения для всего потока. Рассказ показывает, как специалисты на практике находят рабочую границу, но не заменяет проверку качества кластеризации на размеченных данных.
Если одна тема распалась на несколько групп или внутри кластера смешались разные случаи, эксперт сообщает об этом команде. Он работает рядом с разработчиками и собирает проблемные примеры к концу недели. Затем команда исправляет кластеризацию. Какие именно изменения вносят — в представления, группировку или пороги — в ответе не уточняется.
Доклад · 01:08:29Продуктовые компромиссы согласуют с владельцами каналов
Большое число метрик не отменяет необходимости выбирать приоритет. В ответе на вопрос о перегрузке информацией автор описывает работу продуктовых и проектных менеджеров: они обсуждают изменения с партнёрами и помогают определить, каким показателем можно пожертвовать ради другого.
Пример из Q&A — удалось повысить TCR, но ухудшился тон общения. Это не ситуация, где можно объявить безусловную победу по одному числу. Команда показывает обе стороны владельцу продукта или канала и согласует дальнейшее направление.
По оценке автора, такие согласования могут замедлить работу на коротком горизонте, но ускоряют развитие в долгосрочном. Численного измерения этого ускорения нет. Доклад также не задаёт общую формулу, которая сводила бы все показатели к одному итоговому баллу: компромисс остаётся продуктовым решением, опирающимся на измерения.
Доклад · 01:09:38Пересечение навыков сначала разрешают организационно
Агенты разных команд могут частично дублировать друг друга. Например, отдельный агент вкладов и более широкий помощник оба заявляют, что умеют отвечать про вклады. За каждым стоят владельцы продукта и собственные отчёты по продажам, поэтому неоднозначность нельзя устранить только технической настройкой маршрута.
Сначала команды договариваются о границах ответственности: кому должны доставаться такие запросы и какой агент лучше закрывает потребность. Продуктовые менеджеры помогают закрепить это решение. Только после договорённости появляется понятное основание считать определённый маршрут правильным.
Затем команда анализирует запросы и ошибки, меняет описания навыков и части роутинга, перепроверяет результат. Когда нежелательное пересечение маршрутов устранено, изменение запускают в промышленную эксплуатацию. Так организационная договорённость превращается в проверяемое поведение системы, а не остаётся лишь формулировкой в описании агента.
Доклад · 01:10:17Почему сохраняют узких агентов и где заканчивается показанный масштаб
На вопрос о единственном универсальном агенте автор отвечает аргументом банковской специфики: для всех задач одновременно потребовались бы слишком длинные промпты, а далеко не все требования удаётся перенести в LoRA. Поэтому команда выбирает отдельных агентов с узкой предметной областью.
Это объяснение архитектурного выбора команды, а не доказательство невозможности универсального агента в любом банковском продукте. Сравнительного эксперимента, размеров инструкций и измерения качества двух архитектур в докладе нет.
Отдельный вопрос касается работы с более чем сотней или тысячей функций. Эти числа задаёт спрашивающий; автор говорит, что команда такого масштаба ещё не достигла. Фактическое число функций не названо. Разделение и распределение по каналам обсуждаются как возможное дальнейшее решение.
Метафункцию, которой нужный вариант передаётся параметрами, предлагает ведущий. Автор соглашается с допустимостью идеи, но не описывает её реализацию в Сбере. Этот вариант нельзя добавлять к уже работающей архитектуре платформы.
Доклад · 01:11:35Связь с бизнесом начинается с формулировки метрик
На вопрос о технических прокси, которые коррелируют с бизнесовыми результатами, автор отвечает, что метрики стараются сразу формулировать вместе с бизнесом. Платформа должна уметь измерить нужный продукту аспект, а не только подобрать удобную внутреннюю метрику модели.
В качестве связанных с бизнесом показателей он называет точность роутинга и качество кластеризации. Но количественной проверки этой связи в докладе нет: не указаны конкретные бизнесовые переменные, коэффициенты корреляции, выборка и период наблюдения. Поэтому это заявленная связь, а не продемонстрированная статистическая или причинная зависимость.
Практическая связь хорошо видна в других частях рассказа: группы запросов показывают, какого навыка не хватает; измерения помогают обсудить компромисс между выполнением задачи и стилем общения; после исправления пересекающихся навыков можно проверить новые маршруты. Денежный эффект, прирост продаж и окупаемость системы оценки не приведены.
Доклад · 01:14:50Что уже используется, а что остаётся переходом
На момент выступления автор описывает не только концепцию, но и действующий регулярный процесс: запросы кластеризуются, эксперты размечают группы, результаты обсуждаются с продуктовыми командами. При этом степень готовности отдельных частей различается.
Ограничения относятся и к воспроизводимости: не раскрыты конкретный банковский кластеризатор, модели представлений, полные инструкции разметки и правила переноса меток между неделями. Заявленные результаты показывают направление и масштаб работы команды, но не гарантируют те же показатели при других данных и организации экспертизы.
Доклад · 00:52:59Итог: регулярный мониторинг вместо проверки каждого запроса
Сбер решает задачу систематической оценки платформы агентов, а не ручного одобрения каждого ответа. Повторяющиеся запросы и диалоги объединяются в группы, с которыми может работать предметный эксперт. Персональные финансовые значения проверяются отдельно. Это периодический контур мониторинга по накопленным взаимодействиям: пользователь не ждёт, пока эксперт прочитает его запрос и разрешит ассистенту отвечать.
- 01
Собрать взаимодействия
Платформа накапливает запросы, ответы и продолжения разговоров из своих каналов, чтобы видеть материал для оценки роутинга и пользовательского опыта.
- 02
Сгруппировать запросы
Ежедневная кластеризация объединяет близкие потребности. Вместо всего потока по одному запросу для дальнейшей работы доступны группы.
- 03
Связать ответы и диалоги
Внутри групп запросов выделяются варианты ответов и продолжения разговора. Иерархия помогает находить повторяющиеся сценарии и ошибки.
- 04
Провести экспертную последнюю милю
Эксперты регулярно оценивают маршруты и аспекты диалогов. Накопленная разметка уменьшает повторную работу, когда материал изменился мало.
- 05
Проверить персональную фактологию
Для соответствующих задач сопоставляются запрос, выбранная функция и параметры, затем результат функции сравнивается с финальным ответом.
- 06
Собрать картину качества
Оценки показывают проблемные сценарии, незакрытые потребности и изменения групп метрик. Эти результаты передаются командам, отвечающим за развитие продукта.
Обучение через SFT и LoRA, изменение промптов и проверка последствий обновлений — отдельный процесс развития. Его не нужно смешивать с шагами мониторинга или включать в обработку каждого пользовательского запроса.
Заявленный результат — мониторинг 80% трафика и рост качества роутинга с 70% до 90%, на 20 процентных пунктов. Размер выборки, период и доверительные интервалы не раскрыты. Главный вывод доклада — экспертизу не устранили, а сосредоточили на компактном представлении данных; при этом фактология, качество кластеризации и продуктовые компромиссы сохранили собственные проверки.
Доклад · 00:52:59