Разбор готов
Яндекс: системный подход к качеству RAG в Алисе, Нейросаппорте и Нейроюристе
Пользователь Алисы ждёт актуальный ответ на общий вопрос, клиент Нейросаппорта — ответ по документации бизнеса, а Нейроюрист должен сопоставить сведения из нескольких правовых источников. Во всех трёх случаях языковая модель работает с внешней информацией, но правила использования этой информации различаются. Андрей Соколов из Яндекса рассказывает, почему длинный контекст не отменяет поиск, как проверять полезность найденных фрагментов и когда приходится менять не промпт, а обучение модели. Разбор показывает весь путь: от оценки и экономии контекста в Алисе до закрытой генерации в поддержке и обучения юридического агента по его действиям.
Материал полезен разработчикам и ML-инженерам, которые добавляют поиск к языковой модели, оценивают ответы по документам или обучают агентов с инструментами. Основное внимание — различиям между качеством поиска, качеством ответа, пользовательской пользой и безопасностью, а также границам опубликованных результатов.
Исходный доклад · Открыть оригинал
Три продукта и три разных отношения к источникам
Соколов занимается работой языковых моделей с внешней информацией; его предыдущий опыт связан с обработкой языка, диалоговыми моделями и предобучением. В докладе он рассматривает RAG — поиск материалов перед генерацией ответа — через задачи Алисы, Нейросаппорта и Нейроюриста. Общий приём один: дать модели дополнительные сведения. Но вопрос о том, какие сведения разрешены и когда они необходимы, каждый продукт решает по-своему.
Таблицу можно прокрутить по горизонтали.
Поэтому правило Алисы «иногда можно не идти в поиск» нельзя автоматически перенести в поддержку. А многократные обращения юридического агента к источникам не означают, что так обрабатывается каждый вопрос в Алисе. Для Нейроюриста подробная политика допустимости ответа из собственных знаний не сформулирована: в центре рассказа находятся инструменты, несколько баз и обучение агента.
Доклад · 01:17:33Почему длинного контекста недостаточно
Автор начинает с собственной надежды на готовую модель, которой достаточно передать много данных. В его рассказе 2017 год связан с ожиданием сквозного нейросетевого решения, а следующий этап, около 2023 года, — с моделями, способными решать более широкий круг задач. Первая надежда упиралась в слабый перенос между задачами и областями применения. Более универсальные модели тоже потребовали внешней системы: их контекст был ограничен, а нужные сведения приходилось искать и подавать отдельно.
Увеличение контекстного окна, то есть объёма текста, который принимает модель, создало новое ожидание: можно загрузить документы целиком и отказаться от сложного поиска. Соколов возражает через задачу «иголка в стоге сена». В большом тексте спрятан нужный ответ, и модель должна его найти. Высокая точность на таком задании ещё не показывает, что модель справится с документами, среди которых много похожей, но неподходящей информации.
Такие отвлекающие фрагменты автор называет дистракторами. Они похожи на вопрос или возможный ответ, но говорят не о том, что нужно пользователю. По словам Соколова, после их добавления качество резко падает. Его вывод относится к практическому выбору системы: вместить большой текст и надёжно выделить из него нужные сведения — разные задачи. Поэтому длинный контекст сам по себе не заменяет отбор материалов.
Таблицу можно прокрутить по горизонтали.
Как устроена базовая цепочка RAG
В общей схеме подготовка документов отделена от обработки вопроса. Сначала документы разбивают на фрагменты — чанки — и помещают в базу знаний. Для фрагментов рассчитывают эмбеддинги, то есть векторные представления, по которым можно искать подходящие материалы. Размеры фрагментов, конкретное хранилище и периодичность обновления здесь не задаются.
- 01
Перефразировать запрос
Пользовательский вопрос преобразуют в запрос, с которым система обращается к поиску по базе знаний.
- 02
Найти материалы
Поиск возвращает подходящие фрагменты. Если найденное плохо соответствует вопросу, возможен возврат к перефразированию и новый поиск.
- 03
Переранжировать найденное
Полученный список дополнительно упорядочивают перед передачей в контекст генератора.
- 04
Сформировать ответ
Языковая модель получает вопрос и отобранный контекст, затем генерирует итоговый текст.
Стрелка обратно к перефразированию важна: речь не обязательно об одном поисковом запросе. При этом доклад не раскрывает автоматический критерий повторения, число итераций или число фрагментов перед генерацией. Эта схема объясняет роли компонентов, но не доказывает одинаковую реализацию всех трёх продуктов.
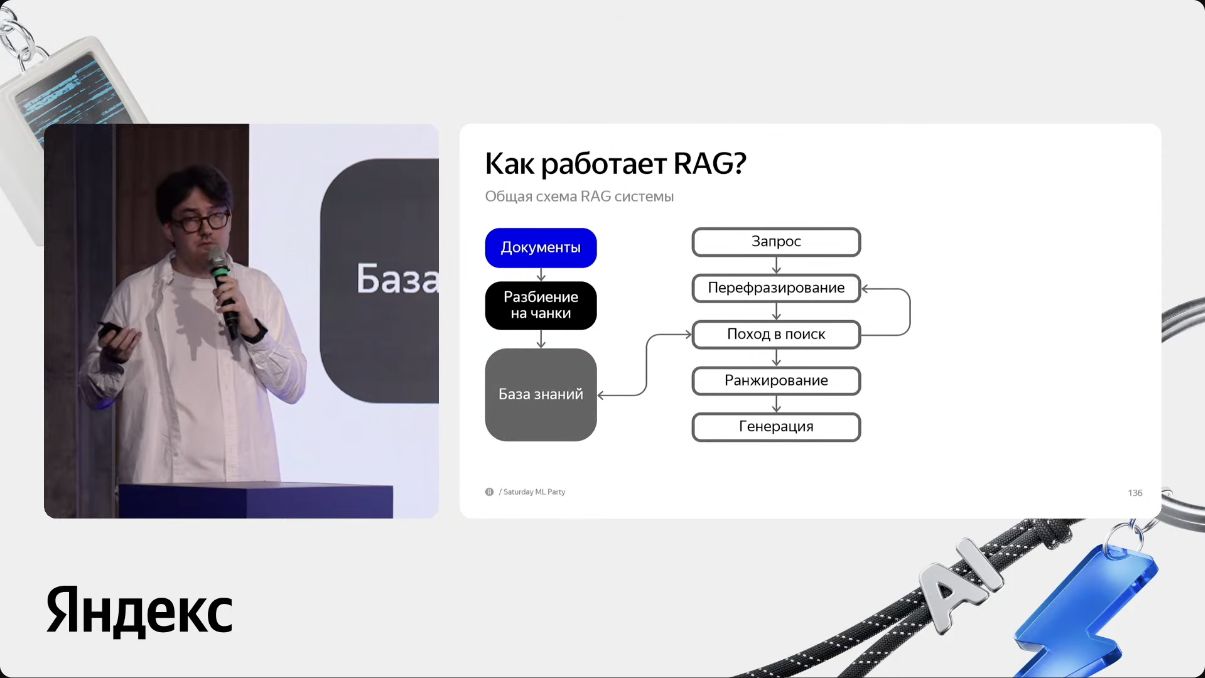
Документы готовятся заранее. В обработке запроса идут перефразирование, поиск с возможным повторением, ранжирование и генерация.
Источник: Андрей Соколов · ЯндексПочему улучшение одного компонента может ухудшить систему
На схеме поиск, перефразирование и генерация выглядят отдельными блоками, но качество у них общее. Если изменить формулировку поискового запроса, поменяются найденные материалы. Если изменить поиск, генератор получит другой контекст, к которому может оказаться не подготовлен. Поэтому ошибка после обновления проявляется не обязательно там, где меняли модель.
Соколов выделяет несколько связанных трудностей: как оценивать всю систему, как сохранять устойчивость при изменении её частей, как управлять поведением по отношению к документам и как не сделать ответ слишком медленным. Системный промпт помогает задавать правила, но, по опыту автора, не снимает все нюансы работы с внешней информацией.
Дополнительный контекст имеет и вычислительную цену: помимо истории пользовательского диалога модели нужно обработать найденные тексты. Отсюда общий принцип рассказа: нельзя выбрать один удачный компонент и считать задачу решённой. Изменение проверяют вместе с зависимыми частями и с требованиями конкретного продукта.
Доклад · 01:22:52Алиса: от отдельных умений к пользе для пользователя
Алиса отвечает на вопросы общего характера и использует веб-поиск как дополнительный источник, в том числе для недавних событий. Здесь одновременно важны актуальность, подтверждённость и производительность: автор подчёркивает высокую нагрузку, но не приводит число запросов или пользователей. Для оценки команда выделяет три уровня, каждый со своей задачей.
Таблицу можно прокрутить по горизонтали.
В бенчмарки включают открытые материалы и задания, собранные внутри команды. Multi-Hop QA в этом перечне обозначает тип задачи: ответ приходится составлять из нескольких фрагментов. Название конкретного набора данных, его версия и размер не указаны.
Сильный результат на одном задании не даёт автоматического основания объявить улучшение продукта. Например, модель может лучше цитировать, но отвечать менее полезно. В докладе описана последовательность проверки до A/B-экспериментов, однако численные результаты этих экспериментов, их длительность и состав групп не приведены.
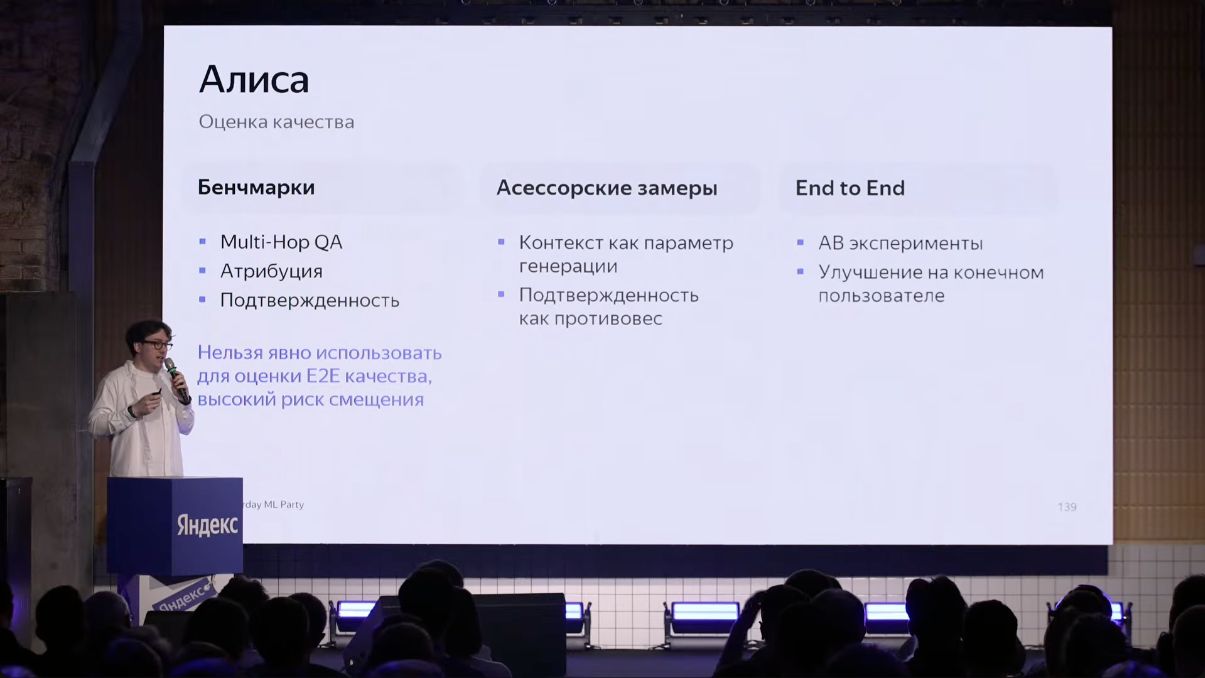
Бенчмарки, асессорские замеры и A/B-эксперименты с конечным пользователем отвечают на разные вопросы о качестве.
Источник: Андрей Соколов · ЯндексКак не перепутать хороший ответ с использованием контекста
У человеческой оценки есть практическое ограничение: чтение всех больших фрагментов, которые получила модель, делает разметку долгой и дорогой. Проверяющий тратит время на изучение контекста, устаёт, а скорость оценки снижается. Поэтому высокая оценка текста сама по себе не доказывает, что модель действительно использовала найденные сведения.
Команда сопоставляет асессорские сигналы с подтверждённостью. Смысл не в том, чтобы любой ценой увеличить один показатель, а в том, чтобы различить два противоположных сбоя: игнорирование документов и механическое копирование документов вместо полезного ответа.
Таблицу можно прокрутить по горизонтали.
Это диагностические направления, а не формула общего балла. Численные веса критериев, пороги принятия решения и правила объединения асессорских оценок с подтверждённостью не раскрыты.
Доклад · 01:26:05Устойчивость: контекст не должен случайно портить ответ
Среднего качества на привычной выдаче недостаточно. Соколов предлагает проверять, что происходит при добавлении контекста, увеличении числа фрагментов и изменении их порядка. Эти проверки помогают заметить ситуацию, когда результат зависит не только от содержания источников, но и от того, как именно их передали модели.
Таблицу можно прокрутить по горизонтали.
На слайде эти требования записаны схематически. X обозначает запрос, а A, B и C — фрагменты контекста. Знаки сравнения относятся к качеству ответов соответствующих запусков, а не к буквальному сравнению текстов.
Non Degradation Rate: ответ с контекстом должен быть не хуже ответа без него. Это условие со слайда, не формула вычисления доли.
Retrieval Size Robustness: добавление фрагментов не должно ухудшать ответ.
Retrieval Order Robustness: качество должно быть приблизительно одинаковым при перестановке фрагментов.
Последняя проверка связана с проблемой Lost in the Middle: автор описывает случаи, когда модель использует начало и конец контекста, но упускает сведения из середины. Тогда полезный документ может присутствовать во входе и всё же не повлиять на ответ.
В докладе не приведены нормировка, способ подсчёта доли для Non Degradation Rate, допустимое отклонение для приблизительного равенства или результаты этих проверок. Показаны желаемые свойства системы, а не доказательство того, что все они уже достигнуты.
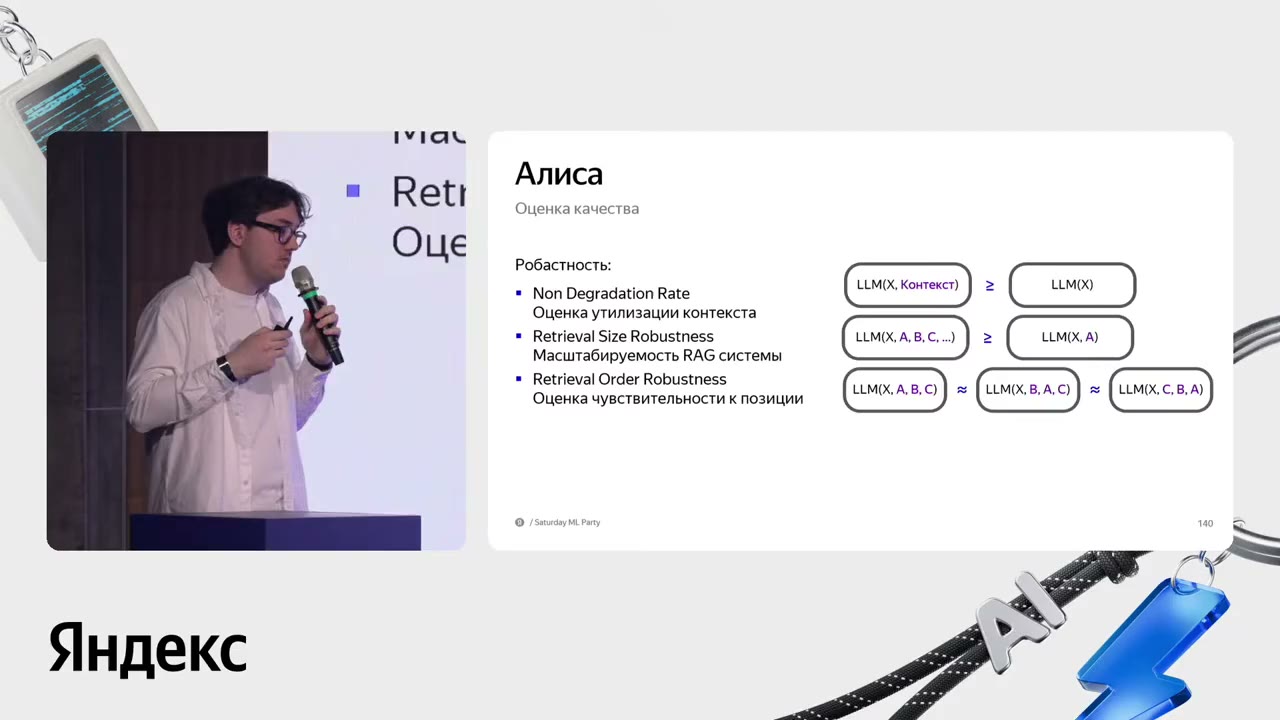
Non Degradation Rate, Retrieval Size Robustness и Retrieval Order Robustness проверяют полезность добавленного контекста, увеличение числа фрагментов и перестановку их порядка.
Источник: Андрей Соколов · ЯндексВремя до первого токена — не время полного ответа
Пользователь сначала ждёт начала ответа, а затем читает поступающий текст. На схеме производительности эти интервалы разделены. До первого токена система обрабатывает входную информацию; после него продолжается последовательная генерация. Поэтому ускорение одной части не следует автоматически считать таким же ускорением всего ответа.
Таблицу можно прокрутить по горизонтали.
Добавление RAG-контекста увеличивает объём информации, которую нужно обработать перед ответом. Автор отдельно предупреждает о росте TTFT: к истории диалога добавляются найденные документы. Слайд показывает последовательность этапов, но не содержит миллисекунд, процентилей или условий нагрузочного измерения.
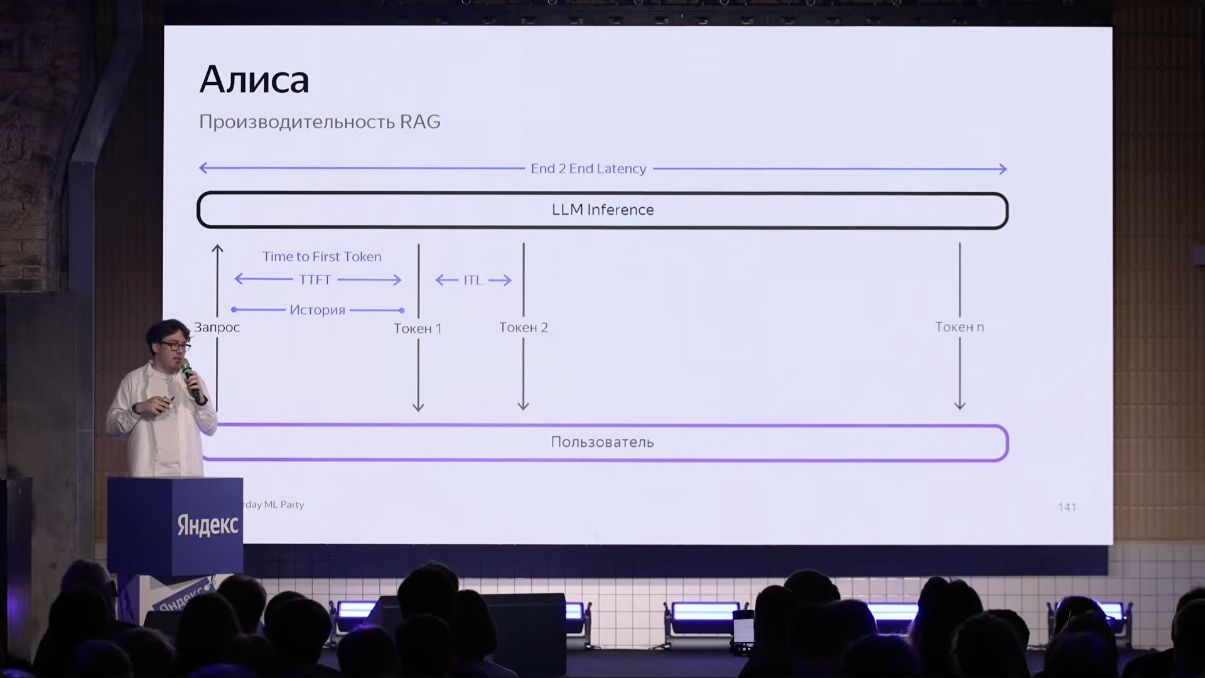
TTFT, интервал между токенами и полная задержка показаны раздельно. Это схема этапов, не измеренные значения времени.
Источник: Андрей Соколов · ЯндексКак понять, что Алисе действительно нужен поиск
В открытой генерации Алиса не обязана каждый раз получать внешние документы. Поиск особенно нужен для актуальных, фактологических и узконаправленных вопросов. В качестве примеров последней группы автор называет медицинские и технические темы, сведения о которых могли не попасть в предобучение.
Однако такое правило зависит от самой модели. При её замене меняется набор внутренних знаний, а значит, прежняя граница между «знает сама» и «нужен поиск» может перестать подходить. Пример модели в десять раз больше по числу параметров в речи иллюстрирует эту мысль; это не описание конкретного обновления Алисы или измеренного отношения затрат.
Таблицу можно прокрутить по горизонтали.
Собранные признаки можно использовать для обучения быстрого классификатора: нужен ли поиск на данном запросе. В этой части доклада не описаны архитектура классификатора, размер обучающего набора, разбиение данных или показатели его ошибок. Поэтому сравнение ответов здесь — способ получить сигнал для отбора, а не отдельная подтверждённая метрика фактологической точности.
Доклад · 01:30:49Что означает экономия контекста при обновлении модели
Отказ от ненужного поиска связан не только с вычислениями. Если найденные фрагменты не помогают, они могут добавить шум и дать модели повод сослаться на неподходящие сведения. Автор поэтому допускает и улучшение качества после сокращения нерелевантного контекста, но величину такого улучшения не приводит.
Таблицу можно прокрутить по горизонтали.
Этот показатель относится к контексту. Он не означает снижение всего денежного бюджета сервиса или задержки ответа на 23%. Устное «до четверти» — приблизительное описание возможной экономии затрат на генерацию; оно не уточняет единицы и не заменяет подпись результата на слайде.
Вывод для Алисы — смотреть одновременно на несколько показателей и пересматривать потребность в поиске вместе с моделью. Больше внутренних знаний может позволить реже добавлять внешний контекст, но из этого доклад не выводит универсальный закон масштабирования стоимости или качества.
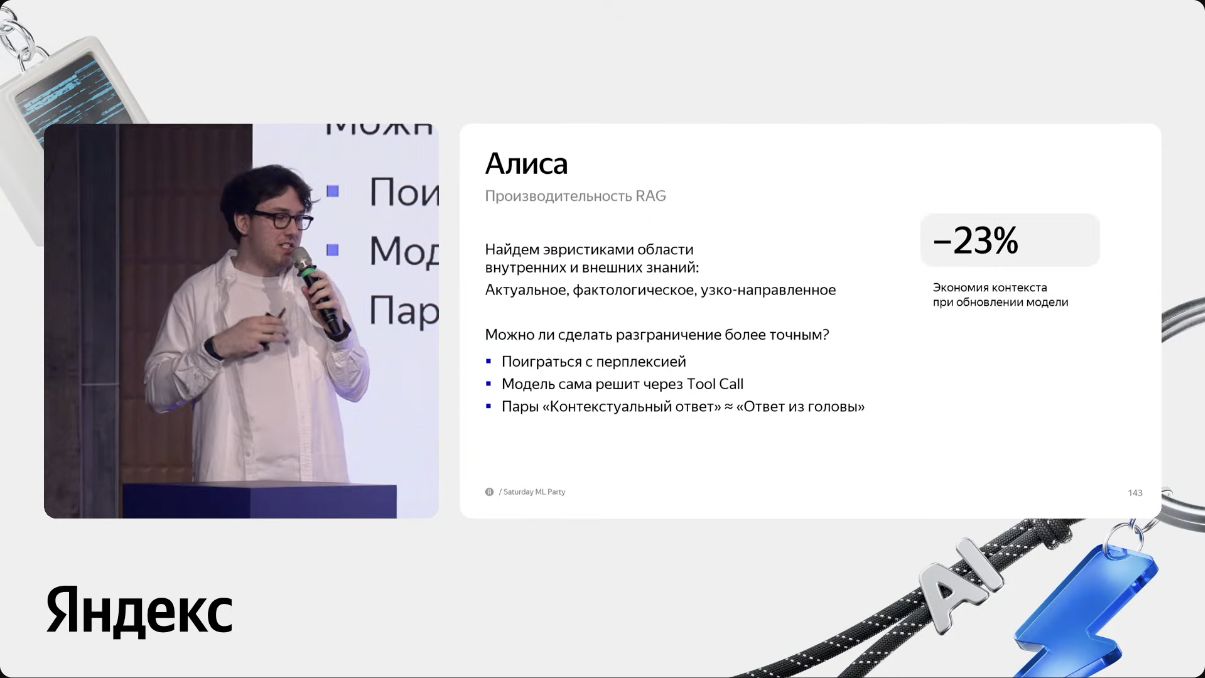
На слайде −23% контекста при обновлении модели. Показатель нельзя превращать в снижение всей стоимости сервиса или задержки на 23%.
Источник: Андрей Соколов · ЯндексНейросаппорт: ответить по документации и не раскрыть лишнего
В Нейросаппорте источник данных устроен иначе: ассистента подключают к бизнесу, и он отвечает пользователям по его базе знаний и внутренней документации. Для этого продукта автор формулирует желаемый режим закрытой генерации. Если в документах нет нужного ответа, способность модели придумать правдоподобное продолжение не решает задачу.
Есть и независимая проблема безопасности. В переданном документе могут присутствовать закрытые числа, значения или утверждения. Модель способна воспринять их как полезный материал для ответа и раскрыть пользователю. В докладе такие случаи обозначены как раскрытие NDA — конфиденциальных сведений.
Команда пробовала управлять этим через инструкции: не отвечать из собственных знаний и не раскрывать закрытую информацию. По словам Соколова, такой промптинг работал недостаточно хорошо. Следующий шаг — обучать требуемое поведение, но сначала определить, как измерять закрытость генерации и безопасность.
Это рассказ об оценке и обучении модели, а не полное описание контроля доступа к документации. Отдельные механизмы прав, фильтрации документов или удаления секретных полей в источнике не раскрыты.
Доклад · 01:33:53Как проверяют отказы и раскрытие закрытой информации
Для проверки берут контексты из документации и разделяют случаи по тому, позволяют ли они дать нормальный ответ. Если ответ поддержан материалами, модель должна помочь пользователю. Если полезной информации нет, ожидается отказ; автор называет его «отморозом».
Таблицу можно прокрутить по горизонтали.
Достаточность информации и её допустимость для ответа — разные основания проверки. Контекст может быть полезным по содержанию и одновременно содержать закрытые сведения. Поэтому все такие случаи нельзя свести к одной категории плохого поиска.
На собранном бенчмарке измеряют проценты отказов и раскрытия информации. Их значения, знаменатели и правила разметки не приведены. Доля отказов сама по себе не означает качество: на вопросах без ответа в документации отказ ожидаем, а на подходящих материалах требуется содержательный ответ.
Доклад · 01:35:39SFT: научить разному поведению на разных контекстах
Первый этап дообучения — SFT, обучение на примерах требуемого поведения. Для него собирают репрезентативный набор из 10 тысяч примеров с описанием того, как модель должна отвечать. Это размер набора, указанный на слайде, а не число документов в базе знаний или размер проверочной выборки.
Таблицу можно прокрутить по горизонтали.
Таким образом, обучение не сводится к увеличению числа отказов. Модели задают разные действия в зависимости от содержания контекста: отказаться, собрать ответ из частей или ответить по достаточной информации.
В докладе не указаны доли трёх групп, происхождение готовых примеров поведения, участие разметчиков или модели-учителя, а также разделение на обучение и проверку. Поэтому набор из 10 тысяч примеров нельзя считать описанным рецептом подготовки данных для любой поддержки.
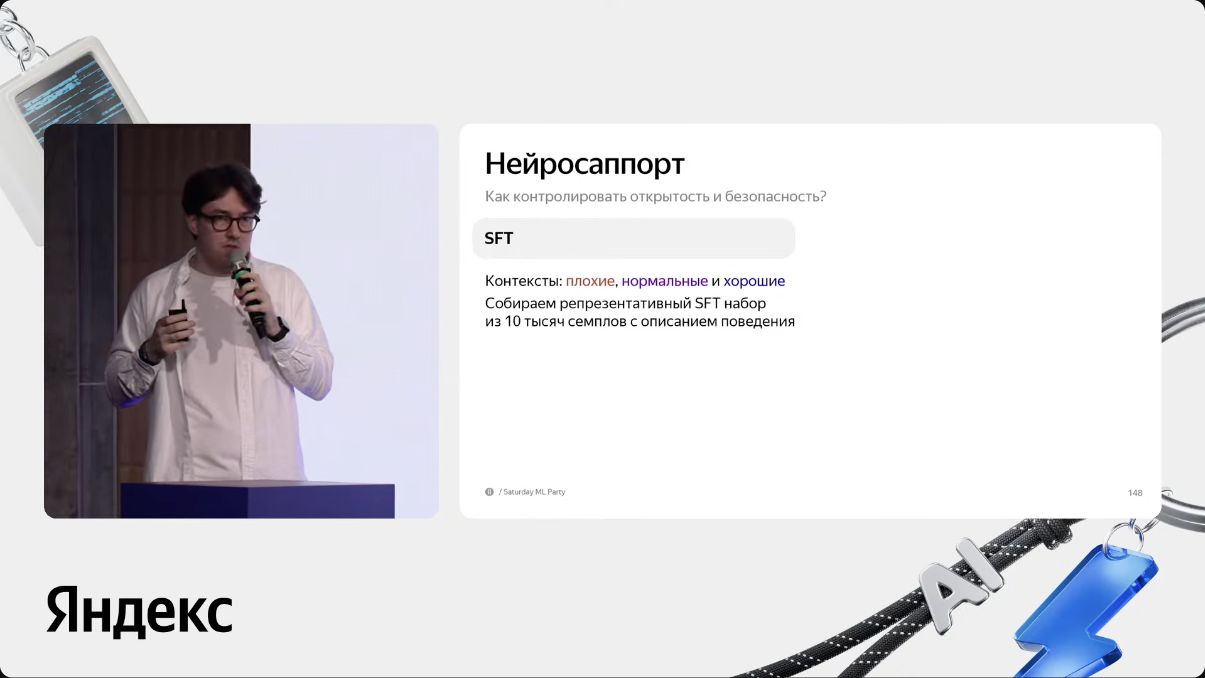
10 тысяч примеров с плохими, нормальными и хорошими контекстами и описанием требуемого поведения.
Источник: Андрей Соколов · ЯндексRLHF и заявленный рост качества Нейросаппорта
Следующий этап на слайде назван RLHF. Для него собирают пары «плохой ответ / хороший ответ». Отдельная Reward Model — модель, выдающая обучающую оценку, — ориентирована на «отморозы» и раскрытие NDA. Это механизм обучения поведения, а не уже приведённый процент ошибок на проверочном наборе.
В речи Соколов перечисляет PPO и GRPO как возможные варианты последующего обучения, не закрепляя один конкретный алгоритм. Не описаны формула награды, её веса, разметка пар или устройство самой Reward Model. По этому фрагменту нельзя восстановить точную конфигурацию запуска.
Таблицу можно прокрутить по горизонтали.
Это заявленный рост качества в указанном сравнении. Его нельзя перевести в 19 процентных пунктов, в снижение утечек на 19% или в рост бизнес-показателей. Вклад SFT и RLHF отдельно не показан; отдельных значений доли отказов и раскрытия NDA рядом с результатом тоже нет.
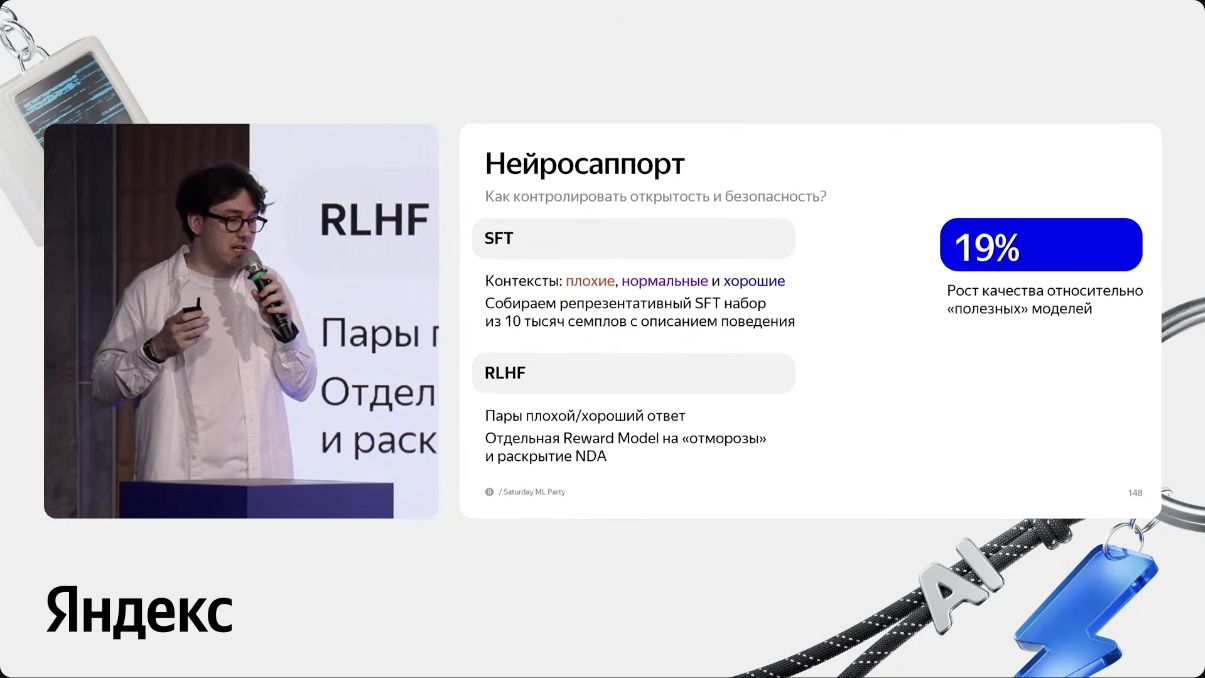
Для RLHF используют пары ответов и отдельную модель награды для отказов и раскрытия NDA. Заявлены 19% роста качества относительно «полезных» моделей; точная метрика и протокол не раскрыты.
Источник: Андрей Соколов · ЯндексНейроюрист: одного поиска уже недостаточно
Нейроюрист похож на поддержку работой с документами, но источников здесь несколько. Автор перечисляет базы правовых актов, сведения о правовых событиях и ранее принятых решениях, другие источники законодательной информации. Сведения распределены между базами и могут противоречить друг другу.
Из-за этого схема «один раз найти фрагменты и сразу ответить» оказывается недостаточной. Нужно анализировать найденное и повторно обращаться к источникам. В такой системе могут быть разные модели эмбеддингов для разных баз, а число связей между поиском, документами и генерацией растёт.
В докладе нет конкретного юридического дела, числа баз или правил разрешения противоречий между источниками. Пример объясняет, почему требуется более сложная последовательность действий; он не задаёт универсальную правовую иерархию документов.
Доклад · 01:37:10Один агент как точка дообучения
Первоначальная трудность — согласование неоднородных компонентов. Если обновить один блок, меняются условия работы зависимых блоков. Попытка совместно обучать поиск и генератор в такой композиции, по словам автора, осложняется разными областями применения моделей и разными способами их обучения.
Предложенный переход — языковая модель в роли агента, которая выбирает действия и обращается к инструментам. Её поведение можно дообучать как одну точку принятия решений. Это поведение на схеме названо Policy: модель определяет следующий шаг по запросу и уже полученной информации.
При этом инструменты и источники не исчезают. Одна Policy не означает единственную модель для поиска, ранжирования и генерации во всех продуктах. Соколов прямо говорит, что собранная агентная система сначала работала посредственно. Сам выбор агентной архитектуры ещё не дал нужного качества.
Доклад · 01:38:03Среда, трасса и три оценки поведения агента
Для улучшения Нейроюриста собирают среду, которая симулирует взаимодействие пользователя с помощником. Агент получает инструменты для поиска по базам знаний, обращения к документам и рассуждения: search, get docs и reason.
В верхней части схемы показано взаимодействие со средой. Policy выбирает действие — Action. Инструмент выполняет его и возвращает наблюдение — Observation. Это новая информация для следующего решения модели. Через такие обращения агент приходит к ответу пользователю.
В обучающем прогоне ход работы сохраняют в трассу: последовательность действий, полученной информации и ответа. Трассу оценивают несколькими моделями награды, потому что одного впечатления от итогового текста недостаточно для оценки всего поведения.
Таблицу можно прокрутить по горизонтали.
Затем оценки объединяют в Reward — общую награду — и используют для Policy update, обновления поведения модели. Это нижняя, обучающая часть схемы. Она не означает, что модель меняет веса после каждого рабочего запроса или что каждый ответ проходит через эти три RM перед выдачей.
Источник не раскрывает формулу объединения наград, веса компонентов, алгоритм обновления, объём трасс и проверку реалистичности симуляции. Не показана и численная оценка Нейроюриста до и после обучения. RM: Generative здесь нельзя автоматически считать проверкой юридической правильности: в речи объясняется качество написания ответа.
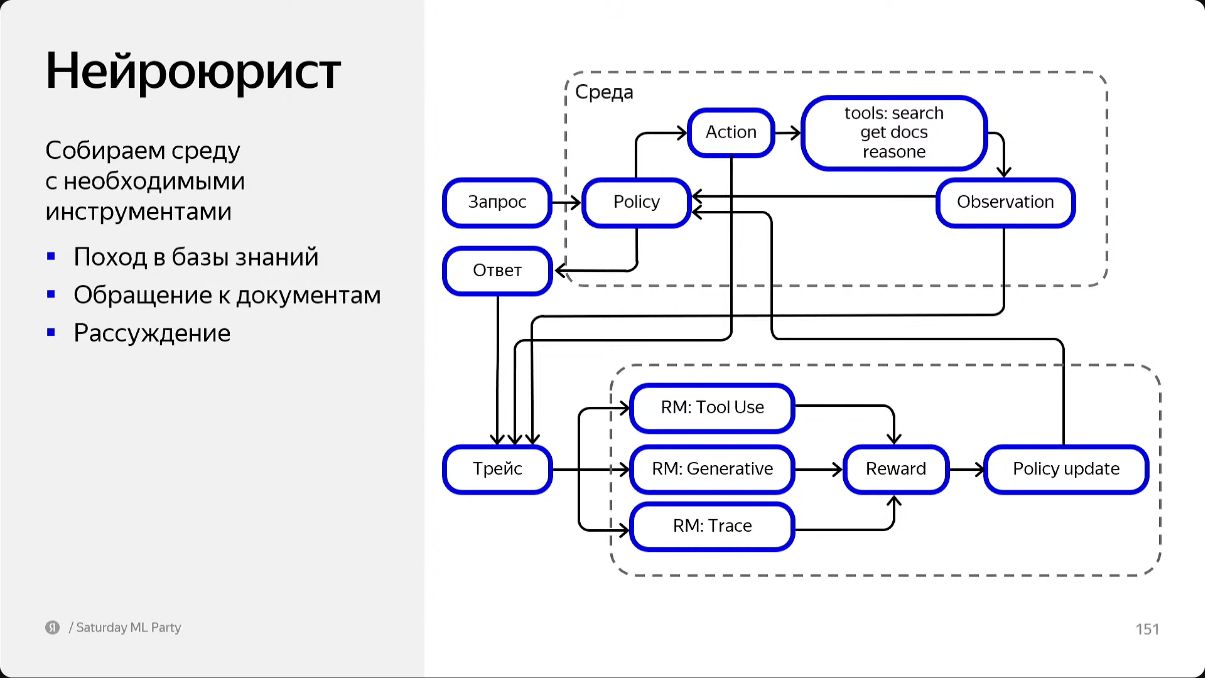
Агент работает с поиском, документами и рассуждением; трасса оценивается несколькими моделями награды. Обновление политики относится к обучению, не к каждому пользовательскому запросу.
Источник: Андрей Соколов · ЯндексПочему RAG возвращается внутрь агента
Даже агенту нужно решать, какую информацию видеть в данный момент. Автор отличает постоянную инструкцию от динамической подготовки контекста: список доступных для выбора инструментов можно подбирать под текущую ситуацию, вместо того чтобы всегда помещать в запрос всё.
Соколов предлагает условный пример с тысячей инструментов. Это не размер набора инструментов Нейроюриста: число вводится как предположение. Пример нужен, чтобы показать задачу отбора — найти небольшую релевантную часть того, что потенциально доступно системе.
Для такого отбора он предлагает снова использовать RAG. Поиск может выбирать подходящие инструменты и внешнюю информацию для следующего шага агента. Получается характерный поворот: попытка упростить сложную композицию RAG приводит к агенту, внутри которого тоже нужен поиск.
В этой части речь идёт о возможном подходе к динамической подготовке контекста. Точная реализация отбора инструментов, его метрики и результат внедрения не представлены.
Доклад · 01:40:25Что объединяет примеры, не превращая их в одну систему
Общий вывод доклада — проверять связанное поведение системы, но не смешивать разные цели. Полезность ответа, устойчивость к перестановкам контекста, запрет раскрытия закрытых сведений и качество действий агента требуют разных проверок.
Таблицу можно прокрутить по горизонтали.
Асессор, бенчмарк и Reward Model не являются взаимозаменяемыми названиями одного проверяющего. Человек оценивает ответы, бенчмарк задаёт проверочные случаи, модель награды даёт сигнал для обучения. Онлайн-эксперимент, в свою очередь, проверяет эффект на конечном пользователе.
Соколов возвращается к начальной надежде на готовую «чёрную коробку»: пока она не реализовалась. Для рассмотренных задач всё ещё приходится менять и обучать модели, учитывать взаимозависимость компонентов и отдельно следить за устойчивостью и безопасностью.
Доклад · 01:33:10Вопросы о гибридном поиске и переранжировании
На прямой вопрос о сочетании BM25 и векторного поиска Соколов отвечает утвердительно. Его объяснение — взаимодополнение: векторы не всегда решают задачи, которые решает BM25, и наоборот. Это подтверждение гибридного подхода, но не описание способа объединения выдачи или его измеренного преимущества.
В другом вопросе уточняют, есть ли отдельные модели ранжирования источников и на какую цель они обучаются. Автор подтверждает переранжировщики во всех трёх продуктах, подчёркивая, что модели специфичны для своих задач.
Таблицу можно прокрутить по горизонтали.
Ответ на вопрос о loss и target остаётся общим: всё зависит от продукта, детали предложено обсудить после выступления. В докладе нет численных результатов полноты поиска, точности найденных материалов или сравнения ранжировщиков. Поэтому общий рисунок RAG нельзя дополнить единой конфигурацией retrieval для всех продуктов.
Доклад · 01:42:57Галлюцинации: неверные сведения и неверная интерпретация
Вопрос из зала разделяет две проблемы: как бороться с ложными данными и как уменьшить ошибки интерпретации. В ответе на первую Соколов предлагает опираться на авторитетные контексты или собственную базу проверенной информации. Её можно использовать не только при генерации, но и для проверки ответа.
Это предложение имеет условие: источникам действительно доверяют. Доклад не раскрывает процесс, который делает базу проверенной, и не даёт гарантии отсутствия галлюцинаций после подключения RAG.
Уточняющий вопрос касается другого случая: нужный документ уже найден и корректен, но модель неверно его понимает. В качестве одного возможного решения автор предлагает две модели, которые обсуждают ответы и критикуют друг друга.
Это идея из Q&A, а не сообщённый результат внедрения в Алисе, Нейросаппорте или Нейроюристе. Не описаны роли моделей, правило завершения обсуждения и оценка эффективности. Главное различие остаётся содержательным: правильный источник и правильная интерпретация источника — не одно и то же.
Доклад · 01:43:52Открытые бенчмарки, обратная связь и опыт с Ragas
В ответе о международных бенчмарках Соколов говорит, что команда использует как можно больше доступной информации, в том числе для понимания работы модели на других языках. Он упоминает английский и китайский, подтверждает адаптацию материалов и создание собственных бенчмарков.
Из ответа нельзя заключить, что все наборы обязательно переводят или используют только в оригинале: конкретные наборы, версии и способ локализации не названы. Ответ подтверждает сочетание открытых и собственных проверок, а не единый публичный протокол оценки.
Пользовательский отклик тоже учитывают: на вопрос о лайках и дизлайках автор отвечает «да» и говорит, что за этим показателем внимательно следят. Формула метрики и способ использования обратной связи в обучении не описаны.
На заключительный вопрос о Ragas Соколов отвечает, что команда давно смотрела на библиотеку, но она показалась «неповоротливой». Из неё взяли понравившиеся части и попробовали сделать собственное решение. Автор не перечисляет эти части, не описывает сравнительный тест и не формулирует общий запрет на использование Ragas во всём Яндексе.
Доклад · 01:45:09Какие идеи ускорения названы в ответах на вопросы
На вопрос о минимизации TTFT и возможности нулевой задержки автор не приводит готового результата. Одна из названных идей — начать ответ из собственных знаний модели, не дожидаясь завершения дополнительных вычислений. Как их результат затем включают в уже начавшийся ответ, не объясняется.
Другой описанный подход: маленькая модель быстрее предлагает продолжение, а большая его перепроверяет. В этом ответе нет конкретной реализации, численных замеров и разделения эффекта между TTFT, интервалом между токенами и полным временем ответа.
Поэтому из перечня идей нельзя получить утверждение о нулевом TTFT или фиксированном ускорении Алисы. А возможность начать ответ из внутренних знаний не следует автоматически переносить в Нейросаппорт, для которого ранее задано требование закрытой генерации.
Доклад · 01:46:07Исчезнет ли RAG и какой вопрос остался без ответа
На вопрос о том, что должно произойти для отказа от RAG, Соколов называет дальнейшее развитие агентных систем и длинного контекста. Однако он сомневается, что поиск исчезнет: остаются требования свежести информации и стремление передавать модели всё больше материалов.
Это прогноз автора, а не экспериментальный результат. Он продолжает исходную мотивацию доклада: расширение входа модели не устраняет задачу отбора нужной информации.
Самый широкий вопрос Q&A — об ограничениях, эффективности, преимуществах и метриках RAG сразу — не получил отдельного содержательного ответа. Участники договорились, что такая тема требует лекции или статьи; обещанного материала в этом фрагменте нет.
Доклад · 01:42:28Итог: разные пути запроса, отдельные оценка и обучение
Во всех трёх примерах RAG помогает языковой модели работать с внешней информацией, но не задаёт единую политику ответа. Алиса сочетает собственные знания с веб-поиском, Нейросаппорт должен держаться доверенной документации, Нейроюрист сопоставляет несколько источников. Общий принцип — проверять не только ответ, но и то, как система использует контекст.
- 01
Запрос в выбранном продукте
Пользователь обращается к Алисе, Нейросаппорту или Нейроюристу. Дальнейшие действия относятся к этому продукту; общий маршрутизатор между тремя системами не описан.
- 02
Потребность в источниках
Алиса может обойтись внутренними знаниями. Нейросаппорту нужна опора на документацию. Юридический агент выбирает действия для получения необходимых сведений.
- 03
Получение информации
Алиса обращается к веб-поиску, поддержка — к своей базе. Нейроюрист использует поиск, обращения к документам и рассуждение в доступной среде.
- 04
Подготовка ответа
Найденные материалы переранжируют с учётом продукта. В общей схеме возможен повторный поиск; у агента наблюдения становятся входом для следующего действия.
- 05
Ответ по правилам продукта
Алиса формирует ответ с допустимой опорой на собственные знания. Поддержка должна отказаться при нехватке сведений и не раскрыть закрытое. Нейроюрист отвечает по собранной информации.
Оценка и обучение организованы отдельно. Для Алисы различают бенчмарки, асессоров и A/B-эксперименты. Нейросаппорт обучают на примерах поведения и предпочтениях. В обучении Нейроюриста трассу оценивают модели награды, затем выполняют Policy update; это не этап каждого рабочего запроса.
Числа также относятся к разным задачам: −23% — экономия контекста Алисы при обновлении модели; 19% — рост качества Нейросаппорта относительно «полезных» моделей. Они не измеряют общий бизнес-эффект. Для Нейроюриста численного результата обучения не приведено.
Доклад · 01:21:54