Разбор готов
МТС Диджитал: как меняли валидацию рекомендаций ради согласованности с A/B
В контентных сервисах МТС рекомендательная модель помогает выбрать фильм, книгу, музыку или мероприятие. Перед запуском команда сравнивает модели на прошлых данных, однако победитель такой проверки может уступить другой модели по результатам A/B. Дарья Тихонович разбирает одну из причин этого расхождения: популярные объекты доминируют не только в обучении, но и в тестовых взаимодействиях, по которым выбирают победителя. Решение меняет офлайн-оценку: влияние тестовых хитов уменьшают, а метрику и степень преобразования подбирают по прошедшим A/B. На примере Ticketland видно, как меняется порядок моделей и почему высокая ретроспективная корреляция ещё не равна доказанному росту числа успешных будущих экспериментов.
Материал полезен разработчикам рекомендательных систем и аналитикам экспериментов, которые знакомы с обучением на истории взаимодействий и базовыми метриками качества. Особенно важны различие между обучением и оценкой, устройство временных фолдов, выбор одной цели из нескольких метрик и границы выводов при малом числе моделей в A/B.
Видео · на русском
Валидация в RecSys для корреляции с А/В: что работает в контентных рекомендациях / Дарья Тихонович (AiConf 2024)Открыть оригинальные слайдыДарья Тихонович · Опубликовано: 12 марта 2026 г.
Исходный доклад · Открыть оригинал
Контентные сервисы и границы разбираемого опыта
Глава основана на докладе Дарьи Тихонович «Валидация в RecSys для корреляции с A/B: что работает в контентных рекомендациях», представленном на AiConf 27 сентября 2024 года. Запись опубликована 12 марта 2026 года; это дата загрузки видео, а не обновления исследования. Эксперименты, инструменты и планы далее относятся к состоянию, описанному на выступлении 2024 года.
Дарья представляет команду Content RecSys МТС и является мейнтейнером RecTools. В продуктовом контексте названы «Строки», МТС Music, KION, МТС Live и Ticketland. Команда сталкивается с похожим вопросом в разных сервисах: какую офлайн-оценку использовать, чтобы отобранная модель действительно была полезнее пользователям? Контентный домен здесь не означает одну конкретную архитектуру рекомендаций по признакам контента.
Численные эксперименты в докладе проведены на Ticketland. Они разделены на два исследования: изменение офлайн-оценок при поиске гиперпараметров и ретроспективное сопоставление метрик с конверсией в покупку в e-mail-рассылках. Перечень сервисов МТС не расширяет область этих чисел до всей экосистемы.
Доклад · 00:00:05Почему неверная офлайн-цель мешает всей разработке
Офлайн-валидация нужна ещё до выбора кандидата для A/B. Сначала команда перебирает гиперпараметры внутри одного класса моделей. Затем сравнивает лучших представителей разных классов. Только после этих двух отборов новая модель встречается с прежней в работающем продукте. Если офлайн-цель предпочитает неподходящее поведение, она может направлять в неверную сторону оба этапа.
Таблицу можно прокрутить по горизонтали.
Классическая цель в этой постановке — одна максимизируемая метрика по попаданиям: MAP, NDCG, Precision или Recall. Попадание, или True Positive, означает, что рекомендация совпала с положительным взаимодействием в тесте. Логика понятна: модель, предсказывающая наблюдаемые действия, выглядит хорошим кандидатом для продукта.
Однако в описанном опыте модель с более высокой целевой офлайн-метрикой могла статистически значимо проиграть модели с меньшей метрикой в A/B. Это не просто неудачный запуск: становится непонятно, на какую цель настраивать следующий поиск. Продолжать максимизировать прежнюю NDCG означает вновь довериться критерию, который уже не воспроизвёл предпочтение бизнеса. Частота таких случаев и размеры эффектов во вводной постановке не приведены.
Доклад · 00:01:33Какие обходные пути обсуждаются и чего в них не хватает
Докладчица перечисляет несколько способов жить с разрывом между офлайном и онлайном. Первый — быстрее отправлять новые модели непосредственно в A/B, принимая непредсказуемость офлайн-отбора. Второй — оставить модели простую цель, например Precision, а разнообразие и популярность регулировать бизнес-правилами в итоговой выдаче, не проверяя весь результат офлайн.
Третий подход более системный: накопить результаты множества A/B и логи разных офлайн-метрик, затем построить зависимость или отдельную модель, предсказывающую онлайн-результат по этим измерениям. Для него нужен собственный накопленный материал прошлых экспериментов. В докладе это один из возможных путей, а не компонент реализованной системы Ticketland.
Команда ищет другой рабочий компромисс: сравнительно простую методику настройки офлайн-цели для стандартного рекомендательного сценария. Она должна сохранить возможность систематического поиска гиперпараметров и одновременно учитывать, что большое число попаданий не исчерпывает качество рекомендаций.
Доклад · 00:02:52Популярность искажает не только обучение, но и выбор победителя
Объект рекомендации — фильм, книга, трек или мероприятие — может встречаться в истории намного чаще других объектов. В контентных сервисах МТС докладчица наблюдает степенное распределение популярности: небольшая «голова» каталога собирает много взаимодействий, тогда как у многочисленных объектов длинного хвоста их мало.
Такой перекос есть и в обучающей выборке, и в отложенном тесте. Второе обстоятельство особенно важно для валидации. Когда тестовые положительные взаимодействия сосредоточены на хитах, модель получает много True Positives, часто предлагая именно эти объекты. Метрика может предпочесть её более персональному варианту, который реже повторяет популярную часть каталога.
Смещение рекомендаций к популярным объектам называется popularity bias. В докладе оно рассматривается как проблема критерия отбора: даже если сравниваются разные модели, тест способен вознаграждать одну и ту же популярную выдачу. Это не утверждение, что любой хит плох или что все причины разрыва между офлайном и A/B сводятся к популярности.
Вывод из иллюстрации: изменить только обучение недостаточно, если проверка продолжает преимущественно награждать попадания в тестовые хиты. Большое число True Positives показывает совпадение с наблюдаемыми взаимодействиями, но само по себе не доказывает полезную персонализацию.
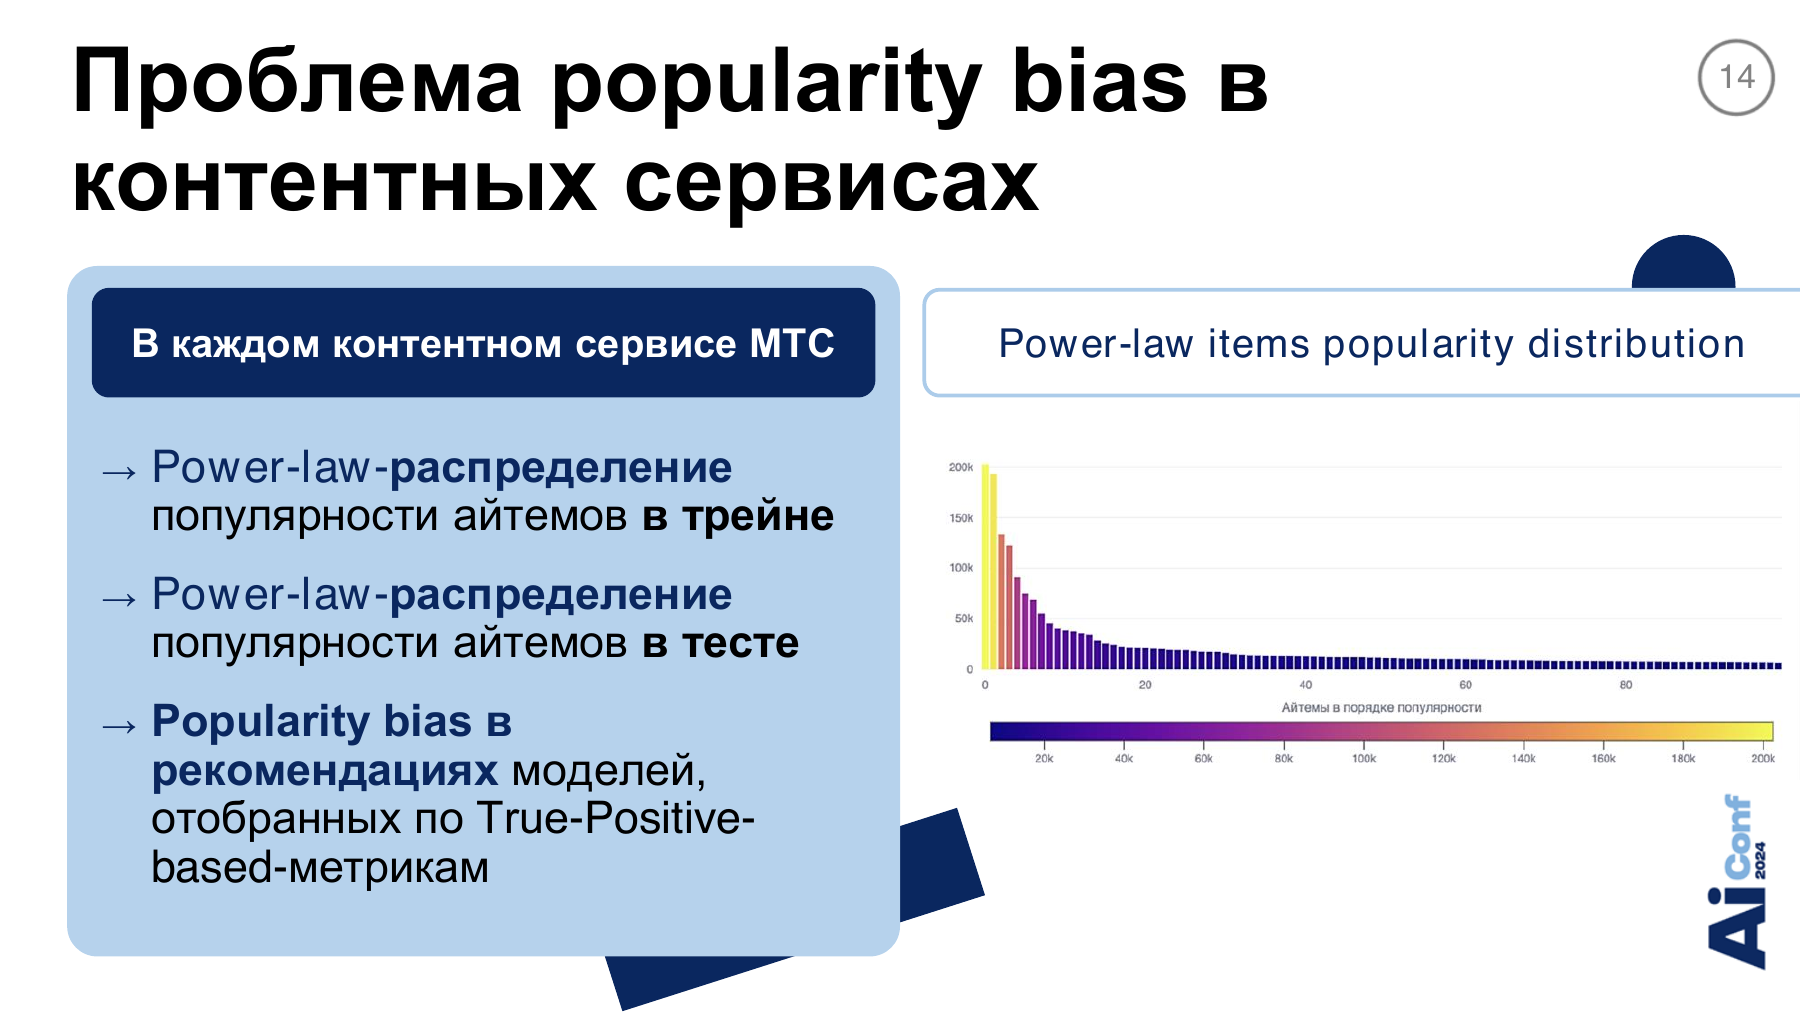
В обучении и тесте популярность распределена неравномерно; метрики по попаданиям могут поощрять ту же популярность вместо полезного выбора для пользователя.
Источник: Дарья Тихонович · МТС · слайд 14Почему просто максимизировать новизну тоже не получилось
Естественный ответ — добавить метрики, выходящие за рамки попаданий. На слайдах перечислены Novelty, Unexpectedness, Serendipity и Surprisal. Наиболее подробно обсуждается Serendipity: в объяснении докладчицы она соединяет релевантность с возможностью предложить новое и работать с длинным хвостом каталога. Точная формула используемой реализации не раскрыта.
Прямая максимизация такой цели в опыте команды создавала противоположную проблему. Модель слишком часто предлагала непопулярные объекты, которые не обязательно радовали пользователя. Уменьшение популярности выдачи не тождественно повышению её полезности: можно перейти от смещения к хитам к смещению в пользу редких объектов.
Поэтому задача превращается в выбор компромисса. На диаграмме моделей по осям Precision и Serendipity одни варианты лучше воспроизводят тестовые действия, другие сильнее учитывают вторую сторону качества. Нужно не заменить один безусловный максимум другим, а определить подходящий продукту баланс.
Доклад · 00:05:43Парето-фронт сокращает выбор, но не задаёт одну цель
На диаграмме можно оставить парето-оптимальные варианты: среди рассматриваемых моделей для них нет другой модели, которая была бы не хуже по обеим метрикам и лучше хотя бы по одной. Например, улучшение Serendipity без падения Precision даёт более ясный сигнал, чем обмен большого количества попаданий на небольшую прибавку второй метрики.
Но на таком фронте остаётся несколько победителей. Сам фронт не говорит, какой компромисс нужен пользователям конкретного сервиса. Он также не превращает многокритериальный выбор в одну численную цель, удобную для последовательного поиска гиперпараметров.
Требование команды состоит из двух частей: получить единую офлайн-цель, которая учитывает разные стороны рекомендаций, и проверить её связь с результатами A/B. Дальнейший debiasing теста — попытка настроить такую цель через распределение оцениваемых взаимодействий, а не формула сложения Precision и Serendipity.
Доклад · 00:06:43Как ограничивают вклад тестовых хитов через IQR
Предлагаемое преобразование уменьшает число тестовых пар «пользователь — объект» для слишком часто встречающихся объектов. Это даунсемплинг: часть наблюдений не включают в расчёт новой метрики. Популярный объект не удаляют из каталога и не запрещают рекомендовать; уменьшают число его тестовых взаимодействий, которые участвуют в оценке.
Сначала для каждого объекта считают его частоту в тесте. Затем рассматривают распределение этих частот по объектам. Q1 и Q3 — первый и третий квартили этого распределения. Их разность, межквартильный размах IQR, задаёт масштаб для определения границы частых объектов.
Формула со слайда 25. Q1, Q3 и IQR измеряются в числе тестовых взаимодействий на объект; это не доли пользователей.
Формула со слайда 25. Порог измеряется в числе взаимодействий на объект, iqr_coef — безразмерный коэффициент.
Если частота объекта выше границы, ему оставляют количество взаимодействий по этому пределу. Объекты ниже границы не требуется сокращать ради самого ограничения. Преобразование уменьшает тяжёлую голову распределения, но не означает, что все объекты обязательно получат одинаковую частоту.
При меньшем iqr_coef граница ниже и преобразование сильнее; при большем — выше и ближе к исходному тесту. Алгебраическое следствие формулы: при коэффициенте −1 граница равна Q1, при 0 — Q3, при 0,5 — Q3 + 0,5 × IQR. Это объяснение настройки, а не отдельный результат эксперимента.
Вывод из иллюстрации: коэффициент задаёт, насколько частый объект может перевешивать остальные при офлайн-оценке. Формула не устанавливает правила округления дробного порога или обработки вырожденного распределения; эти детали реализации в докладе не приведены. Конкретный численный порог из неподписанных точек графика не восстанавливается.
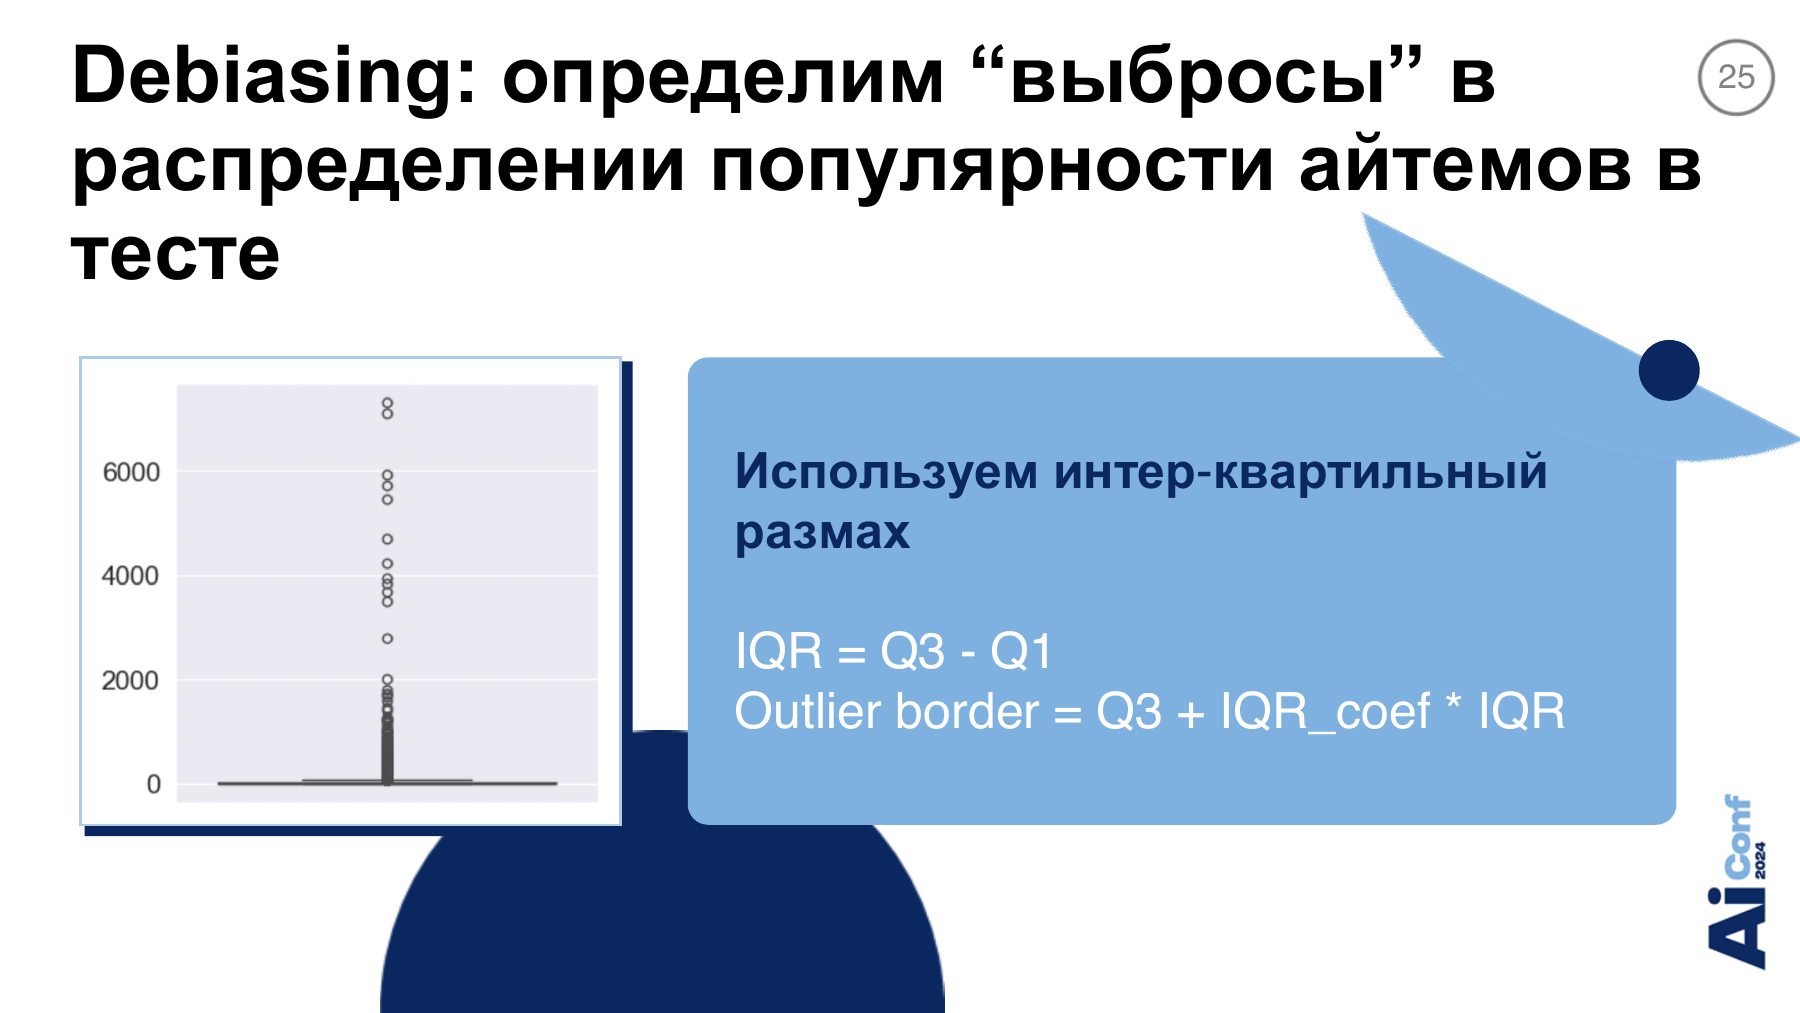
IQR = Q3 − Q1; граница = Q3 + IQR_coef × IQR. Коэффициент регулирует уменьшение влияния популярных объектов в тестовой оценке.
Источник: Дарья Тихонович · МТС · слайд 25Преобразование относится к тесту каждого фолда, а не к train
Временная валидация воспроизводит порядок появления данных: модель обучается на прошлом, а её рекомендации оцениваются по следующему временному отрезку. На схеме три фолда. Обучающий префикс расширяется, тестовое окно сдвигается вперёд; после них показан отдельный holdout, то есть дополнительный отложенный период проверки.
В каждом фолде частоты объектов и граница IQR рассчитываются по его собственным тестовым взаимодействиям. Из одного теста получают полный вариант и варианты для разных коэффициентов. В иллюстрации это Full test и Sampled test при iqr_coef = 3, 1 и 0,5, которым соответствуют отдельные результаты метрик.
Обучающая выборка не сокращается. В частности, удаление пары из оценки первого фолда не предписывает удалить её из исторических данных, доступных при обучении второго. Не требуется заново обучать одну и ту же модель только потому, что для её готовых рекомендаций считают метрику с другим IQR-коэффициентом.
На схеме сохраняется и обычная оценка на полном тесте. Поэтому debiasing здесь удобнее понимать как способ расчёта дополнительной метрики, а не как необратимую замену всей тестовой базы. Содержательно меняется множество взаимодействий, участвующих в конкретном расчёте.
Вывод из иллюстрации: граница преобразования проходит вокруг оценки отдельного тестового окна. Тестовая популярность не становится обучающим признаком или правилом пользовательской выдачи. Три фолда и holdout служат объяснительной схемой: докладчица отдельно отмечает, что полная кросс-валидация используется не в каждом сервисе, а точные разбиения экспериментов Ticketland здесь не заданы.
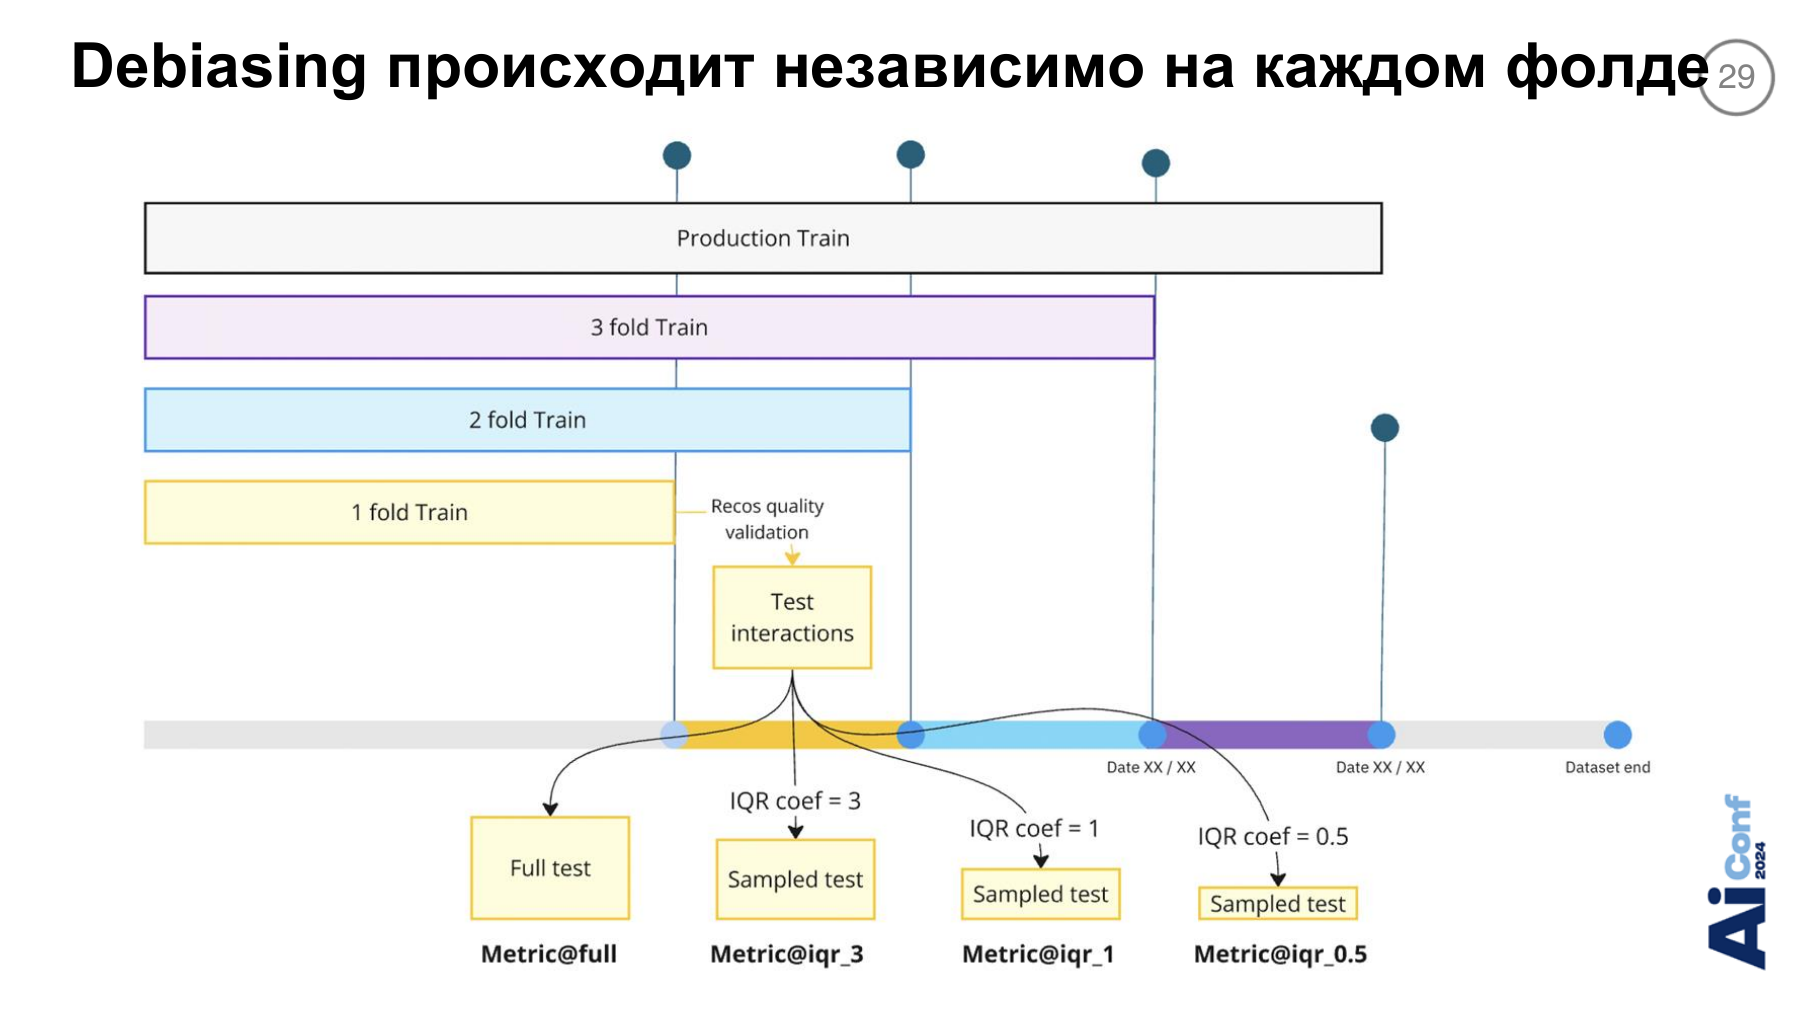
Популярность и сэмплирование считаются по тестовым взаимодействиям каждого фолда. Обучающую выборку этим шагом не меняют.
Источник: Дарья Тихонович · МТС · слайд 29Почему используют популярность в текущем тесте, а не во всей истории
После преобразования теста можно рассчитывать привычные метрики по попаданиям: NDCG, MAP, Precision, Recall, HitRate и другие. Их формула может оставаться прежней, но исходные положительные взаимодействия уже другие. Поэтому меняются значения и порядок моделей, который поддерживает такая оценка.
Источником идеи в презентации названа работа Cross Pairwise Ranking for Unbiased Item Recommendation. По изложению докладчицы, исходный подход использовал популярность объектов в полном датасете, случайную схему валидации и Inverse Propensity Scores. МТС адаптирует идею к временной проверке. Упоминание IPS описывает отличие исходной работы и не означает, что IPS применён в показанном эксперименте Ticketland.
У выбора частот именно из теста два основания. Во-первых, преобразование должно ограничить те выбросы, которые перевешивают в рассчитываемой метрике. Во-вторых, исторический хит и хит текущего тестового окна могут быть разными объектами. На данных KION показано, как популярность меняется по неделям: возникают новые пики, а прежние лидеры перестают доминировать.
Если ограничивать только исторически популярные объекты, новые тестовые хиты могут остаться нетронутыми. Именно поэтому статистика преобразования локальна для тестового окна. Это использование тестовых меток для определения оценки, а не разрешение передавать будущие взаимодействия в обучение или построение рекомендаций. На графике KION нет подписанных значений отдельных пиков, из которых можно было бы восстановить численный эффект изменения популярности.
Доклад · 00:11:03Совместимость с разными моделями не означает одинакового эффекта
Предложение относится к оценке моделей, обучающихся на истории взаимодействий. В перечне совместимых постановок есть коллаборативная фильтрация, гибридные модели, многоэтапные системы с отбором кандидатов и переранжированием, нейросети и современные для момента доклада архитектуры.
Общая точка подключения — готовые рекомендации и отложенные положительные взаимодействия, а не внутреннее устройство модели. Поэтому в первую очередь важен сценарий проверки: подходит ли продукту временное разделение и действительно ли его офлайн-метрики связаны с нежелательным смещением к популярному.
Докладчица предлагает рассматривать подход там, где есть эта проблема либо нужен компромисс с Serendipity. Перечень архитектур — область возможного применения, не серия экспериментов на каждой из них. Дальнейшие кривые для вариантов одного класса моделей не доказывают тот же эффект у любого рекомендательного алгоритма.
Доклад · 00:13:15Первый эксперимент Ticketland: 150 обученных вариантов и 84 для сравнения
Первое исследование остаётся целиком в офлайне. На данных Ticketland обучили 150 моделей с разными гиперпараметрами. В речи уточняется: это варианты одного класса моделей, а не 150 различных архитектур. Затем отсекли явно несошедшиеся варианты, которые не рассматривали бы как кандидатов для A/B.
Таблицу можно прокрутить по горизонтали.
Точные пороги отсечения и правило их совместного применения не раскрыты. Это фильтрация вариантов модели по качеству, а не исключение популярных объектов из обучения. Даунсемплинг тестовых взаимодействий — другая операция, которую далее используют для оценки оставшихся моделей.
Вопрос эксперимента: как разные степени debiasing меняют значения метрик и выбор лучшего варианта? Он не измеряет рост покупок и не является A/B. Класс модели, объём пользовательских данных, календарные периоды и точная схема разбиения этого эксперимента в докладе не названы.
Доклад · 00:13:45Две модели показывают, за счёт чего меняются Precision и Recall
Сначала из набора рассматриваются две модели с разной средней популярностью рекомендаций — Average Recommendation Popularity, или ARP. Эта характеристика описывает популярность объектов в выдаче, а не долю правильных рекомендаций.
Таблицу можно прокрутить по горизонтали.
Справа на графиках находится полный тест, слева — всё более сокращённый. Ось X называется Test share и показывает долю сохранённых тестовых взаимодействий. Без преобразования синяя модель выигрывает по Precision. Но значительная часть её попаданий приходится на хиты теста. Когда их вклад уменьшают, модель теряет много True Positives, и порядок двух кандидатов меняется.
Аналогичный результат показан для Recall. На первый взгляд это неожиданно: положительных взаимодействий стало меньше, поэтому их долю могло бы быть легче восстановить. Объяснение докладчицы связано с пользователями, у которых в тесте есть только одно или два взаимодействия, причём с популярными объектами. Попадание в хит даёт такой проверке очень лёгкий успешный случай. При даунсемплинге эти случаи могут исчезнуть вместе со всеми тестовыми позитивами пользователя.
Это не ухудшение уже обученных весов: изменилась оценка тех же рекомендаций на другом наборе взаимодействий. Формула и нормировка ARP, значения K и точные значения Precision и Recall в каждой точке графиков не раскрыты. Из ARP нельзя делать проценты популярного контента, а из кривых — таблицу неподписанных численных эффектов.
Доклад · 00:14:30На 84 моделях связь метрик с популярностью меняет знак
Следующий график рассматривает уже все 84 оставленных варианта. Для каждой степени преобразования команда сопоставляет порядок моделей по офлайн-метрике с порядком по Average Recommendation Popularity. Это корреляция между характеристиками моделей, а не корреляция между отдельными пользователями.
Без debiasing на графике подписана сильная положительная ранговая корреляция 0,88. Модели, получающие высокую оценку по попаданиям, обычно имеют и более популярную выдачу. При сильном преобразовании подписан противоположный ориентир −0,93: теперь оценка предпочитает модели с меньшей средней популярностью.
В легенде перечислены hit, precision, recall, ndcg, mrr, map, pap и pauc. Их кривые ведут себя сходно на данном наборе. Под графиком отмечены iqr_coef = −1, iqr_coef = 0,5 и отсутствие debiasing; сама горизонтальная ось остаётся долей сохранённого теста. Значение 0,5 в подписи коэффициента не означает автоматически сохранение ровно половины взаимодействий.
Вывод из иллюстрации: сила ограничения тестовых хитов меняет предпочтение офлайн-критерия по отношению к популярности выдачи. Подписанные 0,88 и −0,93 характеризуют показанный эксперимент; это не точные значения каждой кривой и не обещание такого же перехода у любой модели. Корреляция 0,88 также не означает полного совпадения двух ранжирований.
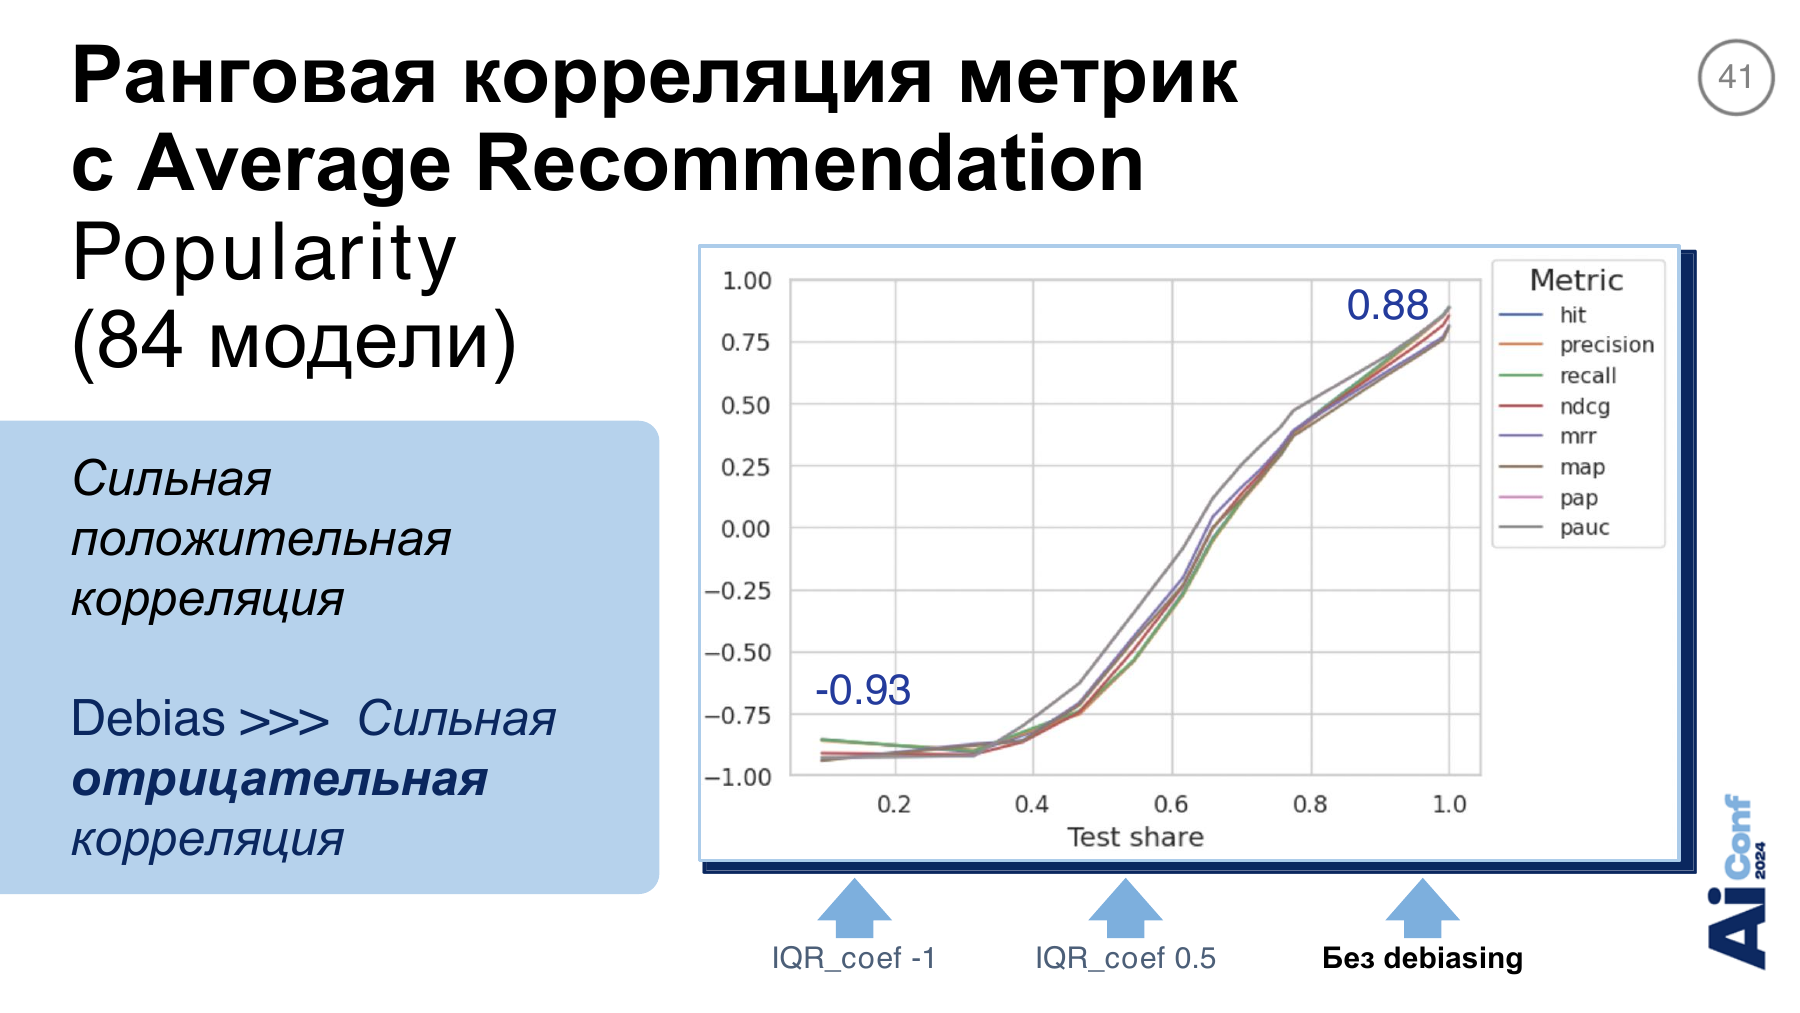
На 84 моделях снижение доли тестовых взаимодействий меняет ранговую корреляцию со средней популярностью. Это сравнительный офлайн-эксперимент, не бизнес A/B.
Источник: Дарья Тихонович · МТС · слайд 41Связь с Serendipity меняется в противоположную сторону
На тех же 84 моделях проводится второе сопоставление: теперь порядок по каждой метрике сравнивается с порядком по Serendipity. Без преобразования связь сильная отрицательная; на графике подписано −0,92. То, что выигрывает по обычной оценке попаданий, часто проигрывает по второй стороне качества.
При усилении даунсемплинга связь становится положительной; подписанный ориентир — 0,86. Таким образом, метрика по попаданиям начинает предпочитать модели, которые выше оцениваются и по Serendipity. Как и на предыдущем графике, отмечены режимы −1 и 0,5 для iqr_coef, а по оси X отложена Test share.
Здесь нет математического равенства между Precision и Serendipity. Изменяется их согласованность как критериев ранжирования конкретного набора моделей. Подписи не устанавливают одно точное значение для всех метрик из легенды и не превращают Serendipity в измеренную конверсию.
Вывод из иллюстрации: через тестовое распределение можно сдвигать офлайн-цель в сторону предпочтений Serendipity, не заменяя её формулой этой метрики. Но максимальное сглаживание не становится автоматически лучшим решением для бизнеса: оно может слишком сильно предпочесть редкую выдачу.
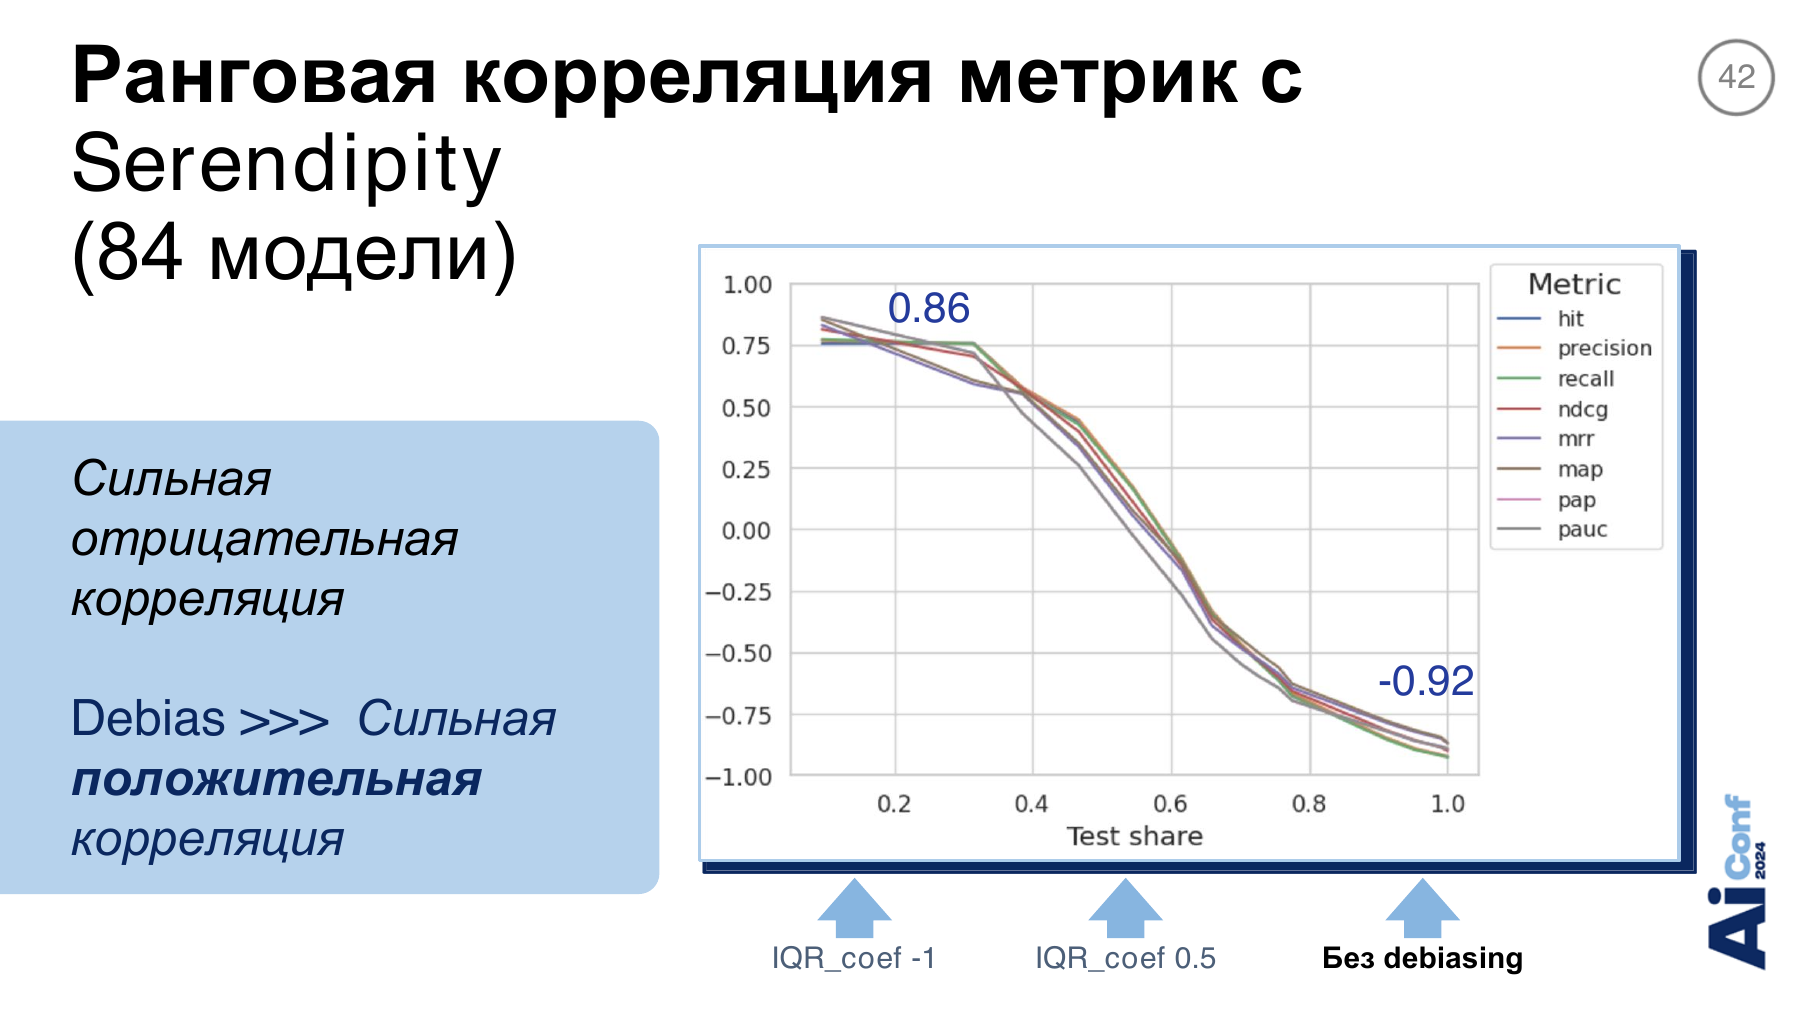
На тех же 84 моделях меняется связь с Serendipity. Сильное сглаживание популярности меняет оптимизационную цель; оно не автоматически полезнее для бизнеса.
Источник: Дарья Тихонович · МТС · слайд 42IQR-коэффициент выбирает компромисс между Precision и Serendipity
После анализа корреляций команда возвращается к диаграмме моделей в координатах Precision и Serendipity. Для каждого коэффициента выбирают вариант с максимальным debiased-Precision. На исходном графике эти победители выделены красным.
Подписаны коэффициенты 0, 0,5, 1, 10, 20 и 50. При меньшем коэффициенте тестовые хиты ограничиваются сильнее и выбирается вариант с большей Serendipity. При увеличении коэффициента ограничение ослабевает, и выбор сдвигается в сторону большей Precision. Числа рядом с красными точками — настройки iqr_coef, не значения метрик.
В этом эксперименте выбранные варианты находятся на показанном Парето-фронте. Поэтому один настраиваемый критерий позволяет выбирать разные компромиссы, а не просто максимизировать популярность или непопулярность. Утверждение относится к рассмотренному набору кандидатов, а не к теореме о любом распределении моделей.
Вывод из иллюстрации: настройка коэффициента меняет модель, которую предпочитает оценка. Она не переставляет объекты в уже готовой выдаче сама по себе. Чтобы выбрать продуктово полезную точку между двумя крайностями, далее понадобятся результаты A/B; «Happy users» на схеме баланса — цель, а не отдельная измеренная метрика.
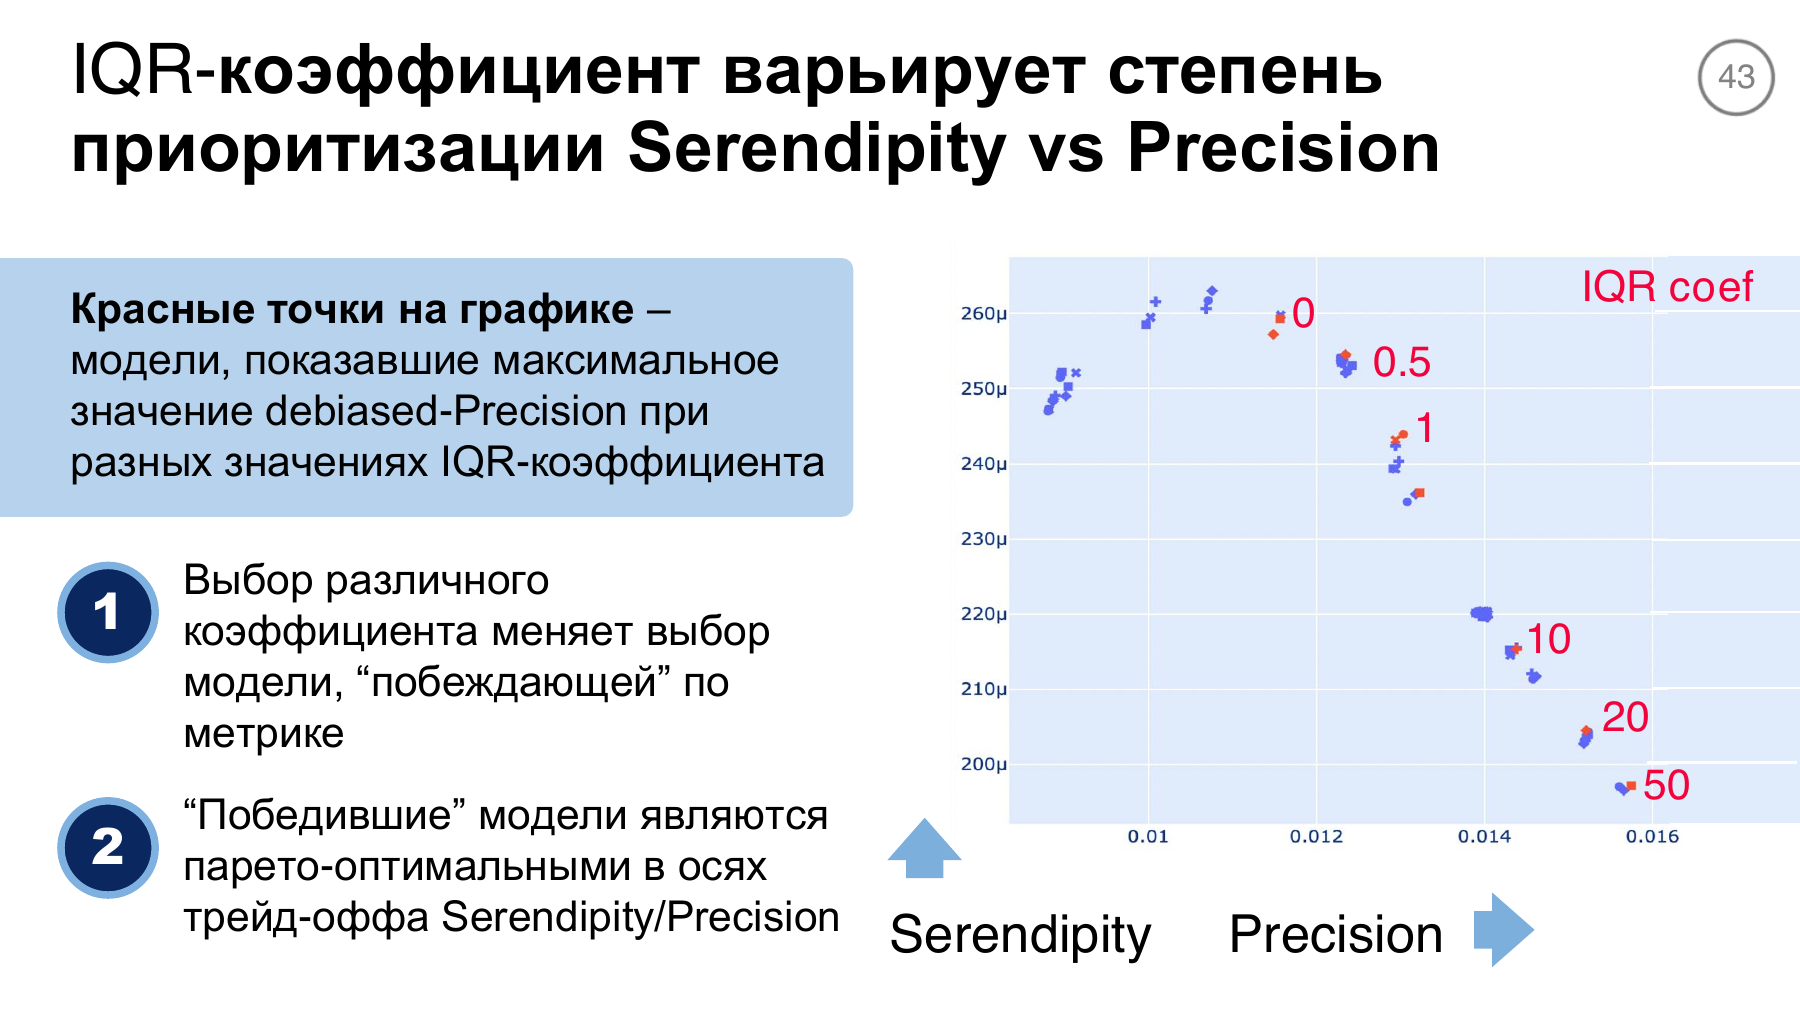
Разные IQR-коэффициенты выбирают разные модели на показанном фронте. Нужная степень популярности определяется продуктовой целью.
Источник: Дарья Тихонович · МТС · слайд 43Второй эксперимент: прошедшие A/B e-mail-рекомендаций Ticketland
Второе исследование связывает офлайн-оценку с конкретным сценарием работающего продукта: персональными рекомендациями мероприятий в e-mail-рассылках Ticketland. Онлайн-цель — конверсия в покупку. На слайде указано количество моделей в A/B: 4, а также статистически значимый прирост в каждом тесте.
Модели с известными онлайн-результатами заново оценивают офлайн, после чего сравнивают их метрики с конверсией. Это ретроанализ: новый способ оценки не участвовал в получении уже состоявшихся покупок. Название «Эксперимент 2: Онлайн» указывает на происхождение бизнес-результата, а не на новый A/B самого debiasing.
Четыре — размер набора моделей для этого сопоставления, не число пользователей, писем или фолдов. Его нельзя подменять 84 вариантами из первого исследования или предполагать, что именно эти четыре были отобраны из тех 84. Полный дизайн отдельных A/B и связь двух наборов моделей не описаны.
Доклад · 00:20:51От максимальной ранговой корреляции 0,8 к 43 совпадающим конфигурациям
Сначала для четырёх моделей рассчитывают обычные офлайн-метрики с разными значениями K. Максимальная показанная ранговая корреляция с конверсией равна 0,8. Значит, ни один рассмотренный обычный вариант не воспроизводит онлайн-порядок полностью.
Затем перебирают 27 вариантов метрик и 15 вариантов iqr_coef. На слайде совокупность названа примерно 400 debiased-метриками. Среди этих сочетаний 43 имеют ранговую корреляцию с конверсией, равную 1. Это 43 конфигурации «метрика плюс коэффициент», а не 43 разных рекомендателя или 43 независимых подтверждения в A/B.
Единица означает совпадение порядка на имеющемся наборе моделей. Она не означает, что офлайн-оценка численно равна конверсии или безошибочно предскажет следующий эксперимент. Конкретный вид рангового коэффициента в презентации не назван, поэтому его нельзя автоматически обозначать именем определённого статистического критерия.
Появление многих совпадающих вариантов создаёт следующую задачу: выбрать одну цель для дальнейшего поиска гиперпараметров. Команда решает её не единственным максимумом, а последовательным пересечением нескольких критериев.
Доклад · 00:21:27Почему выбрали PartialAUC, хотя максимум Pearson у другой строки
Ранговая корреляция отвечает за согласованность порядка моделей. Корреляция Пирсона дополнительно сопоставляет численные значения офлайн-метрики и конверсии. Команда использует оба сигнала и учитывает, при скольких коэффициентах сохраняется правильный порядок.
- 01
Устойчивость к степени преобразования
Отобрать метрики, для которых ранговая корреляция равна 1 при нескольких IQR-коэффициентах. На слайде 48 выделены семь строк с тремя или четырьмя такими настройками.
- 02
Высокая корреляция Пирсона
Составить отдельный топ сочетаний метрики и коэффициента по Pearson с конверсией в покупку. На слайде 49 выделены восемь верхних строк таблицы.
- 03
Пересечение
Оставить кандидатов, которые удовлетворяют обоим отборочным критериям. В показанном пересечении остаются pap_3 и pauc_3.
- 04
Финальный выбор
Из пересечения выбрать итоговую метрику по Pearson. На слайде 51 выделена pauc_3 при iqr_coef = −0,25.
Таблицу можно прокрутить по горизонтали.
Глобальный максимум в этой таблице — 0,882 у map_3_by_k при iqr_coef = −0,25. Но map_3_by_k даёт единичную ранговую корреляцию при двух коэффициентах и не входит в выделенный первый топ устойчивости. Поэтому итоговая процедура не эквивалентна выбору максимума Pearson среди всех строк.
У выбранной pauc_3 значение Pearson равно 0,877. У другого финалиста, pap_3 с тем же коэффициентом, на слайде также стоит 0,877. Докладчица объясняет финальный выбор корреляцией Пирсона, но показанная точность чисел не позволяет доказать строгое численное превосходство одного финалиста над другим. Неокруглённые значения и дополнительное правило разрешения равенства не приведены.
Вывод из иллюстрации: PartialAUC выбрана сочетанием требований, а не потому, что 0,877 — наибольшее число всей таблицы. «Устойчивость» здесь означает согласованность при нескольких степенях даунсемплинга на тех же ретроданных; это не проверка на новых моделях, независимых A/B или разных случайных сэмплах.
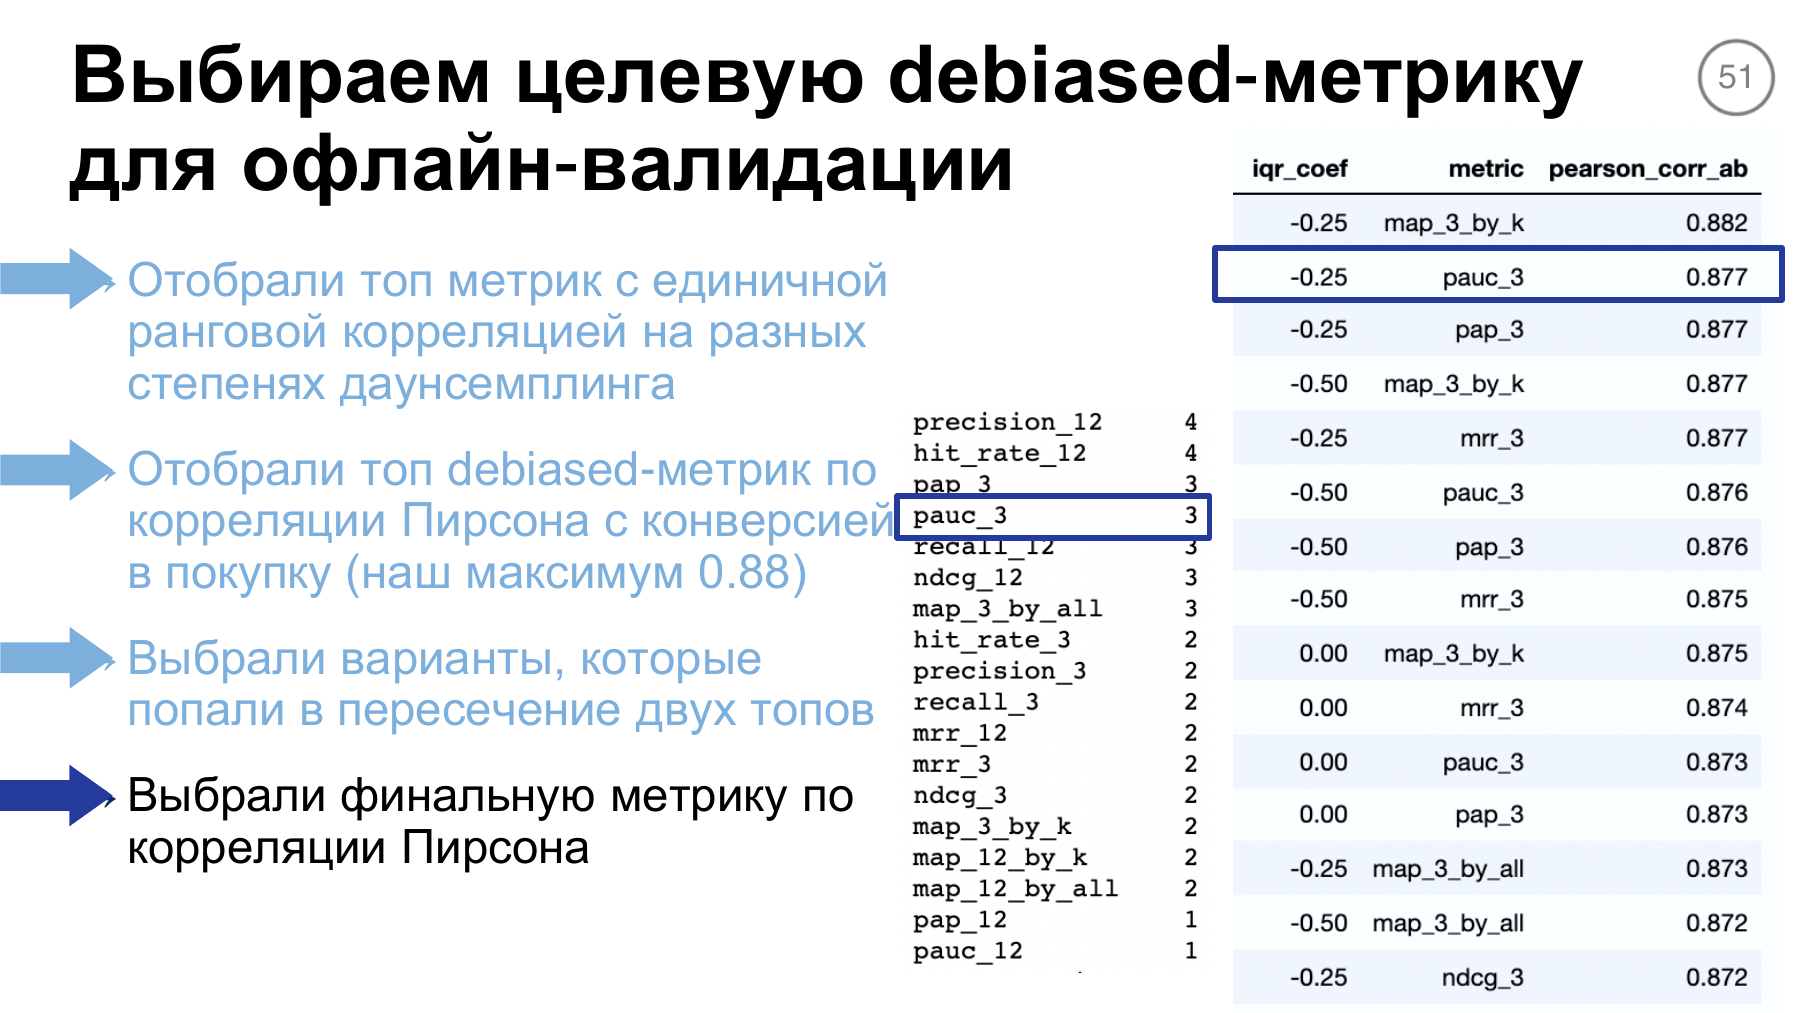
Устойчивость ранговой корреляции, связь Пирсона с конверсией и пересечение кандидатов рассматриваются совместно. Глобальный максимум 0,882 не равен окончательному выбранному 0,877.
Источник: Дарья Тихонович · МТС · слайд 51Итоговая настройка Ticketland и её проверенный результат
Итоговая конфигурация — PartialAUC@3 с iqr_coef = −0,25. Она сочетает конкретное определение метрики, рассматриваемое ниже, и конкретную степень преобразования тестовых взаимодействий. Выбирать только название PartialAUC без коэффициента означало бы потерять существенную часть принятого решения.
Таблицу можно прокрутить по горизонтали.
Из формулы порога следует, что при −0,25 граница равна 0,75 × Q3 + 0,25 × Q1. Это алгебраическое пояснение настройки, а не отдельное измеренное число взаимодействий. Значения квартилей не опубликованы; расположение границы относительно медианы конкретного распределения нельзя объявлять общим свойством всех тестовых наборов.
Вывод из иллюстрации: получен критерий, согласованный с имеющимся ретронабором, а не завершённая гарантия для следующих запусков. План на слайде — отправлять больше моделей в A/B, расширять ретроанализ и точнее выбирать метрику через анализ корреляций.
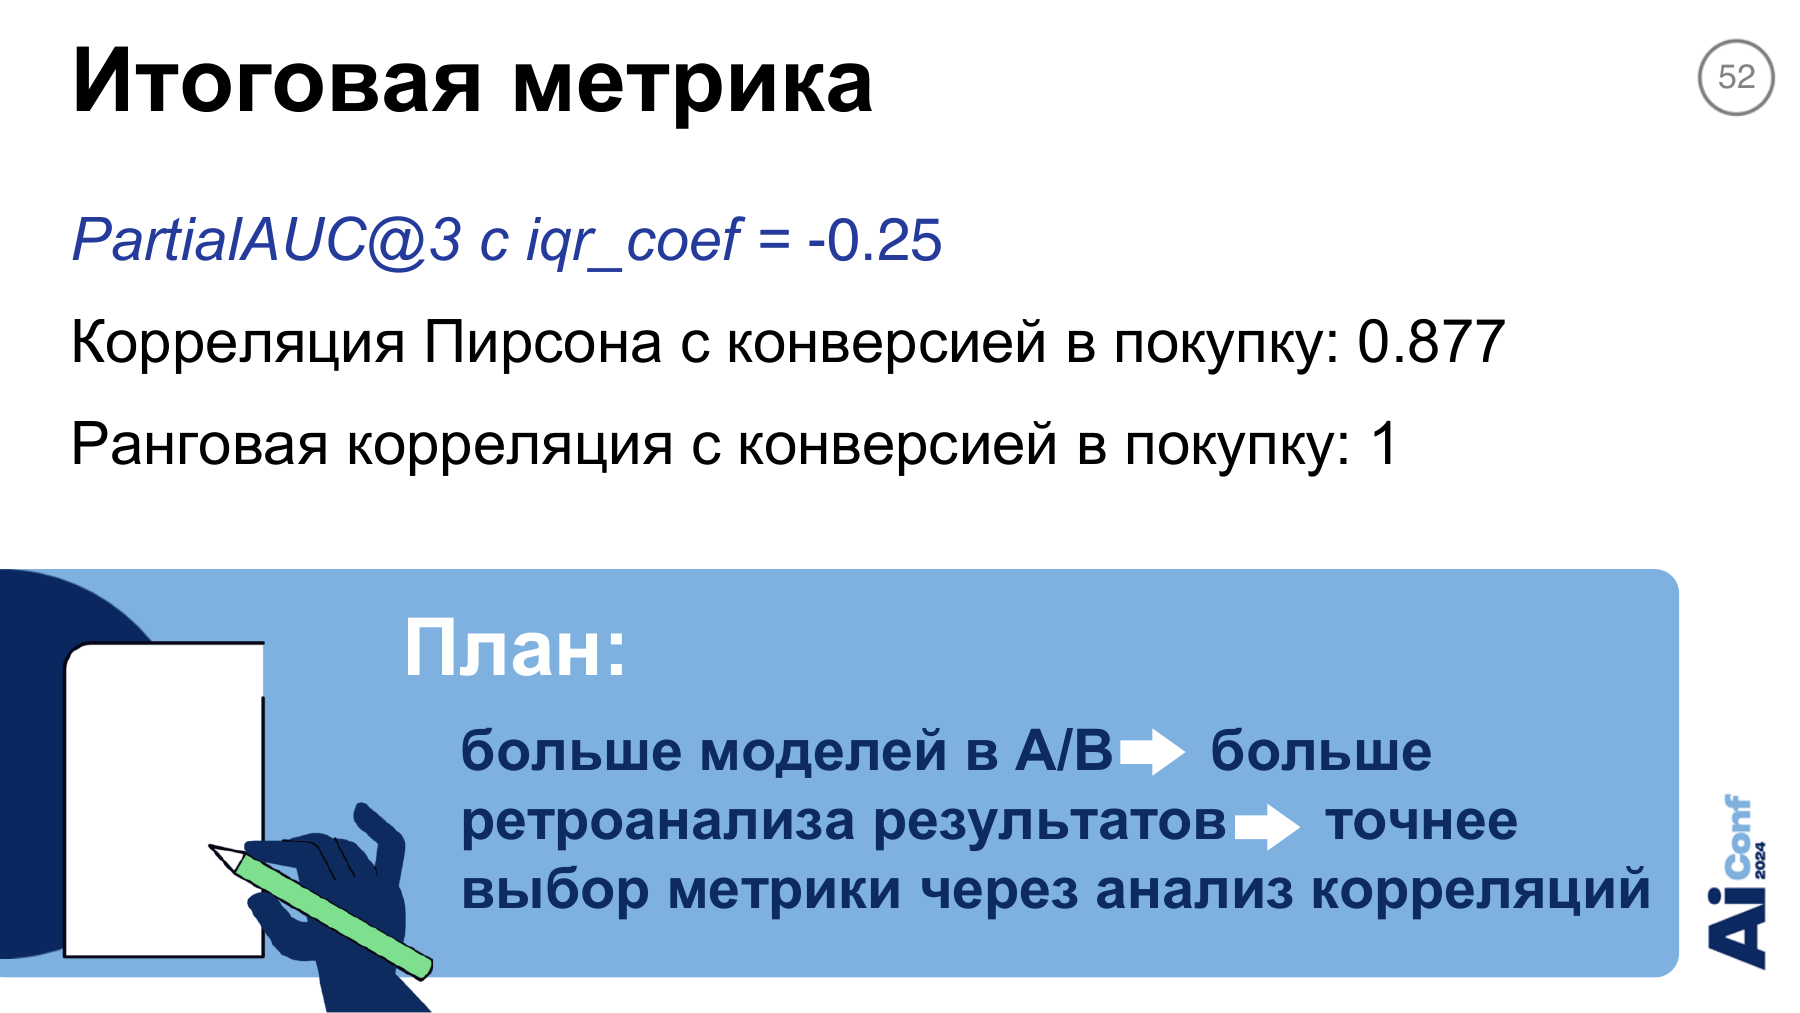
При iqr_coef = −0,25: Pearson с конверсией в покупку 0,877, ранговая корреляция 1. Это результат имеющегося набора A/B, а не гарантия на будущих моделях.
Источник: Дарья Тихонович · МТС · слайд 52Что означает усреднённый прирост ранговых корреляций +189%
После выбора iqr_coef команда сравнивает обычные и debiased-варианты всего рассматриваемого набора метрик при выбранной степени преобразования. На тепловой карте каждая колонка соответствует метрике, нижняя строка ORIGINAL — корреляции без преобразования, верхняя DEBIASED — после него.
На слайде заявлен прирост ранговых корреляций, усреднённый по всем метрикам, +189%. Объект усреднения — набор метрик, а не пользователи, покупки или отдельные запуски A/B. Базой остаётся сопоставление оценок тех же четырёх моделей с их конверсией.
Полная числовая таблица под тепловой картой и точная формула агрегирования приростов не приведены. Поэтому нельзя восстановить исходный и итоговый средний коэффициент, приписать +189% каждой метрике отдельно или решить по рисунку, усреднялись ли относительные изменения коэффициентов либо сравнивались их средние.
Вывод из иллюстрации: после преобразования многие офлайн-критерии лучше воспроизводят порядок известных онлайн-результатов. Это не рост покупок на 189% и не увеличение количества успешных A/B почти втрое.
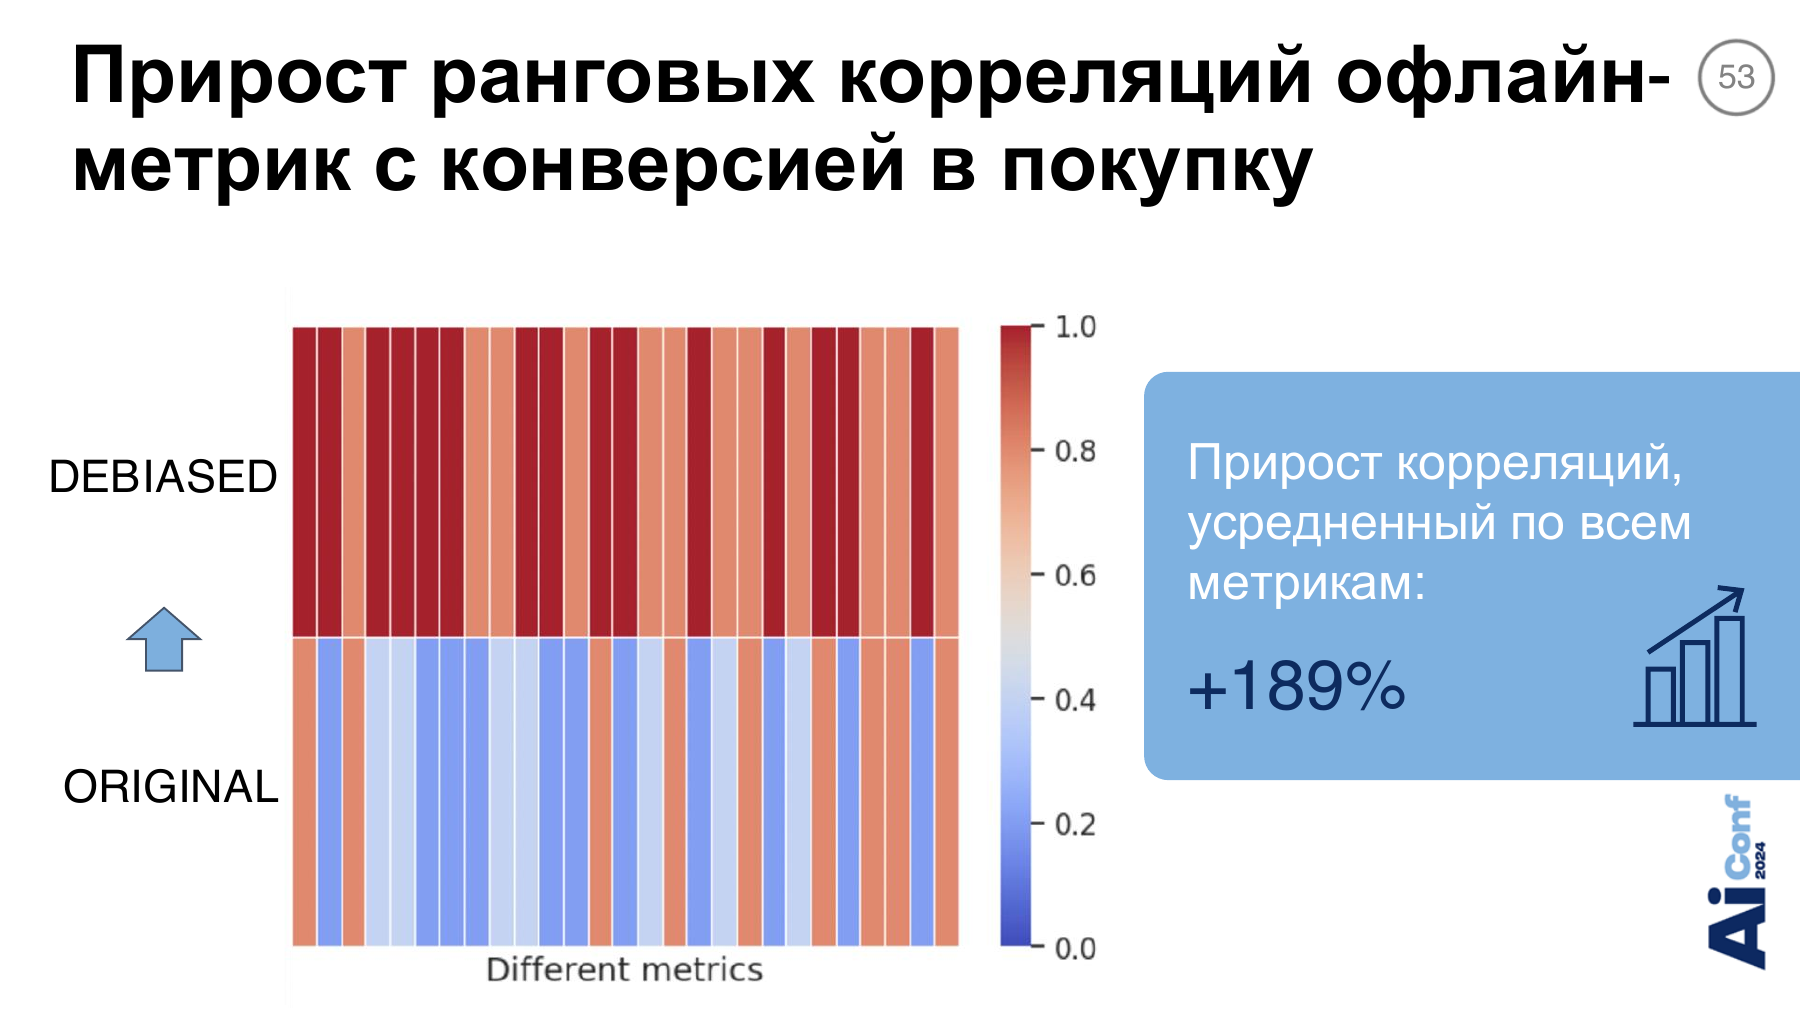
На слайде +189% усреднённого прироста ранговых корреляций офлайн-метрик с конверсией. Это не рост покупок на 189%.
Источник: Дарья Тихонович · МТС · слайд 53Почему +35% по Pearson — другой результат, а не бизнес-прирост
Вторая тепловая карта использует ту же логику ORIGINAL против DEBIASED, но показывает корреляции Пирсона. Заявленный прирост, также усреднённый по всем метрикам, равен +35%. Здесь сравнивается связь численных офлайн-оценок с конверсией, а не только порядок моделей.
Таблицу можно прокрутить по горизонтали.
Два процента нельзя складывать: они относятся к разным способам измерения связи. +35% также не означает увеличение каждого коэффициента на 0,35. Отдельные значения для всех колонок не подписаны, поэтому цветовая шкала не заменяет числовую таблицу.
Вывод из иллюстрации: при выбранном преобразовании улучшается не только согласованность ранжирования, но и измеренная связь значений офлайн-метрик с известной конверсией. Это остаётся ретроспективным результатом, полученным на наборе, использованном для выбора самой настройки.
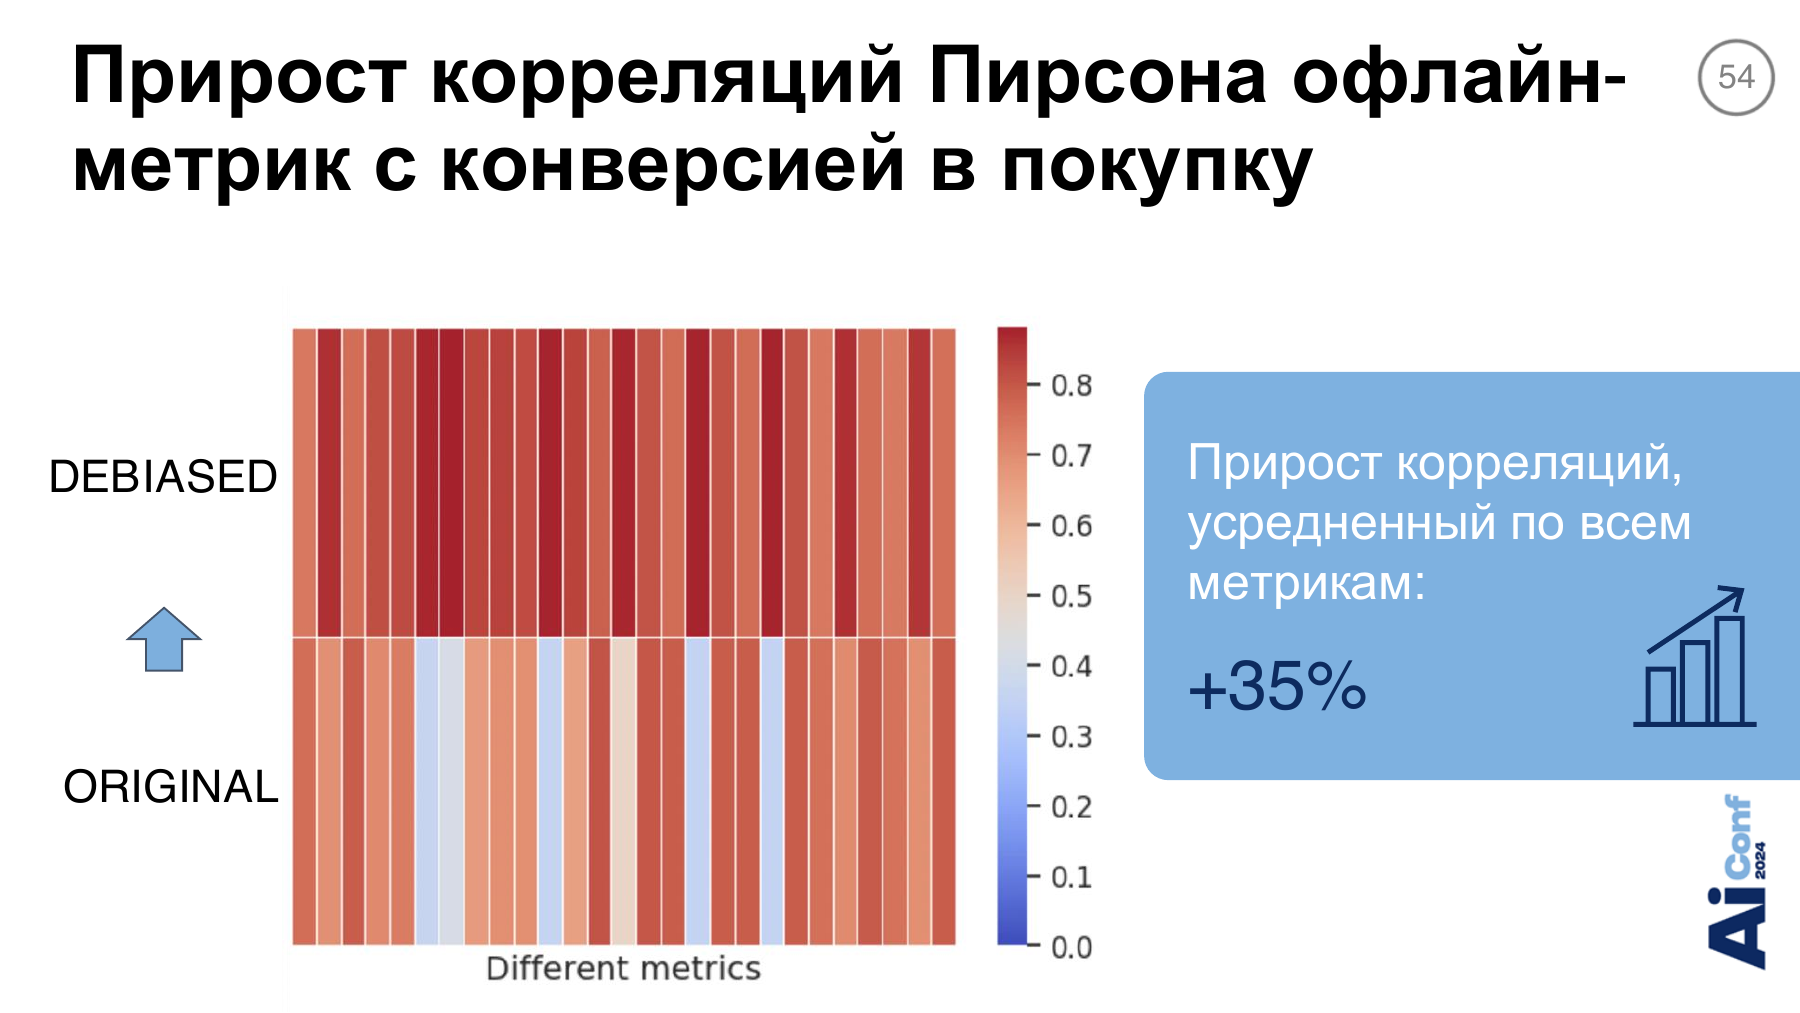
Отдельный показатель: +35% усреднённого прироста корреляций Пирсона. Его нельзя складывать с приростом ранговых корреляций.
Источник: Дарья Тихонович · МТС · слайд 54PartialAUC@k: все позитивы против первых k нерелевантных рекомендаций
Определение PartialAUC@k на слайде отличается от привычного прочтения «метрика на первых k рекомендациях». Берутся все положительные объекты пользователя в тесте — TP + FN — и первые k нерелевантных рекомендованных объектов, FP. На таком наборе рассчитывается ROC AUC.
TP — найденные положительные объекты, FN — положительные объекты, которые не были найдены в рассматриваемой выдаче. FP — предложенные объекты, нерелевантные по используемым тестовым меткам. Ограничение k применяется именно к FP. Положительные объекты между ними не расходуют это число, а пропущенные позитивы не исчезают из оценки.
Интуиция ROC AUC здесь — проверить, насколько модель располагает положительные объекты выше высоко стоящих нерелевантных рекомендаций. На учебной схеме слайда 55 первые три FP находятся на позициях 1, 2 и 4; два TP — на позициях 3 и 5. Дополнительно показаны четыре FN. Это объясняющий пример, а не статистика пользователей Ticketland.
Таблицу можно прокрутить по горизонтали.
Развёрнём расчёт по нарисованному порядку. Шесть позитивов сравниваются с тремя выбранными FP: получается 18 пар. TP на позиции 3 стоит выше FP на позиции 4 и даёт единственную выигранную пару. TP на позиции 5 находится ниже всех трёх FP; четыре FN также не добавляют выигрышей. На ROC-схеме этому соответствует один прямоугольник шириной 1/3 и высотой 1/6.
Раскрытие учебного примера со слайда 55: 3 выбранных FP и 6 позитивов, одна выигранная пара. Значение безразмерно; это не конверсия и не результат A/B.
Вывод из иллюстрации: для @3 здесь нужны первые три ошибки такого типа, а не первые три объекта всего списка. Расчёт 1/18 относится к показанному порядку без равных рангов. Правила обработки одинаковых оценок, недостатка FP, пользователей без позитивов и усреднения пользовательских значений на слайде не определены; учебный рисунок не задаёт все крайние случаи реализации.
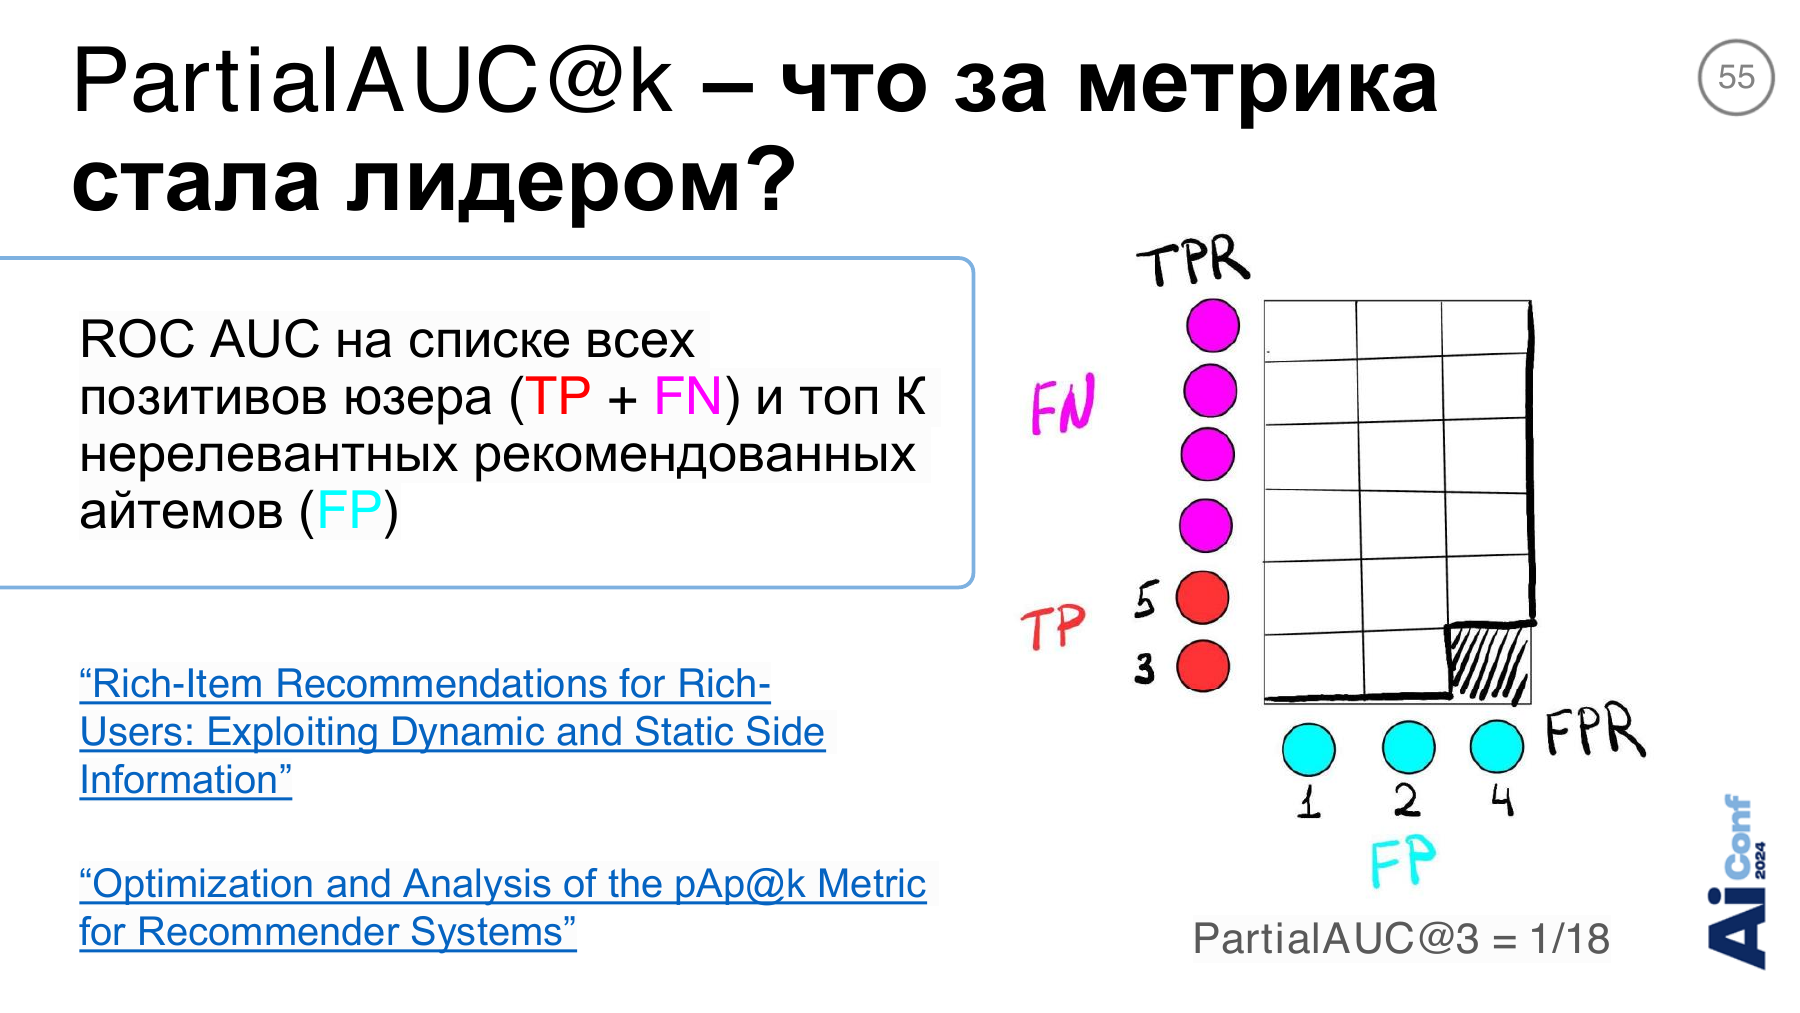
Все положительные объекты пользователя сравниваются с первыми k нерелевантными рекомендациями. Учебный пример даёт PartialAUC@3 = 1/18; k не означает первые три объекта всей выдачи.
Источник: Дарья Тихонович · МТС · слайд 55Что иллюстрация с одним попаданием объясняет о MAP и PartialAUC
Для сравнения поведения метрик автор показывает отдельный учебный пример: единственный True Positive перемещается по позициям от 1 до 10. Сравниваются map_10 и pauc_10. Это не результаты десяти моделей Ticketland и не десять значений бизнес-конверсии.
На диаграмме MAP особенно сильно падает при уходе попадания с первых позиций. PartialAUC снижается более равномерно. Интуитивно первая метрика сильнее сосредоточена на самом начале выдачи, а вторая продолжает заметно различать последующие положения положительного объекта.
Более равномерное снижение не означает безразличия к позиции: раннее попадание всё ещё лучше позднего. Докладчица связывает такую чувствительность с лучшей корреляцией на своём продукте, но диаграмма сама по себе не доказывает, что PartialAUC всегда лучше MAP. NDCG устно описывается как более близкая к MAP по поведению; отдельной численной таблицы для неё здесь нет.
На предыдущем слайде названы Rich-Item Recommendations for Rich-Users: Exploiting Dynamic and Static Side Information и Optimization and Analysis of the pAp@k Metric for Recommender Systems. Докладчица упоминает использование связанной комбинированной метрики в Microsoft. Это отсылка к внешнему опыту внутри доклада, не ещё один эксперимент МТС; формула pAp@k здесь не раскрыта.
Доклад · 00:25:43RecTools: обычная и debiased-оценка одних рекомендаций
На момент доклада RecTools предлагал готовые debiased-метрики, PartialAUC, временную кросс-валидацию и интерактивные инструменты анализа. Точка применения debias-config — инициализация метрики, а не изменение параметров рекомендательной модели.
Пример слайда 58 использует готовые таблицы рекомендаций и тестовых взаимодействий. Рядом рассчитываются обычная Precision@10 и её debiased-вариант. Ниже показана запись этого фрагмента на Python; имена и аргументы относятся к демонстрации 2024 года, а не к гарантии API актуальной версии.
from rectools.metrics import Precision, DebiasConfig, calc_metrics

debias_config = DebiasConfig(iqr_coef=1, random_state=32)
metrics = {
    "precision@10": Precision(10),
    "precision@10_debiased": Precision(10, debias_config),
}
calc_metrics(metrics, recommendations_df, test_interactions_df)
iqr_coef = 1 задаёт степень преобразования, random_state = 32 фиксирует случайность в показанной конфигурации. Эти значения иллюстрируют интерфейс и не заменяют выбранный для Ticketland коэффициент −0,25. Переменные с таблицами уже должны существовать: слайд не является самостоятельной программой подготовки данных.
По объяснению автора, одинаковая конфигурация debiasing позволяет не повторять одно и то же преобразование теста для каждой метрики. Это оптимизация вычисления оценок. В этом фрагменте нет обучения, повторной генерации выдачи для каждого коэффициента или добавления бизнес-правил в работающий рекомендательный сервис.
Доклад · 00:26:34Временная кросс-валидация в демонстрации RecTools
Следующий пример соединяет модели, датасет, временное разбиение и набор метрик. Он показывает, как оценка с debiasing встраивается в обычную офлайн-проверку. Демонстрационные настройки нельзя переносить задним числом в дизайн экспериментов Ticketland.
Таблицу можно прокрутить по горизонтали.
Обучение кандидатов на соответствующем прошлом и расчёт их оценок логически разделены. Debiasing относится к тестовым взаимодействиям при расчёте метрик. Само наличие EASEModel или item_features_df в примере не раскрывает класс и признаки моделей из первого исследования, а три окна по 14 дней не устанавливают его реальные временные границы.
Доклад · 00:27:31Виджеты помогают искать гипотезы, а не заменять измерения
Первый виджет, MetricsApp, предназначен для сравнения моделей по нескольким метрикам. На вход в примере передаются metrics_df и model_params_df. Можно выбрать метрику для каждой оси и посмотреть, как варианты располагаются относительно друг друга, в том числе с учётом гиперпараметров.
Второй инструмент, VisualApp, показывает историю пользователя и рекомендованные объекты. Демонстрационный вызов получает reco_df, items_df, train_df и n_random_users=2. Два случайных пользователя — параметр просмотра, не размер выборки проверки качества.
До перехода к debiasing команда выбирала компромисс метрик и дополнительно смотрела на конкретные рекомендации в таком виджете. Докладчица описывает визуальный анализ как источник гипотез: сначала заметить возможную проблему выдачи, затем проверить её на метриках и подтвердить либо отвергнуть. Впечатление от нескольких примеров не объявляется заменой офлайн-оценке или A/B.
Завершение блока инструментов отсылает к открытому репозиторию MobileTeleSystems/RecTools и установке пакета rectools. Это часть представленного в 2024 году инструментария, без дополнительных утверждений о его нынешних возможностях.
Доклад · 00:27:59Что команда считает результатом и что собирается уточнять
В заключительной части докладчица выделяет четыре полезных свойства подхода. Он даёт одну настраиваемую цель вместо раздельного выбора по попаданиям, популярности и Serendipity; позволяет регулировать предпочтение популярной выдачи уже при валидации; помогает искать связь с онлайн-метриками на небольшом наборе прошедших A/B; имеет простую открытую реализацию.
«Объединение» в одну цель здесь означает поведение метрики после преобразования теста. В докладе не предлагается сумма трёх показателей с обученными весами. Также не появляется обязательный новый шаг переранжирования: влияние на выдачу возникает через выбор другой модели или её гиперпараметров.
Автор оценивает саму идею как простую, которую можно реализовать за день, и указывает на RecTools. Это оценка сложности подхода, а не замер полного внедрения в любой продукт. Отдельных чисел стоимости, ускорения расчёта или времени промышленной интеграции нет.
Следующий исследовательский шаг — больше моделей в A/B, больше ретроанализа и уточнение целевой метрики по накопленным корреляциям. Вопросы из зала показывают, что вместе с этим нужно понимать влияние случайного отбора на пользователей и различие между улучшением ретроспективного сигнала и доказанным улучшением будущего отбора.
Доклад · 00:29:12Вопрос из зала: что делать с категориями и брендами маркетплейса
Первый содержательный вопрос касается переноса на маркетплейс. У разных категорий, брендов и вариантов товара могут быть естественно разные распределения популярности. Если применить одну общую процедуру, не сократит ли она некоторые группы слишком сильно? Слушатель предлагает рассмотреть стратификацию, то есть отдельный учёт таких групп при преобразовании.
Ответ начинается с уточнения постановки рекомендаций. Товар и его цветовые варианты можно представлять по-разному: сначала выбирать товар, а затем вариант, либо организовать задачу иначе. Поэтому эффект группового преобразования зависит и от того, что считается отдельным объектом модели.
Готового решения для стратификации докладчица не предъявляет. Она подчёркивает отличие e-commerce от своего контентного домена и подтверждает, что этот вопрос команда не исследовала из-за отсутствия такой доменной необходимости. Возможность попробовать метод в маркетплейсе не является результатом проверки на категориях, брендах или цветах.
Доклад · 00:30:59Вопрос из зала: стало ли больше успешных A/B
Слушатель возвращает обсуждение к исходной бизнес-проблеме. Если раньше выбранная офлайн модель нередко не выигрывала в A/B, насколько часто отбор стал правильным после изменения метрики? Это другой вопрос, чем рост корреляций на уже имеющихся данных.
Докладчица повторно поясняет устройство результата: взяты модели, которые уже участвовали в A/B; их заново оценили разными офлайн-метриками и сопоставили эти оценки с конверсией тех же моделей. После debiasing корреляции получились выше. Именно к этому расчёту относятся +189% и +35%.
После уточняющих вопросов звучит прямое ограничение: статистики доли положительных A/B после применения подхода на момент выступления нет. Ретроанализ завершён незадолго до доклада; команда начала применять подход в контентных сервисах и ожидает более согласованного отбора, но продолжит уточнять метрики.
Таким образом, показанный результат — более сильный ретроспективный сигнал, который решено использовать для дальнейшей работы. Доклад не содержит измерения «доля успешных A/B до и после», не устанавливает причинный эффект изменения валидации на покупки и не подтверждает, что корреляция сохранится на следующей серии моделей.
Доклад · 00:32:42Вопрос из зала: у каких пользователей удаляются взаимодействия
Следующий вопрос касается механики даунсемплинга. У активного пользователя удаление части взаимодействий может почти не изменить возможность оценки. У пользователя с коротким тестовым профилем та же операция способна удалить все положительные примеры. Следовательно, важно не только сколько взаимодействий убрать у объекта, но и чьи именно взаимодействия попадут в удалённую часть.
В описанном варианте использован равномерный случайный выбор: для этой операции пользователи считались одинаковыми. Специального правила сохранения коротких профилей не было предъявлено. Докладчица прямо подтверждает, что отдельные пользователи могли полностью выпасть из преобразованного теста.
В своём домене она считает допустимым убрать тривиальную проверку пользователя, взаимодействовавшего только с популярным объектом. Это связано с ранее объяснённым снижением Recall: исчезают лёгкие случаи полного попадания. Но такая оценка допустимости — позиция автора для рассматриваемой задачи, а не измеренное отсутствие вреда для всех малоактивных пользователей.
Важное следствие: меняется не только частота объектов, но иногда и состав пользователей, по которым считается итоговая оценка. Отдельного исследования пользовательских сегментов, числа выпавших профилей или чувствительности результата к случайному выбору в докладе нет.
Доклад · 00:36:10Вопрос из зала: можно ли понижать веса вместо удаления
Последнее предложение — сохранить тестовые взаимодействия, но уменьшать их вклад весами. Для объекта, чья частота выше допустимой границы, каждое взаимодействие получало бы пропорционально меньший вес. Мотивация — не терять случайно всех позитивов отдельных пользователей.
Докладчица называет идею перспективной и говорит, что команда думает о таком продолжении. Реализация, сравнение со случайным удалением и результаты взвешенных метрик не показаны. Поэтому это направление дальнейшей работы, а не уже использованный механизм получения Pearson 0,877.
Слушатель предполагает и вычислительное упрощение. Автор не ожидает большого изменения стоимости для своей реализации. В обсуждении также нет доказательства численной эквивалентности весов и даунсемплинга для всех ранжирующих метрик: замена способа учёта взаимодействий потребовала бы собственного определения оценки и проверки.
Доклад · 00:37:25Границы корректного прочтения результата
Debiasing в этом кейсе намеренно меняет распределение, на котором сравниваются модели. Поэтому его результат нужно читать как другую офлайн-цель, а не как автоматически более точное измерение среднего качества на исходном пользовательском потоке. Ниже собраны ограничения показанной процедуры и методологические следствия её устройства; это не дополнительные эксперименты команды.
Таблицу можно прокрутить по горизонтали.
Ретронабор описан как набор со статистически значимым приростом в каждом A/B. Он не даёт отдельного измерения способности новой метрики отсеивать будущих проигрывающих кандидатов. Размеры аудиторий, доверительные интервалы корреляций и статистическая неопределённость выбора метрики не представлены.
Причинный вывод также ограничен устройством исследования: покупки в прошедших A/B уже состоялись до пересчёта оценок. Улучшение их корреляции с офлайн-метриками не могло само по себе увеличить эти покупки. И, наконец, даунсемплинг теста не становится обязательным шагом формирования рекомендаций для каждого пользовательского запроса.
Доклад · 00:09:36Итог: как работает выбранная процедура офлайн-оценки и отбора
В кейсе МТС меняется не архитектура рекомендателя, а критерий, по которому выбирают его лучший вариант. Тестовые хиты могут вознаграждать популярную выдачу сильнее, чем полезную персонализацию. Ограничение их вклада создаёт другую офлайн-цель; для e-mail-рекомендаций Ticketland команда выбрала PartialAUC@3 с iqr_coef = −0,25.
- 01
Принять данные проверки
Для каждого временного фолда используются его исходные тестовые взаимодействия и рекомендации кандидатов, обученных только на предшествующей истории.
- 02
Определить предел популярности
По частотам объектов внутри этого теста вычисляются Q1, Q3 и граница Q3 − 0,25 × (Q3 − Q1).
- 03
Подготовить оценочный тест
У объектов выше границы случайно сокращается число взаимодействий до допустимого предела. Исходные обучающие данные остаются неизменными.
- 04
Рассчитать метрики
Готовые рекомендации оцениваются по PartialAUC@3 на преобразованном тесте; обычные метрики полного теста могут рассчитываться рядом.
- 05
Выбрать кандидата
Результаты предусмотренных временных проверок используются для сравнения моделей и выбора варианта по зафиксированной офлайн-цели.
Обучение остаётся отдельным процессом подготовки кандидатов. Изменение коэффициента оценки не требует обучать модель заново, а даунсемплинг не включается обязательной операцией в каждый пользовательский запрос. После офлайн-отбора полезность кандидата проверяется в A/B.
В ретроанализе четырёх моделей выбранная настройка дала Pearson 0,877 и ранговую корреляцию 1 с конверсией. Это не глобальный максимум таблицы Pearson и не доказанный рост доли успешных будущих тестов. Следующие шаги команды — расширять набор A/B и уточнять оценку; влияние выпадения пользователей, стратификация и переход к весам остаются открытыми вопросами.
Доклад · 00:09:36