Разбор готов
Lamoda: как персонализировали каталог и перенесли решение в рекомендации
Покупатель открывает каталог Lamoda, выбирает категорию, размер или бренд и листает товары. Сервис должен не только показать подходящие вещи в начале, но и сохранить возможность просмотреть весь доступный ассортимент. Прежнее ранжирование учитывало интересы крупных групп покупателей; следующий шаг — менять порядок товаров для конкретного человека в момент запроса. В докладе AiConf 2024 Дана Злочевская рассказывает, как команда добавила отдельный сервис персонализации, проверила его в каталоге и перенесла общие компоненты в рекомендации «С этим товаром покупают». Здесь важны не только положительные результаты: готовая каталожная модель ухудшила рекомендации, а для учёта последних действий пользователя понадобилось менять сбор обучающих данных.
Материал полезен специалистам по рекомендательным системам, ML-инженерам и разработчикам, которые соединяют обучение модели с быстрым ответом пользовательского сервиса. На одном кейсе разобраны два уровня ранжирования, актуальность признаков, перенос между продуктами и ограничения оценки по сохранённым показам.
Видео · на русском
Новый уровень ML-персонализации Lamoda: как мы усилили ее в каталоге / Дана Злочевская (AiConf 2024)Открыть оригинальные слайдыДана Злочевская · Опубликовано: 12 марта 2026 г.
Исходный доклад · Открыть оригинал
Почему важен не только поиск конкретной вещи
По клиентским исследованиям, на которые ссылается Дана, 40% пользователей приходят в Lamoda просто посмотреть предложения, без конкретной цели покупки. Поэтому подходящий контент нужен не только в каталоге, но и в рекомендациях, рекламных товарах и подборках на главной. Размер выборки и период этого исследования не приведены.
На обзорном слайде масштаб описан через месячную активную аудиторию — MAU, количество товаров и нагрузку на сервис каталога. RPS обозначает число запросов в секунду. Время ответа дано на 95-м процентиле, p95: это характеристика распределения задержек, а не среднее время.
Таблицу можно прокрутить по горизонтали.
Из этих чисел следует продуктовый приоритет: особенно важно качество начала каталога, хотя возможность долгого просмотра убирать нельзя. Сопоставлять 17 млн MAU с 8 млн авторизованных как две оценки одной аудитории неверно. Так же нельзя переносить 500 мс p95 на модель второго уровня: внутри ответа каталога есть и другие операции.
Кейс относится к выступлению 27 сентября 2024 года на AiConf 2024. Запись опубликована на YouTube 12 марта 2026 года. Дальше слова «работает», «тестируется» и «планируется» описывают состояние на момент выступления, а не состояние системы в 2026 году.
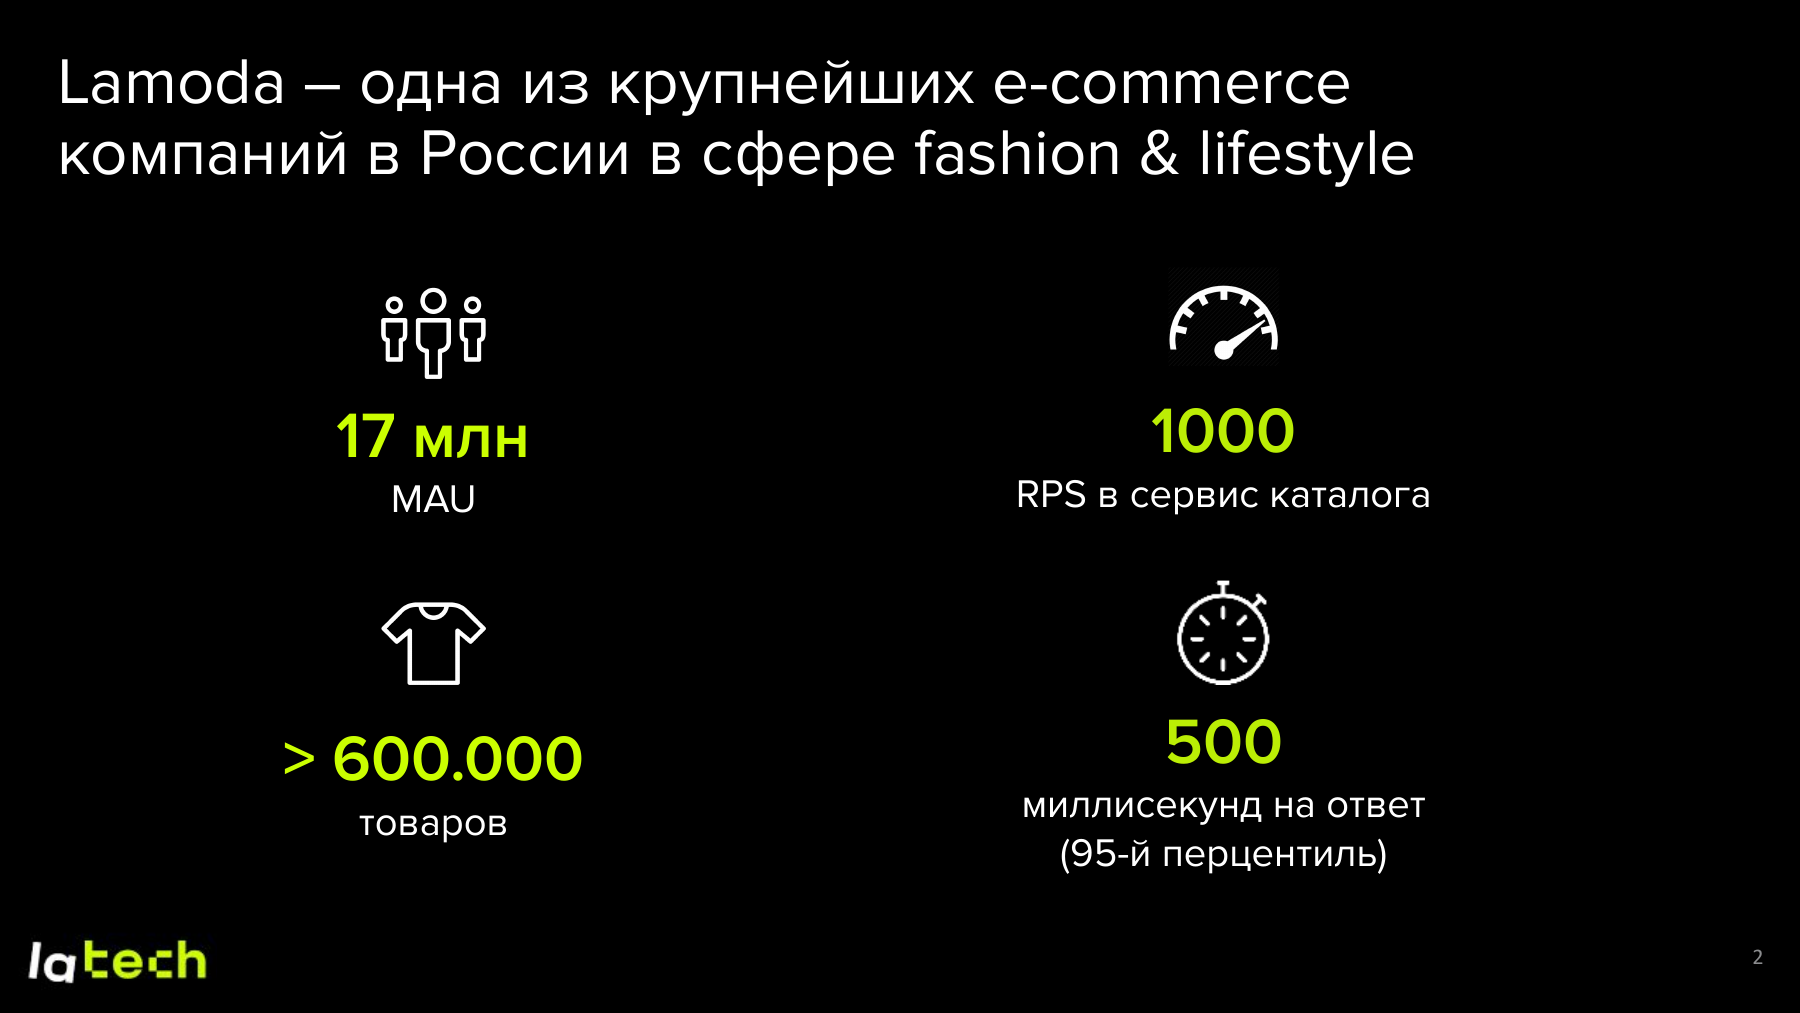
17 млн MAU, больше 600 тысяч товаров, 1 000 RPS сервиса каталога и 500 мс p95 ответа — масштаб, описанный на момент выступления AiConf2024.
Источник: Дана Злочевская · Lamoda · слайд 2От общего порядка к персональному каталогу
В каталоге пользователь может задать поисковый запрос, категорию, размер, бренд или цвет. Наряду с режимом «Подобрано для вас» есть сортировки по цене, скидкам и новинкам. Разбираемое решение касается персонального порядка товаров; из доклада не следует, что модель произвольно меняет смысл всех остальных сортировок.
Ранжирование — это упорядочивание подходящих товаров. В рекомендательной полке можно отдать небольшой список и остановиться. В каталоге нужно сохранить переход между страницами, то есть пагинацию, и возможность просмотра тысяч результатов. Если ограничениям покупателя удовлетворяют 10 000 товаров, система должна поддерживать порядок всего этого множества.
К началу описываемой работы команда уже умела заранее строить ранжирование для крупных сегментов. Поверх него формулы балансировали склонность товара к конверсии, маржинальность и доступность. Индивидуальная модель не появилась вместо пустого каталога: её добавили к существующему порядку и продуктовым ограничениям. Интервал 2024–2025 на шкале не означает, что к сентябрю 2024 года все показанные направления уже были завершены.
Доклад · 00:01:39Почему порядок стали пересчитывать при запросе
Один вариант — заранее оценивать товары для каждого пользователя и сохранять готовую выдачу. Это офлайн-персонализация. Другой — применять обученную модель тогда, когда пользователь запрашивает каталог. Это онлайн-персонализация; слово «онлайн» здесь описывает момент применения модели, а не частоту её обучения.
Таблицу можно прокрутить по горизонтали.
Для Lamoda проблема предварительного расчёта связана с разнообразием запросов: пользователь меняет категорию, фильтры и поисковую фразу. Заранее подготовить подходящий персональный порядок для всех сочетаний непросто. Команда выбрала вычисление при запросе, приняв дополнительную нагрузку на пользовательский путь.
Главный вывод из сравнения — возможность учитывать свежий контекст, а не доказательство, что все свежие сигналы уже подключены. В работающей версии исторические признаки обновлялись раз в сутки. Данные о последних кликах и добавлениях в корзину оставались следующим шагом, хотя сам сервис уже ранжировал онлайн.
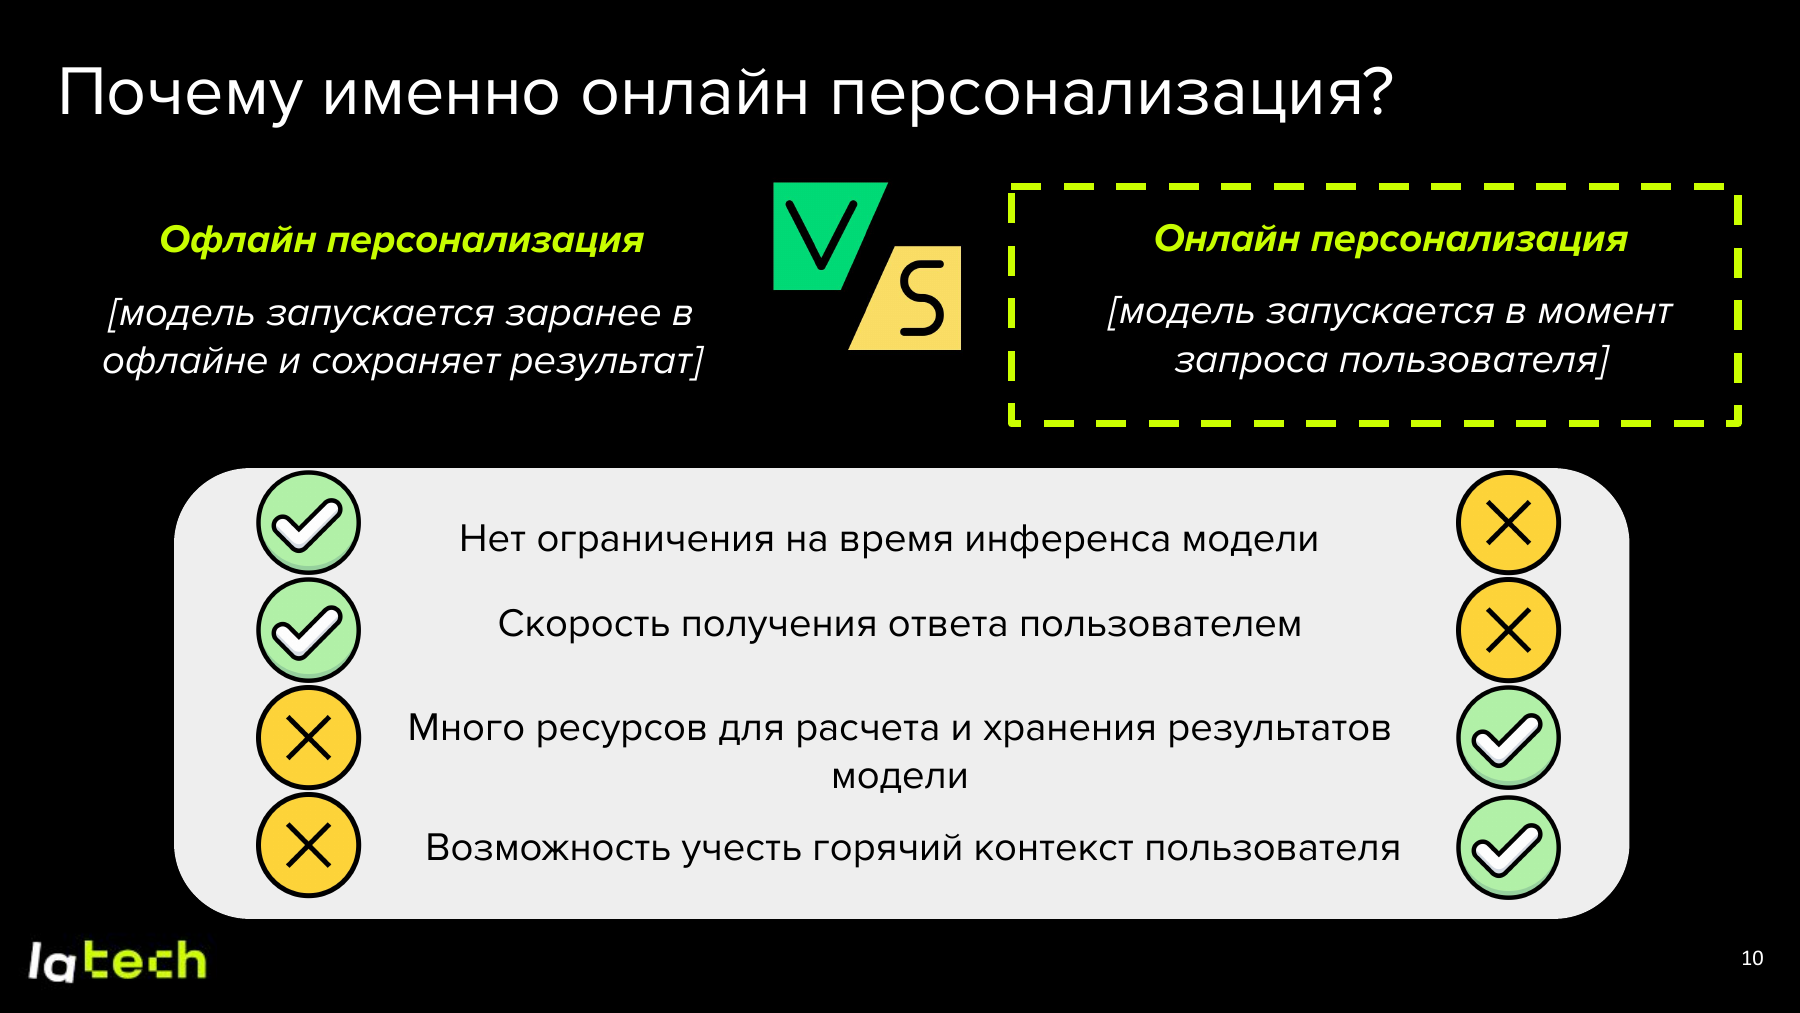
Сравнение заранее рассчитанной выдачи с ранжированием в момент запроса: задержка, вычисления, хранение и возможность учитывать текущий контекст.
Источник: Дана Злочевская · Lamoda · слайд 10Первый уровень: фильтры, популярность и лёгкая персонализация
Перед более дорогой моделью система быстро выбирает товары, которые имеет смысл оценить подробнее. Это отбор кандидатов. В Lamoda первый уровень работает в Elasticsearch: туда ежедневно загружают заранее рассчитанное ранжирование, а сам движок обеспечивает фильтрацию и переход между страницами.
Базовый порядок отражает популярность внутри крупных групп пользователей. К нему добавлена лёгкая персонализация с помощью механизма изменения оценки в Elasticsearch — function_score. По объяснению Даны, выше поднимаются товары, атрибуты которых совпадают с предпочтениями покупателя. Формула и её коэффициенты не приведены.
Вопрос из зала уточняет, зачем поисковый движок нужен при открытии категории без текстового запроса. Ответ связан не только с поиском по словам: движок должен возвращать отфильтрованные результаты с разными смещениями по каталогу. Первый уровень заранее охватывает весь каталог по сегментам, а ограничения конкретного пользователя накладываются при запросе.
На схеме между всем каталогом и финальным верхом выдачи стоит около 10 000 товаров. Это обозначение промежуточного множества, а не подтверждённый жёсткий предел системы. Оно не означает ни персональное оценивание всех 10 000 вторым уровнем, ни предварительное исключение остальных товаров из базового ранжирования.
Доклад · 00:05:30Почему выбрали собственный сервис, а не плагин поиска
Второй уровень меняет порядок уже отобранных товаров для конкретного пользователя. Такое повторное ранжирование называют переранжированием, а сервис на схемах — Service Reranker. В качестве места выполнения команда сравнила расширение поискового движка и отдельный сервис.
Таблицу можно прокрутить по горизонтали.
Выбор собственного сервиса связан с ожидаемым развитием системы. Команда хотела добавлять признаки, которые собираются из нескольких источников, и дополнительные правила порядка товаров. Важна и независимость от источника кандидатов: впоследствии это позволило использовать те же компоненты в рекомендациях.
Диапазон 100–10 000 товаров на слайдах выбора реализации описывает рассматриваемую задачу ранжирования. Это не результат нагрузочного теста и не фактический размер второго уровня в опубликованных экспериментах: там отдельно указаны 150 и 300 кандидатов.
Доклад · 00:06:18Два процесса: подготовка модели и ответ покупателю
В пользовательском запросе основной сервис каталога сначала обращается в Elasticsearch. Получив кандидатов первого уровня, он передаёт их верхнюю часть в отдельный Go-сервис Reranker. Тот получает данные о пользователе и товарах, вычисляет совместные признаки и применяет CatBoost — модель, которая выдаёт оценку товара по этим признакам. Применение уже обученной модели называют инференсом.
Исторические признаки подготавливают отдельно, заранее. На полной схеме данные находятся в Hadoop HDFS, пакетный расчёт признаков выполняется с помощью Spark, а результаты для быстрого чтения поступают в Aerospike. Персональные предпочтения и исторические товарные признаки обновляются один раз в сутки. Обучение модели также происходит ежедневно; расписание организовано через Airflow.
Парный признак описывает не только пользователя или товар по отдельности, а их соответствие: например, есть ли у кандидата размер, который обычно выбирает этот покупатель. Такие признаки сервис собирает в момент запроса, соединяя заранее подготовленные предпочтения с доступной текущей информацией о товаре.
На схеме важна граница между двумя путями. Spark, HDFS и обучение не выполняются заново при каждом открытии каталога. В ответе покупателю участвуют подготовленная модель, чтение нужных данных и вычисление совместных признаков. Поэтому ежедневное обновление истории совместимо с онлайн-ранжированием, но само по себе не даёт реакции на только что сделанный клик.
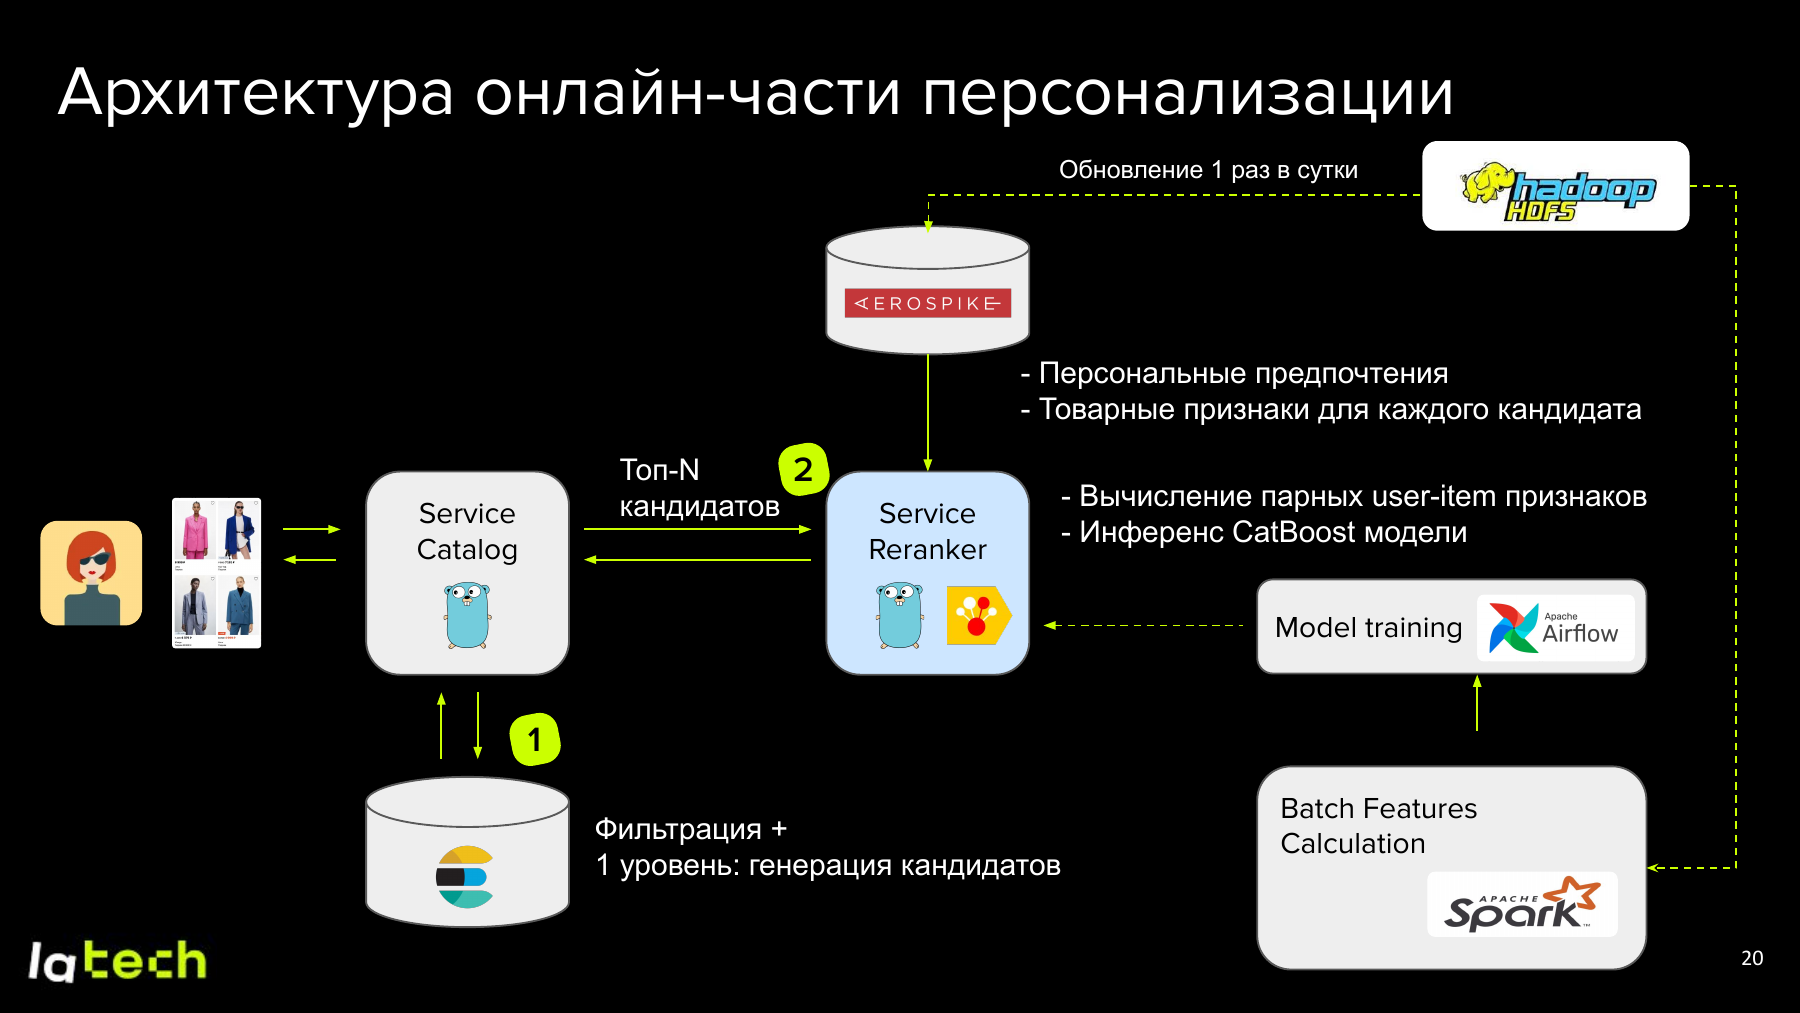
Elasticsearch отбирает кандидатов; отдельный Go-сервис считает парные признаки и запускает CatBoost. Исторические признаки обновляются ежедневно, обучение выполняется отдельным контуром.
Источник: Дана Злочевская · Lamoda · слайд 20Чему учат CatBoost и что означают важности признаков
Обучающие примеры берут из реальных показов: пользователь действительно увидел товар на экране. Список кандидатов, который сервер вернул приложению, сам по себе не считается списком показанных товаров. Это различие особенно важно, когда модель сортирует сотни кандидатов, а человек просматривает только небольшую часть.
Целевое действие — добавление в корзину, cart_add. В fashion-каталоге товар должен не только понравиться, но и быть доступным в подходящем размере. Клик выражает интерес, однако не гарантирует возможность покупки. Поэтому команда выбрала более близкое к покупке действие, не утверждая, что оно равнозначно завершённому заказу.
На вход модели поступает features(item, user_id): контекстные, пользовательские, товарные и совместные признаки. Для обучения используется CatBoost с функцией потерь YetiRank — критерием обучения ранжированию. Качество порядка проверяют на сохранённых данных по NDCG@60, метрике верхних 60 позиций. Это офлайн-оценка, не количество покупок и не процент правильных рекомендаций. Два признака на графике описывают конверсию из показа в действие; в подписях она сокращена до CR.
Таблицу можно прокрутить по горизонтали.
График показывает, что модель использует и историю реакции на товар, и персональные предпочтения. Числа 15, 12, 8, 5, 5 и 4 не являются причинными долями бизнес-эффекта; метод вычисления и нормировка важностей не раскрыты. Указанные 60 дней относятся к двум признакам конверсии, а не к доказанной длине всего обучающего окна.
Команда пробовала более сложные целевые метки: офлайн-метрики росли, но результата в A/B-тесте пока не получила. Формулы этих меток не приведены. Также не раскрыты разделение данных на обучение и проверку, правила выбора отрицательных примеров, окно связывания показа с корзиной и параметры обучения. Эти ограничения не позволяют воспроизвести эксперимент только по презентации.
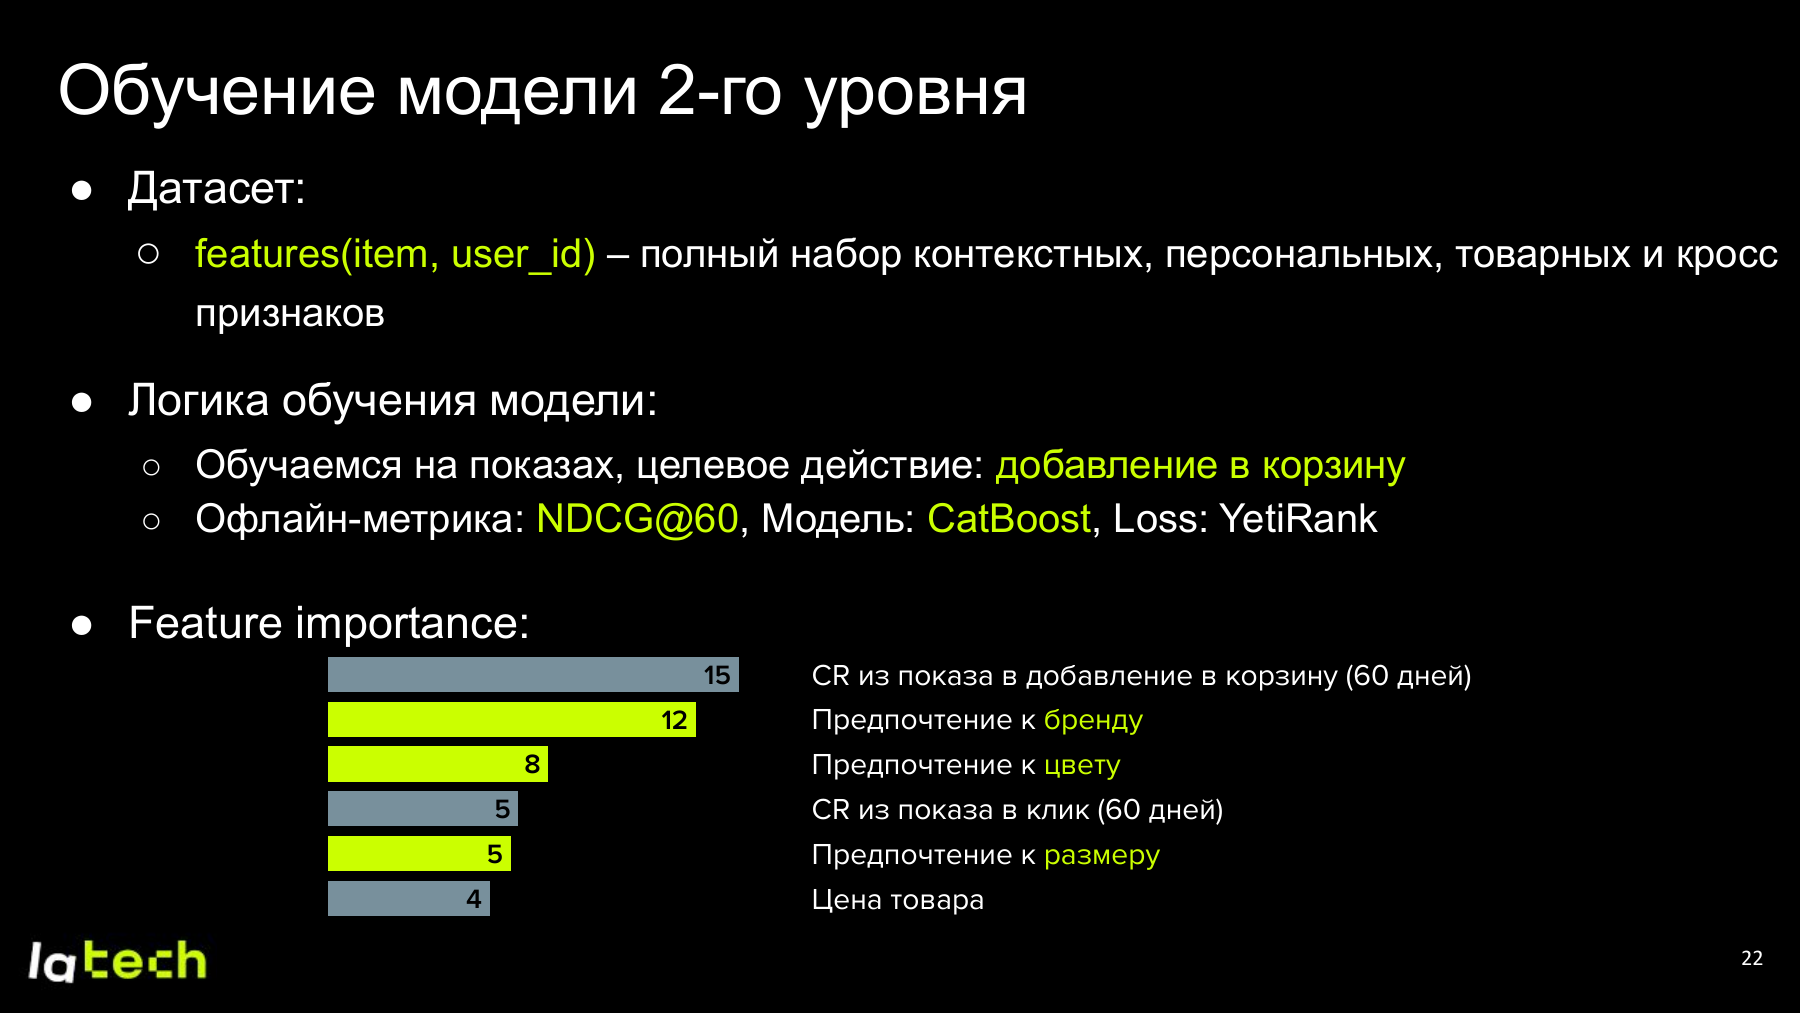
Обучение на показах с целевым действием добавления в корзину, YetiRank и оценкой NDCG@60. Важность признаков на графике не означает причинное влияние.
Источник: Дана Злочевская · Lamoda · слайд 22Что уже учитывалось онлайн, а что ещё нет
В примере каталога известны предпочтения пользователя к LIME и MANGO, розовому и голубому цветам, а также размеру XS. После второго уровня подходящие бренды и цвета поднимаются выше. Это иллюстрация изменения порядка для одного профиля, а не самостоятельное доказательство среднего эффекта на аудитории.
В ответе на вопрос о действительно актуальных признаках Дана выделяет наличие размеров. Для некоторых товаров остатки быстро расходятся, поэтому предпочтение к размеру нужно сопоставлять с тем, что можно заказать именно сейчас. Также названы платформа, с которой пришёл пользователь, и страна.
Таблицу можно прокрутить по горизонтали.
Здесь онлайн-персонализация уже полезна без полностью свежей пользовательской истории: модель соединяет долгосрочные предпочтения с текущим товарным контекстом. Но объяснять результаты каталожных тестов внедрением признаков последних действий нельзя — автор отдельно говорит, что их ещё предстоит подключить.
Доклад · 00:10:30Два A/B-теста каталога: разные изменения, разные результаты
В каталоге систему проверили в A/B-тестах — сравнении вариантов работающего продукта по поведению пользователей. Первый эксперимент добавлял модель второго уровня для верхних 150 кандидатов. Во втором использовали уже 300 кандидатов и расширили применение модели. В рассказе уточняется, что она стала работать в том числе в поисковых сессиях и получила дополнительные признаки.
Таблицу можно прокрутить по горизонтали.
Слайд подтверждает положительное изменение обеих показанных метрик в обоих опытах. Он не даёт основания сложить +3% и +1%, перемножить приросты или заключить, что 300 кандидатов хуже 150. Второй тест меняет несколько условий сразу, а полный состав контрольных вариантов не описан.
В исходнике используются знак процента и названия «Добавления в корзину» и «Покупки». Абсолютные базы, знаменатели метрик, способ нормирования и единица рандомизации не раскрыты. Поэтому значения не переводятся в процентные пункты, долю покупающих пользователей, GMV или выручку. Также отсутствуют размер выборки, длительность и доверительные интервалы. Автор называет тесты успешными, но отдельный эффект числа кандидатов из этих данных не выделить.
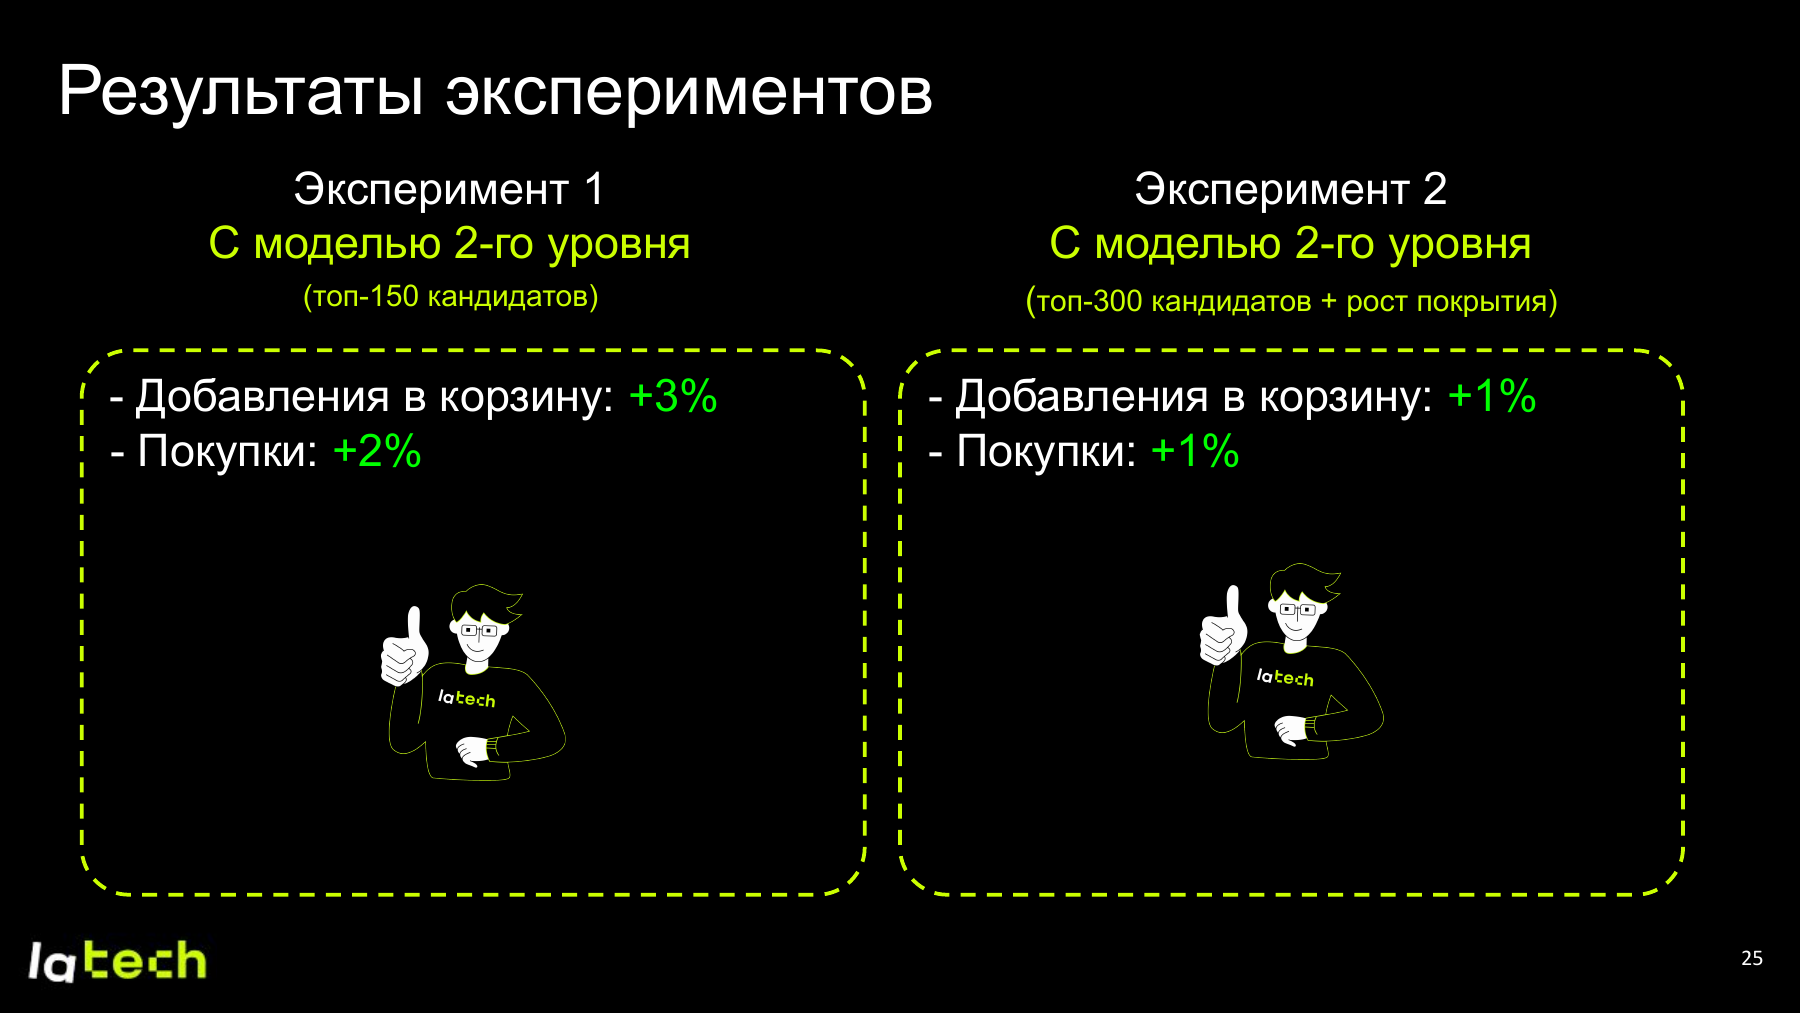
Топ150: +3% добавлений в корзину и +2% покупок. Топ300 с расширением покрытия: +1% и +1%. Два эксперимента нельзя складывать или выдавать за сравнение одинаковых условий.
Источник: Дана Злочевская · Lamoda · слайд 25Что общее у каталога, рекомендаций и рекламы
После каталожных экспериментов команда рассмотрела другие места показа товаров. На карточке товара есть полки «Похожие», «С этим товаром покупают» и образы. В каталоге присутствуют рекламные предложения брендов; в рассказе в качестве типичных рекламных мест названы второе и третье. Это разные продуктовые задачи, но каждая передаёт на ранжирование некоторый список товаров.
В рекомендациях появляется дополнительная сущность: товар, карточку которого сейчас смотрят. Он называется якорным товаром; на слайде используется обозначение «якорный sku». Хорошая рекомендация должна учитывать не только интерес пользователя, но и отношение кандидата к этому товару.
Таблицу можно прокрутить по горизонтали.
В устном объяснении для рекламы дополнительно упоминается информация о рекламной кампании. Из таблицы следует возможность задать различия через источники кандидатов, наборы признаков и источники показов. Однако общий формат задачи ещё не означает, что один обученный файл модели подходит всем продуктам.
Ожидаемая польза унификации — быстрее запускать персонализацию, не дублировать код и переносить удачные признаки между командами. Сокращение времени до запуска, T2M, заявлено как цель, а не измерено в днях. Само перечисление рекламы и полок не означает, что новый второй уровень уже внедрён во всех этих местах.
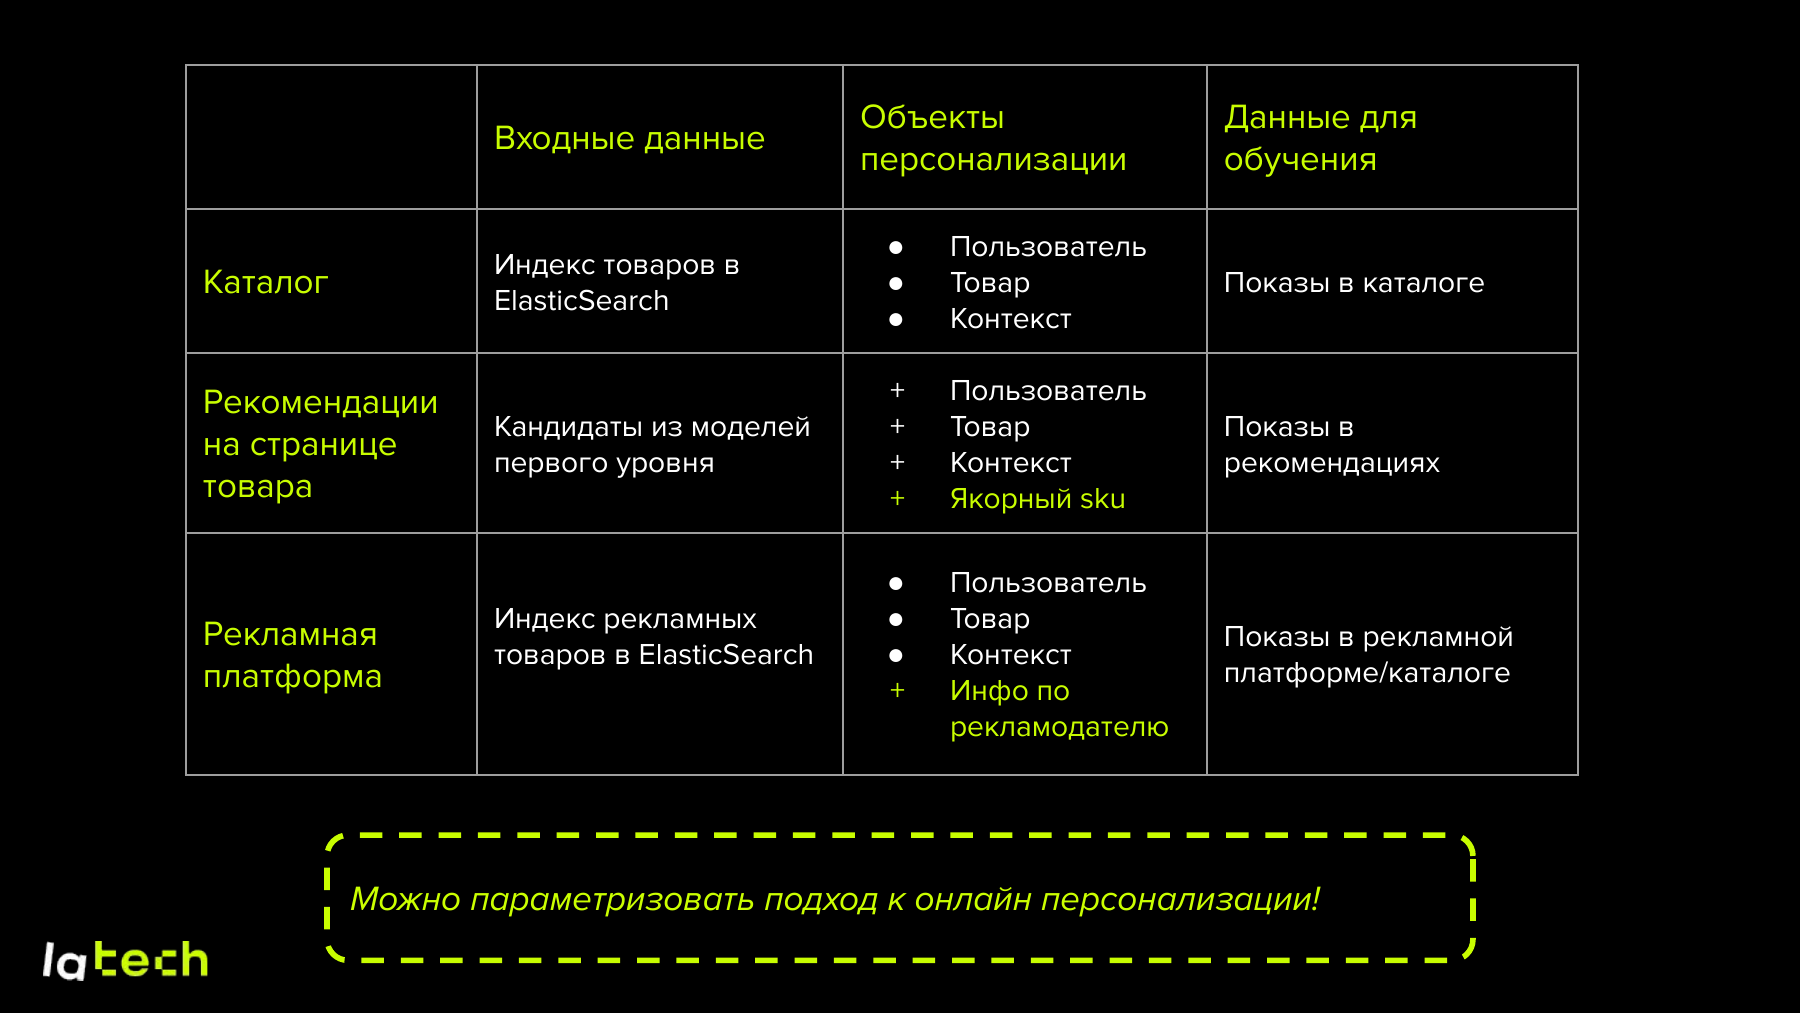
Каталог, рекомендации на карточке и реклама используют общую идею персонализации, но разные кандидаты, объекты, контекст и данные для обучения.
Источник: Дана Злочевская · Lamoda · слайд 33Общие форматы данных важнее копирования обучающего скрипта
Унификацию разделили на подготовку данных и обучение модели. Поток событий пользователя — показы и последующие действия — в докладе назван clickstream. Реальные показы приходят с клиентской части приложения и нуждаются в очистке. Команда разработала общий формат хранения событий и единый интерфейс чтения и записи, чтобы одинаково получать подготовленные показы каталога и рекомендаций.
Вторая общая часть — форматы признаков и обучающих наборов. Они позволяют использовать признаки соседней команды без отдельного перевода данных в новый внутренний формат. При переносе на другую поверхность меняется источник показов, но не обязательно весь способ работы с ними.
Для обучения на слайде показаны Python-библиотека и инструмент единообразного конфигурирования и запуска ML-процессов. Предполагается задавать нужные данные и признаки через параметры; модель может оставаться того же типа или меняться под задачу. При этом в речи создание универсального шаблона обучения названо работой, которую команда ещё решает. Уже разработанные форматы данных не следует смешивать с полностью завершённой автоматизацией всех обучающих процессов.
Практический смысл этого разделения — переносить общую подготовку, а не предполагать одинаковость самих обучающих примеров. Показ в каталоге и показ в рекомендательной полке доступны через похожий интерфейс, но отражают разные ситуации выбора товара.
Доклад · 00:14:24Универсальность через библиотеку, а не сервис «одной кнопкой»
Система применения моделей тоже нуждалась в общей основе. Один вариант — оставить каждой команде собственную реализацию: инфраструктура каталога, рекомендаций и рекламы различалась. Но тогда пришлось бы повторять код и заново решать уже известные проблемы.
Противоположный вариант — сделать шаблон сервиса и программный интерфейс, API, для создания и управления переранжировщиками. На слайде это «API создания и управления реранкера (template сервиса)». В речи идеал описан как развёртывание одной кнопкой с несколькими конфигурациями. Команда сочла такую степень унификации преждевременной: продуктам ещё понадобятся нестандартные изменения.
Принят промежуточный вариант: основные методы каталожного сервиса вынесли в библиотеку на Go. Команды импортируют её и собирают свой сервис из общих частей. На слайде 40 выбран именно вариант «API Библиотека на go с методами реранкера», а не централизованное создание готовых сервисов.
Таким образом, общими стали методы получения модели, работы с данными, вычисления признаков и запуска. Продуктовая интеграция остаётся отдельной. Доклад не описывает HTTP-методы такого API, сетевой протокол, универсальную схему запроса или единый сервис управления всеми моделями.
Доклад · 00:16:03Как сервис согласует конфигурацию, источники и модель
Полная последовательность внутри Reranker состоит из загрузки конфигурации и модели, получения данных, сборки совместных признаков, применения модели и сортировки. Общая библиотека обслуживает именно эту последовательность, а не только вызов CatBoost.
Из S3 сервис получает бинарный файл модели и конфигурацию с описанием источников признаков и их преобразований. Из etcd он узнаёт актуальную версию модели. Модель не скачивается при каждом запросе: она загружается по необходимости и сохраняется в кэше. Срок хранения, TTL, задаётся в конфигурации; конкретное значение не названо.
Источники данных на схеме — Aerospike, Redis и Postgres. Обращения к ним выполняются параллельно, чтобы получить сведения для дальнейшего расчёта. Это, по словам автора, самая тяжёлая часть по производительности. Данные пользователя нужны для запроса, а объём извлекаемых товарных данных растёт с числом кандидатов. Размеры пакетов запросов и формат ключей не раскрыты.
После получения данных сервис формирует «комбо-фичи» — признаки из нескольких источников. Пример: предпочтительный размер пользователя соединяется с текущим списком доступных размеров товара. Только после этого запускается модель и возвращается порядок кандидатов.
Схема показывает, почему перенос системы шире переноса весов: нужно одинаково понимать источники, преобразования и порядок признаков, а также получать данные достаточно быстро. S3 на рисунке обозначает место хранения модели и конфигурации, но не доказывает размещение всей инфраструктуры в конкретном облаке.
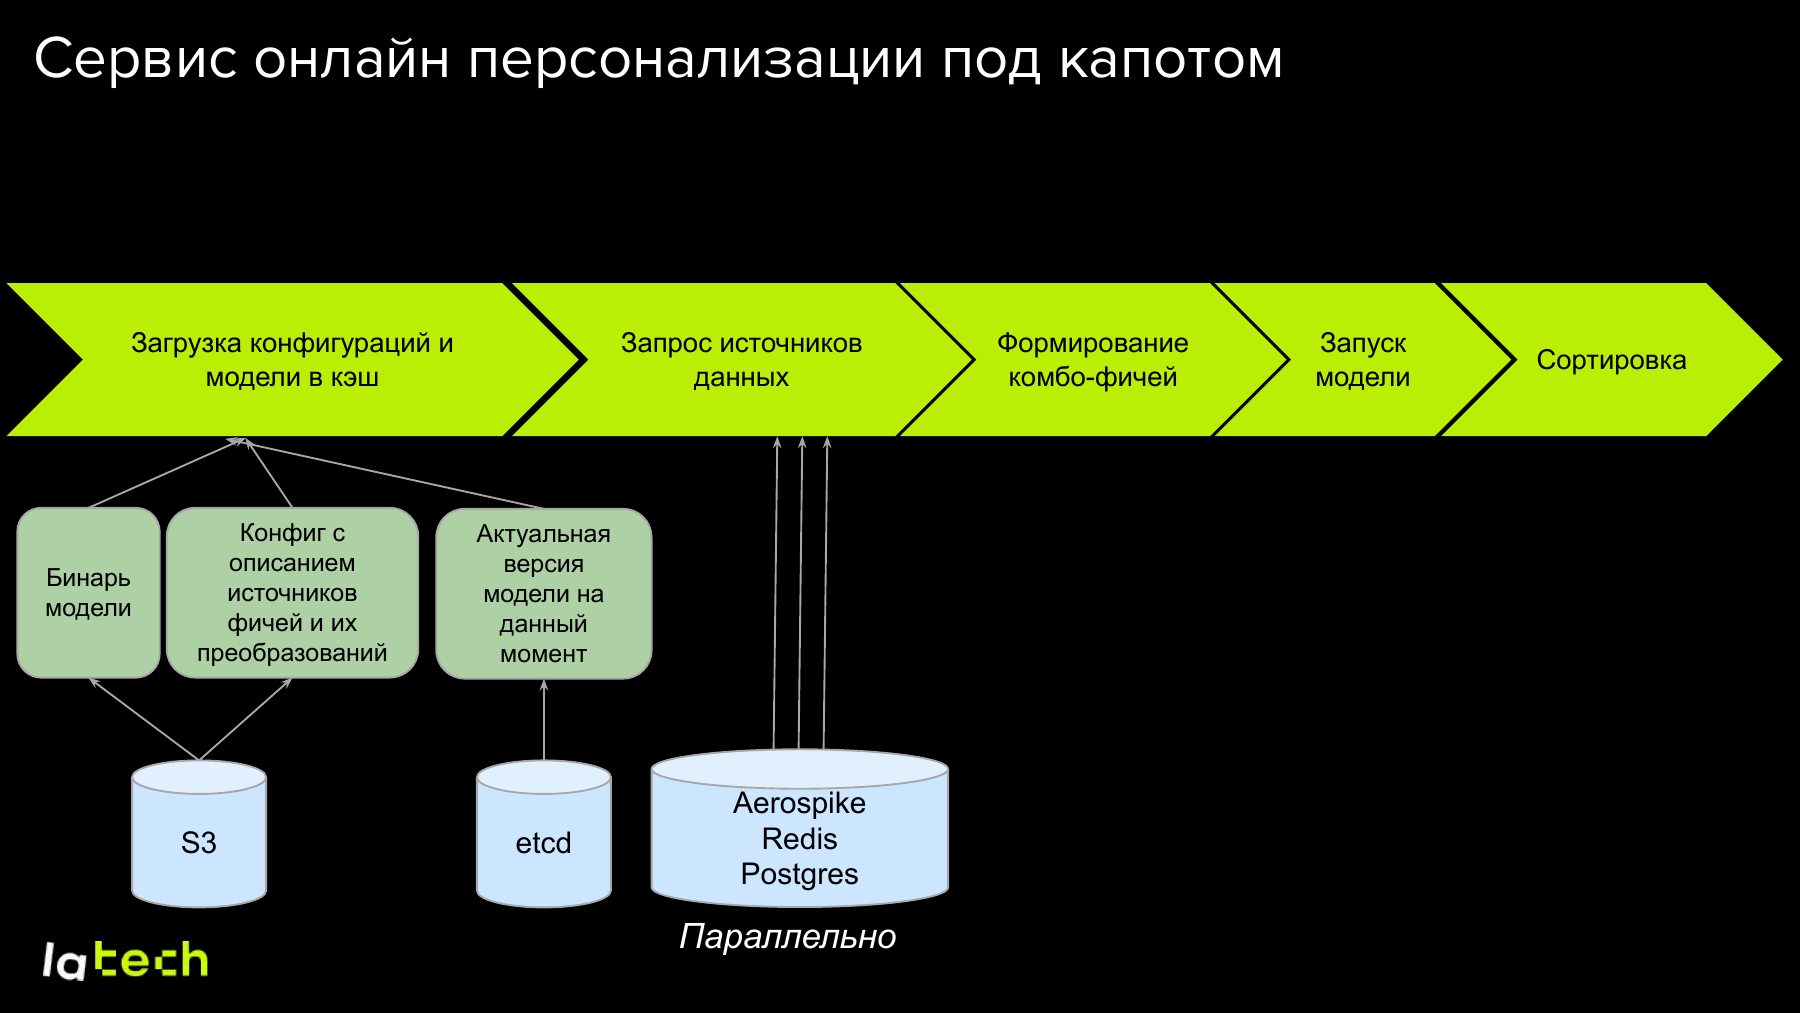
Модель и конфигурация кэшируются; источники Aerospike, Redis и Postgres запрашиваются параллельно. После парных признаков идут запуск модели и сортировка.
Источник: Дана Злочевская · Lamoda · слайд 44Время каталога, время Reranker и время модели — разные величины
Дополнительное ранжирование оказывается в пользовательском пути и увеличивает ожидание. Дана подчёркивает: новая функция может оказаться неудачной в тесте не из-за плохого выбора товаров, а из-за слишком медленного ответа. В докладе приведены разные показатели для всего каталога и для отдельного сервиса персонализации.
Таблицу можно прокрутить по горизонтали.
SLA здесь — заявленное требование к времени ответа сервиса. Оно не равно времени вычисления модели. Основную тяжесть автор связывает с чтением оперативных данных и сбором признаков. Поэтому нельзя назвать 250 мс задержкой CatBoost, а из приблизительной доли 20% вывести отдельный измеренный результат в миллисекундах.
В материалах нет конфигурации нагрузочного теста, длительности замера, доли ошибок и отдельного распределения задержек при 1000+ RPS. Поэтому большая выдерживаемая нагрузка не превращается автоматически в доказательство соблюдения того же порога на любом потоке.
Доклад · 00:19:26Три направления масштабирования и предел параллельных запросов
При росте числа пользовательских запросов команда увеличивает количество экземпляров сервиса. В выступлении указаны 60 подов, каждому выделено по описанию 4 ГБ оперативной памяти и четыре ядра. Это конфигурация сервиса, а не размер модели или сведения о фактической загрузке ресурсов.
Рост числа кандидатов создаёт другую проблему. Автор ставит вопрос: как обработать 3000 так же быстро, как 300? Для этого недостаточно просто иметь больше экземпляров сервиса — одному запросу нужно получить больше товарных данных. Среди направлений названы разделение данных между частями хранилища, то есть шардирование, и разбиение большого ранжирования на параллельные запросы.
В Q&A Дана уточняет: шардирование ещё не внедрено. Возможный ключ — товар-кандидат, поскольку данные пользователя читаются один раз, а товарная часть растёт пропорционально числу кандидатов. Следовательно, 3000 кандидатов, выбранный ключ шардирования и ускорение от такого разбиения нельзя описывать как уже проверенную рабочую конфигурацию.
Третье направление — сложность признаков. Новый признак может потребовать нескольких последовательных обращений к данным и стать дорогим независимо от скорости модели. Автор предлагает заранее продумывать его расчёт и, где возможно, переносить отдельные части в подготовку вне пользовательского запроса.
Слушатель отдельно спрашивает, сокращает ли пакетная или параллельная загрузка время одного запроса либо лишь помогает выдерживать общую нагрузку. Сравнительных замеров в ответе нет. Поэтому доклад фиксирует узкое место и направления работы, но не даёт универсального рецепта ускорения чтения.
Доклад · 00:20:18Разнообразие, маржинальность и рекламные места остаются отдельными задачами
Если ранжировать больше кандидатов только по привлекательности для пользователя, начало выдачи может стать однообразнее. Изменение порядка ради более разнообразного списка называется диверсификацией. На слайде 48 она показана как дополнительный этап рядом с асинхронными логами работы сервиса.
Статус уточняется в вопросах: на тот момент разнообразие обеспечивает первый уровень, и его пока хватает. Дополнительный слой в Reranker разрабатывают; автор называет алгоритм MMR, но не раскрывает в доступном фрагменте его настройки и способ оценки сходства. Отдельного измеренного эффекта этой доработки нет. Перенос дополнительных этапов в общую библиотеку также обозначен как дальнейшая работа.
Бизнес-цели тоже не удалось просто встроить в обучение. На вопрос о марже Дана отвечает, что экспериментов было много, но получить подходящую целевую метку для модели пока не получилось. Модель ориентируется на релевантность и конверсию, а баланс с маржинальностью и наличием товара поддерживают формулы первого уровня.
В рекламе действуют фиксированные, «трафаретные» слоты. Динамическое размещение собираются проверять: показывать больше рекламы, когда есть подходящие предложения, и не показывать неподходящую. Вопросы о динамических коэффициентах формул и ставках не получили подробного ответа. Нельзя достроить из них ни формулу аукциона, ни реализованный механизм управления рекламной нагрузкой.
Доклад · 00:21:45Перенос на полку «С этим товаром покупают»
В качестве первого подробного примера переноса выбрана полка на карточке товара. Её исходные рекомендации строятся по совместным покупкам. На схеме первого уровня от всего ассортимента отбираются 200 товаров; кроме списка кандидатов в задаче есть якорный товар.
В примере якорем служит пиджак. В исходной полке есть товары того же бренда и вещи, которые можно надеть вместе с ним, но встречаются и менее очевидные сочетания — например, платье. Теперь задача второго уровня — учесть одновременно покупателя, пиджак и каждого кандидата, а не просто поднять любимые бренды пользователя.
Для обучения заменили показы каталога на сессии и показы в рекомендательной полке. Целевое действие осталось cart_add. К признакам пользователя и кандидата добавились признаки якорного товара и их совместного поведения с кандидатом. На стороне сервиса потребовались два дополнительных обращения: за атрибутами якоря и за парными товар-товар признаками.
Это конкретный пример повторного использования библиотеки: общая последовательность получения модели, данных, сборки признаков и сортировки сохранилась, а состав данных изменился. Число 200 относится к рекомендательной схеме и не заменяет 150 или 300 кандидатов в каталожных экспериментах.
Доклад · 00:22:35Почему готовые веса не перенеслись, а отдельное обучение помогло
Базовый вариант сравнения, baseline, — рекомендации только от модели первого уровня. Сначала команда попробовала без переобучения применить готовый бинарный файл каталожной модели. Затем обучила отдельную модель второго уровня на показах полки и последовательно добавляла сведения о якорном товаре и его взаимодействиях с кандидатами. Парные факторы здесь описывают совместные клики, добавления в корзину (cart_add) и заказы (order) для якоря и кандидата.
Таблица показывает границу переноса: одинаковая техническая форма входа не делает готовую модель подходящей новой поверхности. Каталожная модель училась на других показах и не описывала отношение кандидата к якорному товару так, как это требуется полке. Именно эти различия адресуют следующие опыты — обучение на показах рекомендаций и расширение признаков. Однако отдельной диагностики, которая количественно разложила бы причину −6,5%, в докладе нет.
Значения +0,5%, +4,7% и +7,2% относятся к соответствующим вариантам относительно указанного baseline, а не к трём независимым прибавкам. Их нельзя складывать. Не приведены абсолютное значение NDCG@60, объём проверочной выборки, интервалы неопределённости и точный протокол разделения данных.
В визуальном примере после изменения порядка выше оказываются серые вещи и больше товаров, подходящих как низ к пиджаку. Это иллюстрация работы персональных и парных признаков, не новая метрика качества. На слайде 58 прямо указано «A/B test in progress…»: проверка поведения пользователей ещё идёт. Поэтому +7,2% NDCG@60 не являются ростом корзин, покупок или денежного результата.
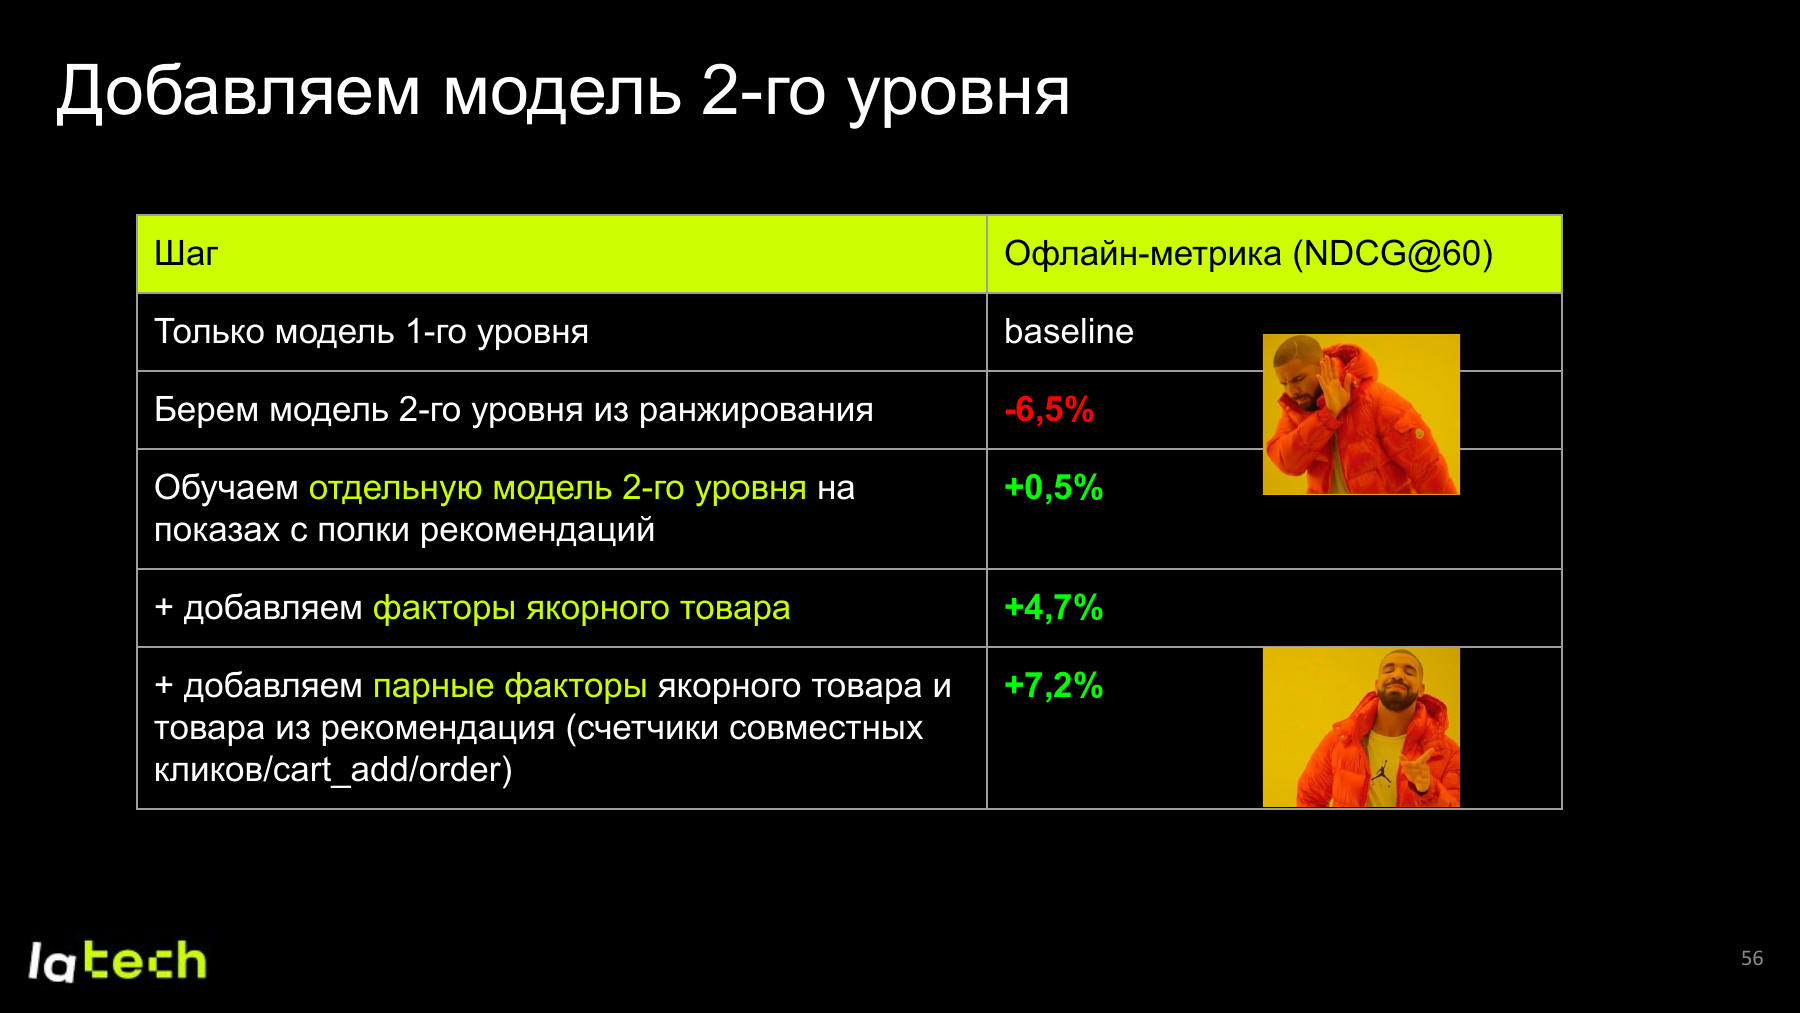
Относительно модели первого уровня: перенос каталожной модели −6,5% NDCG@60; отдельное обучение +0,5%; признаки якорного товара +4,7%; парные факторы +7,2%. Это офлайн-оценка, а не бизнес A/B.
Источник: Дана Злочевская · Lamoda · слайд 56Как далеко дошло распространение на другие продукты
После успешных каталожных тестов и офлайн-опытов в рекомендациях команда планировала расширять общий подход. Но поверхности находились на разных стадиях, и это прямо отражено на слайде дальнейших шагов.
Наличие рекомендательных полок и рекламных товаров в продукте не означает завершённого переноса на них описанного персонального второго уровня. Команда ожидает, что каждая следующая интеграция станет проще, поскольку модельное обслуживание и работа с данными уже имеют общие части.
В выводах Дана считает собственный сервис оправдавшим вложения: подключение рекомендаций потребовало меньше повторной работы. Это качественная оценка автора. Точных трудозатрат, длительности интеграции и расчёта экономии в материалах нет.
Доклад · 00:25:18Зачем записывать признаки именно в момент работы модели
Другая линия развития не меняет модель напрямую, а меняет её обучающие данные. До перехода признаки восстанавливали по истории пользовательских событий. Но восстановленное значение может отличаться от того, которое было доступно сервису при конкретном показе: изменились данные, версия признака или способ расчёта. При особенно динамичных признаках восстановить прошлое состояние становится ещё сложнее.
Предлагаемое решение — сохранять кандидатов и признаки при применении модели. Такие записи работы сервиса называют логами. Reranker отправляет события асинхронно, то есть отдельной отправкой, не превращая обучение в шаг пользовательского запроса. Логи нужны и для разбора неудачной выдачи, и для подготовки данных будущей модели.
Полная схема обучения по логам: Service Reranker → Kafka → Spark Streaming → Logged Features в Hadoop → Dataset → ML Model → Service Reranker. Kafka принимает поток событий, Spark обрабатывает его, затем из сохранённых значений формируют обучающий набор. Новую обученную модель возвращают в сервис. На слайде 61 отдельно указан переход на Structured Spark Streaming.
Вывод из схемы — обучать модель на тех значениях, которые действительно могли участвовать в её работе, вместо предположительного восстановления этих значений задним числом. При этом сохранённый кандидат не становится автоматически реальным показом или положительным примером. Доклад по-прежнему связывает обучение с показами и cart_add; точная процедура соединения серверных логов с клиентскими показами и действиями не раскрыта.
Переход на обучение по записанным признакам в целом ещё выполняется. Наличие отправки логов и схемы обратного поступления модели не доказывает, что все обучающие процессы и свежие пользовательские признаки уже переведены на этот путь.
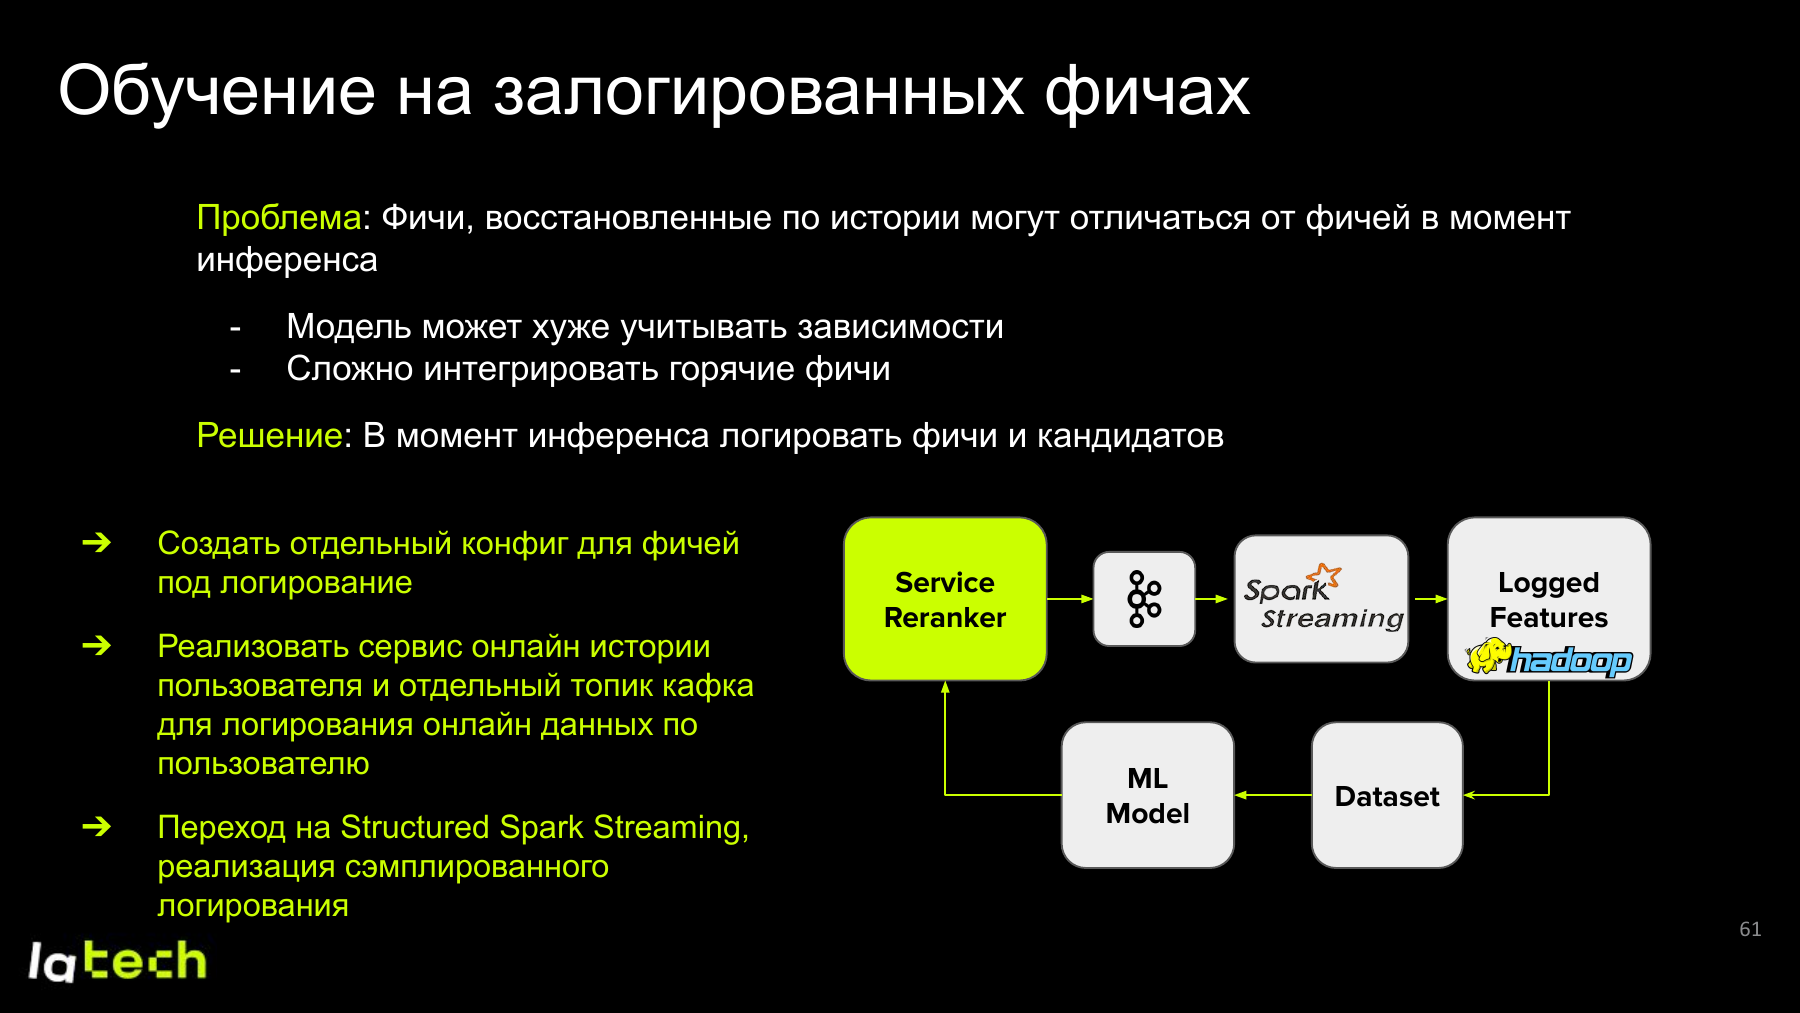
Логирование признаков и кандидатов уменьшает расхождение с восстановленными данными. Поток Kafka, Spark Streaming и Hadoop показан отдельно от обработки запроса; статус изменений сохраняется по выступлению.
Источник: Дана Злочевская · Lamoda · слайд 61Общий набор логируемых признаков и риск обучения на своих показах
Переход на логи меняет не только точность значений, но и состав данных. В обучающий материал попадают сессии, в которых модель действительно запускалась. Возникает риск замкнутой обратной связи: предыдущая выдача определяет наблюдаемые действия, а они влияют на следующую модель. Дана говорит, что в проведённом эксперименте усиления такого эффекта не увидели. Методика проверки и размер эксперимента не приведены, поэтому это наблюдение не снимает риск вообще.
Ещё одна проблема возникает в A/B-тесте двух моделей с разными признаками. Если каждая сохраняет только собственный вход, события двух групп содержат несовместимые наборы полей. Следующую модель нельзя будет одинаково обучить на всём материале. Упоминание «половины данных» в речи иллюстрирует эту проблему, а не задаёт документированную пропорцию распределения трафика.
Решение — отдельная конфигурация логирования, независимая от набора признаков запущенной модели. Она задаёт общий набор сохраняемых значений для последующего обучения. Так конфигурация модели отвечает за текущий расчёт, а конфигурация логирования — за сопоставимость будущих обучающих данных. Точная схема версий и миграций полей в докладе не описана.
Доклад · 00:27:00Свежая история, два потока событий и стоимость логирования
Чтобы учитывать последние действия, команда реализовала отдельный сервис истории пользователя. В него поступают просмотры товаров, добавления в корзину, избранное и заказы. В Q&A указан лаг меньше секунды. Это задержка попадания события в историю, а не измеренное время изменения персональной выдачи.
Данные разделены на два топика Kafka — два отдельных потока сообщений. В первый записываются кандидаты и признаки запуска модели. Во второй — состояние пользователя, доступное в момент этого запуска. Последний поток нужен, чтобы позднее строить свежие пользовательские признаки без попытки восстановить каждое состояние только по общей истории.
Из-за большого объёма событий автор описывает переход на Structured Spark Streaming как уже потребовавшееся техническое изменение. В конфигурации команды оно позволяло масштабировать вычитывание без увеличения числа партиций Kafka. Не названы ни прежний точный механизм чтения, ни скорости потока; это не универсальное обещание такой же производительности при любых настройках.
Сохранять только часть событий — сэмплировать логи — предложено из-за стоимости полного потока. Коэффициент отбора, способ выбора событий и объём экономии не приведены. Главное различие статусов: инфраструктура получения свежих действий уже появилась, но её наличие ещё не равно использованию этих действий моделью при выдаче.
Доклад · 00:28:02Q&A: сигналы совместных действий и внешнего вида товара
Вопрос из зала касается двух дополнительных источников информации. Первый — совместные действия пользователей с товарами, то есть коллаборативные сигналы. Дана подтверждает их использование и в отборе кандидатов, и как признаков ранжирования. Конкретные методы, предложенные слушателем в вопросе, не становятся от этого подтверждёнными моделями Lamoda.
Второй источник — числовые представления изображений, или визуальные эмбеддинги: они описывают внешний вид товара, а не только его бренд и цвет в карточке. Автор подтверждает использование визуальных представлений в рекомендациях. Точные архитектуры, размерность и способ поиска похожих объектов в доступных материалах не раскрыты однозначно.
Для каталога команда разрабатывала дополнительные механизмы отбора: например, подмешивать товары, похожие на то, что человек недавно открыл. Это названо тестируемым направлением и связано с будущим использованием свежей истории. Его нельзя включать в уже доказанную конфигурацию каталожных A/B-тестов.
Доклад · 00:31:01Q&A: кто выпускает модель и как замечают проблемы
Ежедневное переобучение вызывает отдельный вопрос: как убедиться, что очередная модель не сломалась? Дана подтверждает сбор метрик и уведомления при проблемах. После обучения офлайн-метрики отправляются в систему мониторинга. Название этой системы в расшифровке неразборчиво, а на слайдах не указано.
Такой ответ подтверждает контроль результата обучения, но не описывает полный механизм выпуска. Не приведены пороги остановки выкладки, автоматический откат, правила замены модели при ошибке источника данных или проверка всех отклонений в реальном времени. Упоминание алертов нельзя превращать в готовую схему безопасного развёртывания.
Распределение ответственности устроено внутри одной кросс-функциональной команды. Data scientists ведут Python-часть, обработку данных и процессы Airflow. Разработчики Go отвечают за сервис применения модели. Отдельная команда ML-инженеров или конкретный процесс CI/CD в ответе не описаны. Общая библиотека уменьшает повторную работу, но не отменяет участия обеих специализаций.
Доклад · 00:33:37Q&A: что происходит после 300 товаров и при следующей странице
Переранжированный список не ограничивает весь каталог. Сервис получает 300 кандидатов и возвращает 300 в новом порядке, а пользователю показывают страницу из 20 товаров. Если человек проходит дальше 300-го товара, применяется базовое ранжирование: дополнительную персонализацию второго уровня там не продолжают, чтобы не тратить ресурсы.
Фильтры не ограничиваются заранее выделенным набором из первых 10 000 товаров. Запрос в Elasticsearch уже содержит ограничения покупателя, и движок возвращает подходящих кандидатов из базового порядка всего каталога. Это ответ на опасение слушателя, что после фильтрации заранее ограниченного набора может ничего не остаться.
При переходе к свежим пользовательским признакам усложняется следующая страница. Команда хочет заново получать кандидатов и пересчитывать порядок, чтобы учесть последние действия и новые источники. Тогда уже известные позиции 21–40 нельзя просто считать окончательным ответом: более свежий контекст может дать другой порядок.
Такое перестроение требует сохранять сведения о выданных результатах и не показывать дубли. Автор говорит о необходимом кэшировании и переделке логики пагинации; точные ключи кэша, сроки хранения и алгоритм удаления повторов не раскрыты. Реакция на действие при загрузке очередных 20 товаров — ожидаемое поведение будущей интеграции, а не подтверждённая задержка работающей модели.
В финальных репликах Дана ещё раз называет рассказ о горячих пользовательских признаках гипотетическим. Поэтому стабильная часть описания — фильтрация до второго уровня, 300 кандидатов, страницы по 20 и базовый порядок после 300. Повторный отбор с учётом последних действий относится к дальнейшей работе.
Доклад · 00:42:21Итог: персональный верх каталога и общие компоненты для других продуктов
Lamoda не стала заново ранжировать весь ассортимент тяжёлой моделью при каждом открытии каталога. Команда сохранила быстрый первый уровень и добавила персональное изменение порядка его верхней части. Отдельный Go-сервис дал возможность развивать получение данных и признаки независимо от поискового движка, а библиотека общих методов облегчила перенос в рекомендации.
- 01
Запрос покупателя
Сервис каталога получает запрос и выбранные пользователем ограничения: категорию, поисковую фразу или фильтры. Они задают доступный набор товаров.
- 02
Первый уровень
Elasticsearch применяет фильтры и возвращает кандидатов с учётом сегментного порядка и лёгкой персонализации. Верхняя часть направляется в Reranker.
- 03
Модель и данные
Reranker использует актуальную модель и конфигурацию из кэша либо загружает их. Затем параллельно запрашивает источники данных пользователя и кандидатов.
- 04
Персональные оценки
Сервис соединяет предпочтения покупателя с признаками товаров, включая доступные размеры, затем применяет CatBoost и сортирует кандидатов.
- 05
Страница каталога
Каталог показывает 20 товаров из полученного порядка. Второй уровень обрабатывает 300 кандидатов; после них просмотр продолжается по базовому ранжированию.
Обучение вынесено в отдельный процесс, логи отправляются асинхронно. Исторические признаки и модель обновляются ежедневно; переход к записанным при применении модели значениям готовит основу для свежей истории. Его завершение не следует из одного наличия Kafka или сервиса истории.
В каталоге два отдельных теста дали +3%/+2% и +1%/+1% по корзинам и покупкам, без раскрытой базы процентов и полного протокола. В рекомендациях готовые каталожные веса ухудшили NDCG@60; отдельное обучение и якорные признаки дали лучший вариант +7,2% относительно первого уровня. Это офлайн-результат: A/B-тест ещё шёл. Переносятся общие компоненты, но данные, модель и пользовательский эффект требуют отдельной проверки.
Доклад · 00:29:25