Разбор готов
Яндекс: как RAG-помощник ускоряет техподдержку, сохраняя оператора
Помощник операторов техподдержки, разработанный командой Яндекса, ищет инструкции в рабочей базе знаний и готовит черновик ответа по переписке и сведениям о клиенте. Его задача — сократить ожидание, сохранив за человеком разбор сложных ситуаций и окончательное решение. Поиск материалов перед генерацией ответа называется RAG. На этом примере видно, почему целостность инструкций, качество первых результатов поиска и проверка готового ответа важны не меньше самой генеративной модели: ошибка на одном этапе ограничивает пользу остальных.
Глава полезна ML-инженерам, разработчикам LLM-приложений и продуктовым специалистам, которые создают помощников на основе базы знаний. Достаточно общего представления о языковых моделях; работа поиска, разметки и метрик объясняется на примерах техподдержки.
Видео · на русском
YandexGPT как RAG-ассистент для техподдержки: решаем проблемы быстрееЛена Вольф · ODS AI Ru · Опубликовано: 20 августа 2025 г.
Исходный доклад · Открыть оригинал
Почему оператор остаётся в системе
Автоматизация поддержки начиналась с поиска по ключевым словам: на знакомую формулировку система возвращала подготовленный текст. Большие языковые модели позволяют обрабатывать более свободные обращения, но сами по себе не устраняют причины, по которым клиенту нужен человек. У опытного оператора есть знания о реальной работе сервиса, а не только доступ к инструкциям.
В докладе выделены три ограничения. Некоторые проблемы вообще не описаны в документации: приходится уточнять детали и обращаться к коллегам. В эмоционально чувствительном разговоре важны участие и аккуратность формулировок. Наконец, клиент может прислать фото, видео или ссылку; преобразование такого материала в понятный системе вход тоже способно потерять важные сведения. Возможность обработки нескольких видов данных не равна гарантии правильного разбора обращения.
Поэтому команда выбрала помощника оператора, а не самостоятельного собеседника для клиента. Модели берут на себя поиск и подготовку текста. Оператор оценивает предложенный ответ, при необходимости меняет его и решает, что отправить. Сохранение человека здесь определяет устройство продукта с самого начала, а не служит запасным сценарием после неудачной автоматизации.
Доклад · 00:00:00Как собирается подсказка: три модели и контекст обращения
Работа начинается с переписки. Это может быть первое сообщение клиента или уже продолжающийся разговор с уточнениями. Далее действуют три модели: одна находит материалы, другая меняет их порядок, третья составляет текст. Переранжирование означает повторное упорядочивание найденных кандидатов, чтобы наиболее подходящие оказались выше.
Таблицу можно прокрутить по горизонтали.
К переписке и трём материалам добавляют метаданные — сведения о ситуации клиента: устройство, версию приложения, город, время заказа, способ доставки. Системная инструкция задаёт роль ассистента оператора и требует отвечать по документам с учётом этих сведений. Таким образом, найденная инструкция и фактическое состояние обращения попадают в один запрос к генеративной модели.
В примере клиенту нужен заказ к празднику. После уточнения номера заказа система сопоставляет текущую дату с плановой датой доставки: срок ещё не наступил, задержки нет. Поэтому подходит ответ о доставке по плану, а не сценарий просрочки. Из базы берётся соответствующий шаблон, в который подставляются данные заказа. Одной фразы «Где заказ?» для такого выбора недостаточно: решение зависит от переписки и метаданных.
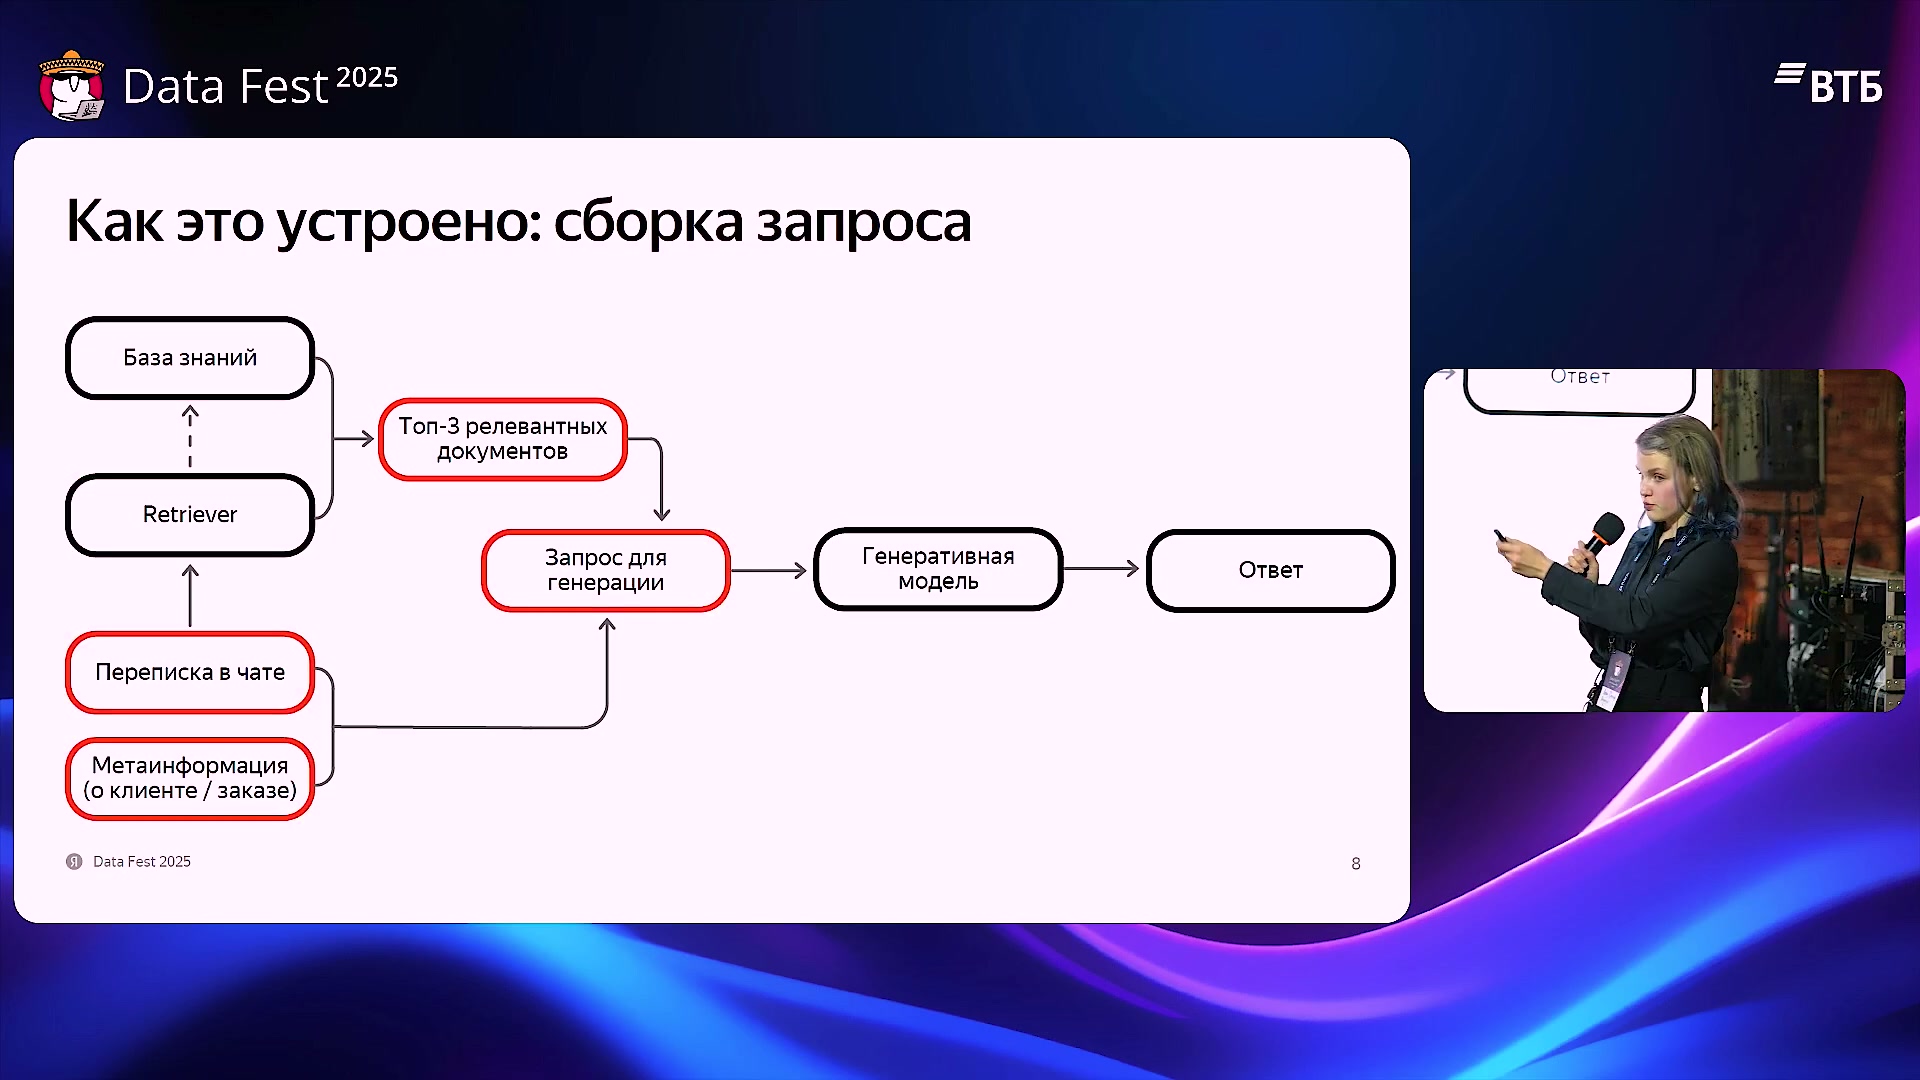
Путь от обращения и базы знаний к предложенному ответу. Кадр доклада Лены Вольф, 03:45.
Источник: Доклад · 03:45Почему равномерная нарезка разрушала полезные инструкции
База знаний была создана для операторов, а не для непосредственной передачи языковой модели. После извлечения текстов команда обнаружила длинные сборники с множеством подзаголовков и ветвлений: проблемы iOS, проблемы Android, отдельные варианты решения внутри каждой группы. Размеры достигали десятков тысяч токенов — единиц, на которые модель разбивает текст. Для отдельных документов спикер приблизительно вспоминает даже величину до миллиона токенов; это не точный измеренный максимум.
Первое решение было прямолинейным: идти сверху вниз и делить документ на фрагменты примерно по 500 токенов. Такой фрагмент называется чанком. Границы сдвигали, чтобы не разрезать слово, поэтому могли получаться, например, 498 или 502 токена. Но сохранение целого слова ещё не сохраняет целую инструкцию.
Особенно неприятно было разрезать шаблон ответа. Поиск мог найти правильный заголовок и нужную ветку для устройства клиента, а в самом фрагменте оставалось только приветствие с именем: продолжение уже находилось за границей. Формально подходящий материал найден, но составить по нему полный ответ нельзя. Исправлять требовалось не только поиск, а саму единицу, которую он возвращает.
Доклад · 00:05:00Иерархическая нарезка: сначала целый шаблон
В новой схеме неделимой основой стал шаблон ответа: его сохраняют целиком. Затем, пока позволяет ограничение размера, к нему добавляют соседний поясняющий текст. Если места достаточно, включают весь подраздел, затем раздел и далее расширяют окружение по структуре заголовков. Так фрагмент собирается снизу вверх, от готового ответа к условиям его применения.
В документе о местонахождении заказа сначала нужно проверить перемещения и определить, есть ли задержка. Для ветки с задержкой берётся короткий шаблон с извинением. К нему присоединяются указания оператору, включая требование не закрывать обращение. Затем можно добавить весь раздел о задержке и, если он помещается, соседний раздел. В одном фрагменте оказываются не только слова для клиента, но и пояснение, когда этот ответ уместен.
Размеры получились переменными: медиана составляла примерно 600 токенов. Это не новый фиксированный размер и не верхний предел. Очень длинные фрагменты находились в хвосте распределения; среди них оказались неиспользуемые поддержкой материалы с большим количеством служебных сведений о странице. Иерархическая нарезка решала задачу смысловой целостности, а пригодность самой базы требовала отдельной очистки.
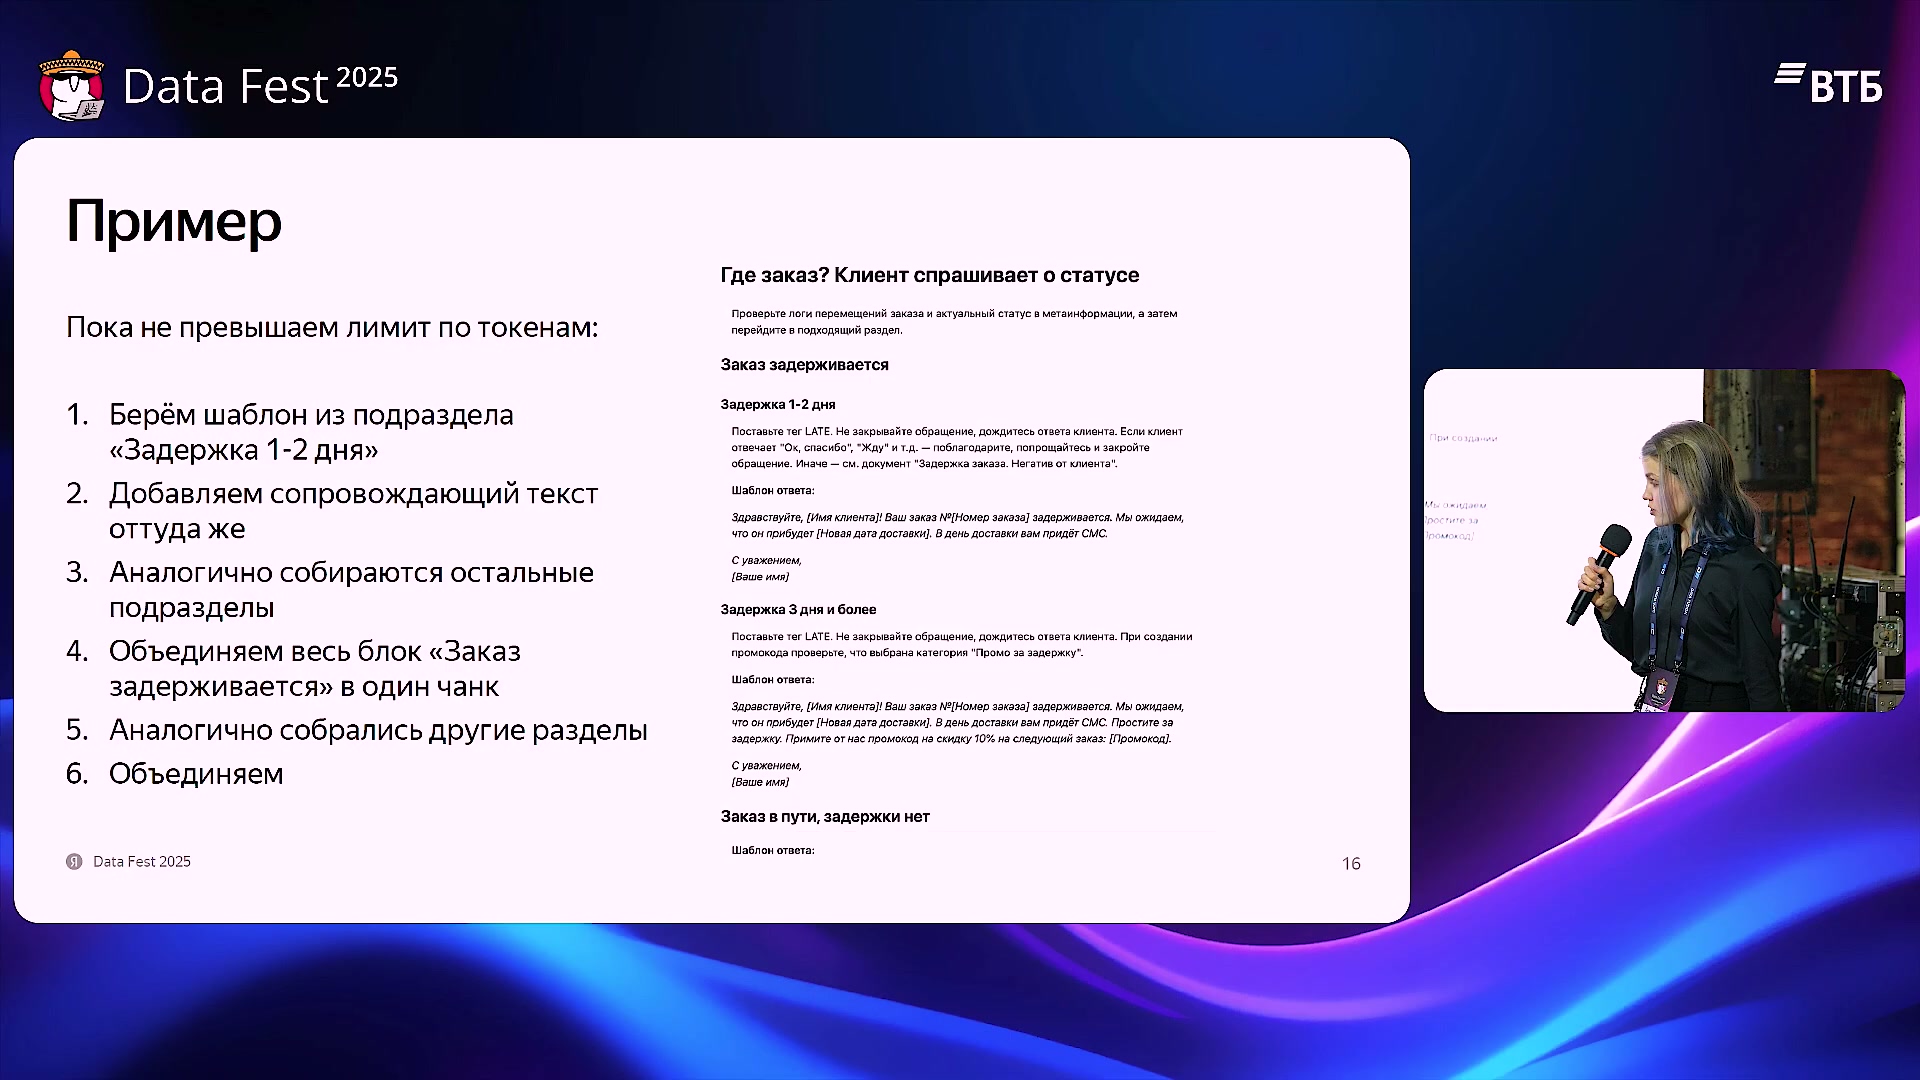
Нарезка сохраняет шаблон ответа и его контекст вместе, пока хватает окна по токенам. Кадр доклада, 08:05.
Источник: Доклад · 08:05Поиск по переписке и проверка попадания в топ-3
После подготовки фрагментов переписку переводят в числовое представление — эмбеддинг. По близости этого представления к представлениям фрагментов система находит материалы, относящиеся к обращению. Важен смысл всей доступной переписки, а не только совпадение отдельных слов с заголовком инструкции.
Для проверки поиска опытные операторы подготовили набор диалогов и указали, какой фрагмент нужен для ответа в каждом случае. Метрика hitrate@N показывает, в какой доле проверенных диалогов целевой материал попал в первые N результатов. Она отвечает на вопрос о наличии нужного источника в выдаче, а не о правильности будущего ответа.
Попадание в топ-20 и топ-32 команда оценивала как высокое, не называя точных значений. Но генеративной модели передавали только три материала. Поэтому документ, найденный ниже третьей позиции, не помогал подготовить ответ. Следующей задачей стало улучшение hitrate@3: поднять уже найденный полезный фрагмент в ту часть выдачи, которую действительно увидит генеративная модель.
Доклад · 00:08:00Разметка кандидатов из реальной поисковой выдачи
Для обучения переранжированию понадобились оценки отдельных пар «диалог — документ», где документом фактически был подготовленный фрагмент. Кандидатов брали из первых 20 результатов поисковой модели для каждого диалога. Такой выбор соответствовал обнаруженной проблеме: нужный материал обычно уже присутствовал в этом списке, но занимал недостаточно высокую позицию.
Исполнитель видел переписку и один фрагмент и отвечал, содержится ли в нём решение проблемы. Релевантной паре соответствовала положительная метка, нерелевантной — отрицательная. Разметка должна была показать, какой из похожих материалов действительно помогает ответить, а не просто тематически напоминает обращение.
К работе привлекали асессоров YandexGPT, уже показавших способность выполнять текстовые задания. Для них подготовили подробную инструкцию, обучение, экзамен и контроль качества. Таким образом, источником обучающих оценок стали не произвольные документы из базы, а кандидаты, с которыми сталкивался реальный поисковый этап.
Доклад · 00:10:00Обучение ранкера: от меток релевантности к полезной тройке
Размеченные пары стали обучающим сигналом для модели переранжирования. Её задача — изменить порядок кандидатов так, чтобы полезный для ответа материал поднялся в первые три позиции. При этом качество человеческих меток и качество получившегося поиска измеряли разными показателями.
Таблицу можно прокрутить по горизонтали.
Асессоры находили большую часть нужных материалов, но также отмечали релевантными некоторые недостаточно подходящие. То есть положительные метки были полезны, хотя и не безошибочны. После описанной работы с разметкой и переранжированием hitrate@3 вырос с 0,34 до 0,7. Это означает наличие целевого источника в тройке для 70% проверенных случаев, а не 70% правильных ответов клиентам.
Значение precision 60% характеризует именно разметку. Оно не связано с другой долей 60%, которая далее описывает выбор подсказки оператором. А recall 86% нельзя считать полнотой поисковой модели: в этом измерении проверяли решения асессоров.
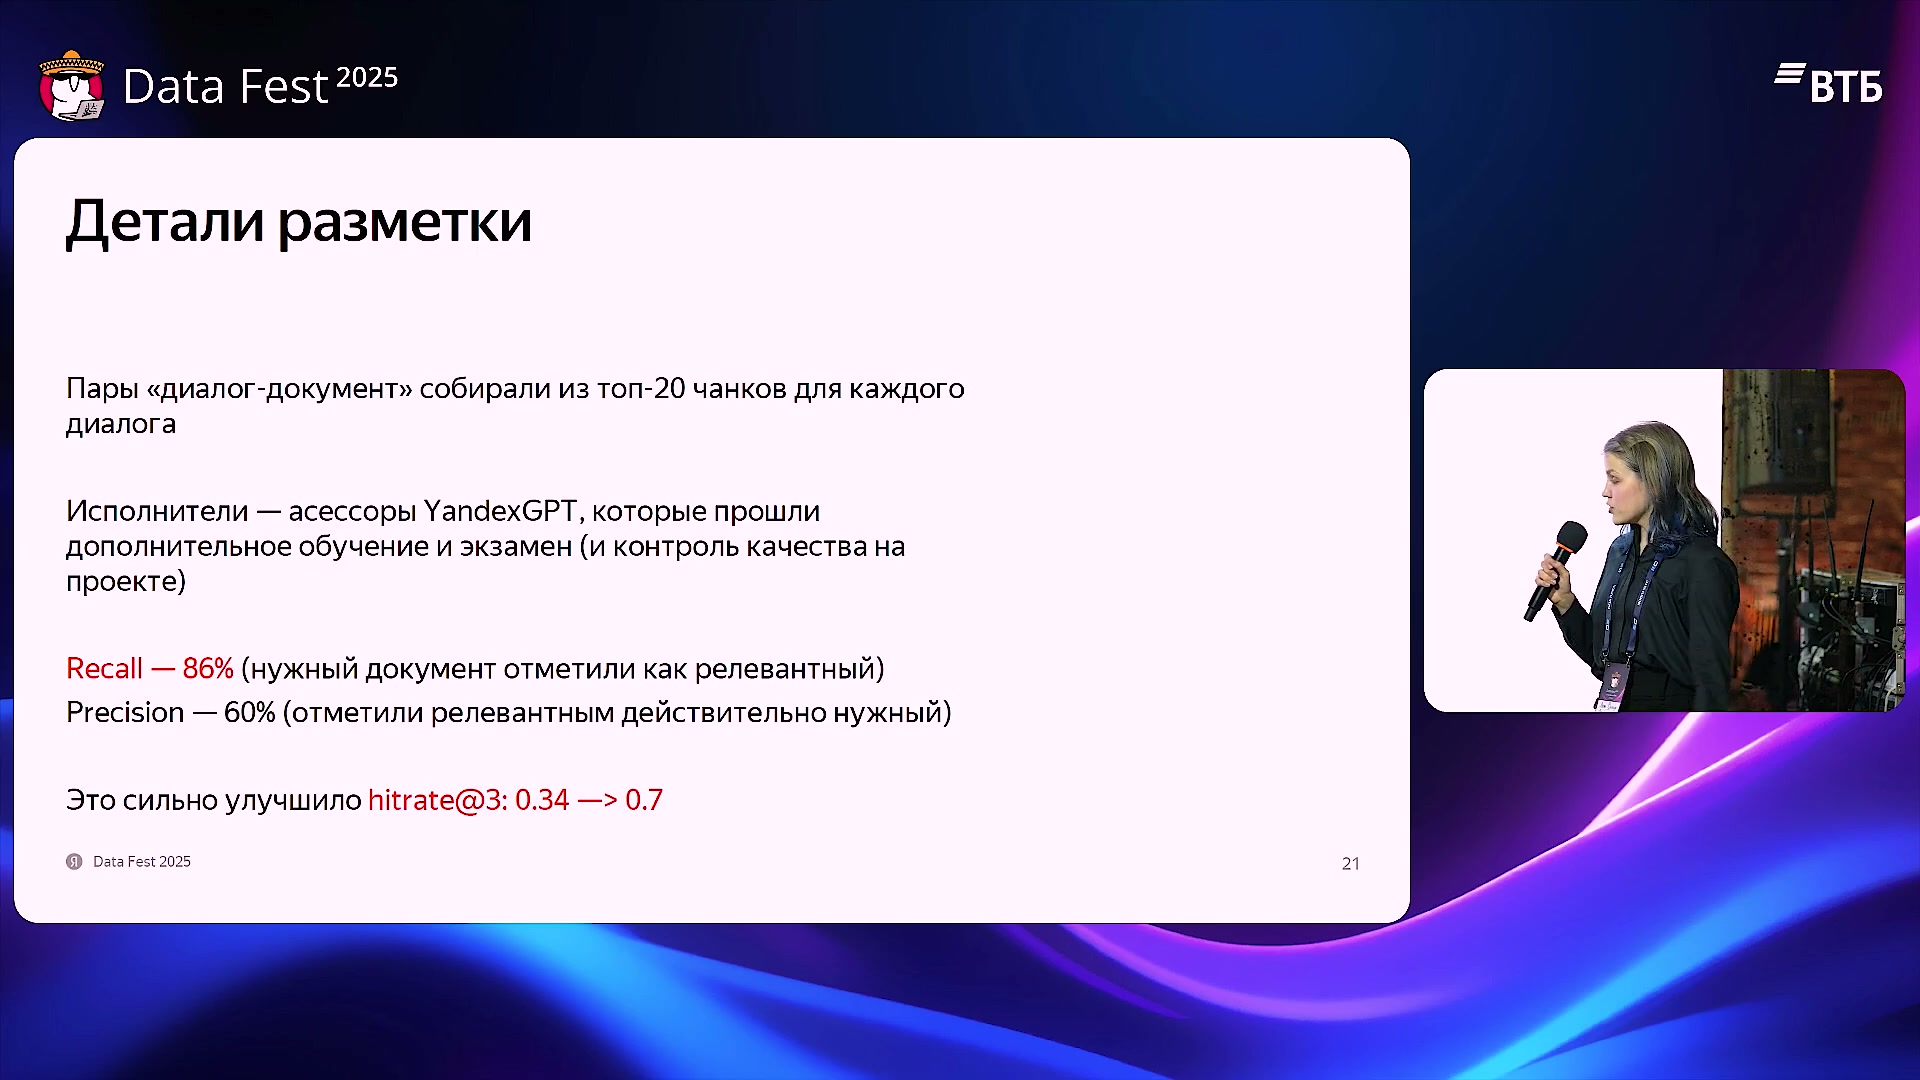
Показатели разметки и рост HitRate@3 после улучшения поиска. Это разные оценки, их нельзя складывать в одну метрику. Кадр доклада, 11:45.
Источник: Доклад · 11:45Обучение генерации: ответ должен находиться в контексте
После улучшения поиска естественным источником обучающих ответов стали логи операторов. Но переносить любую удачную реплику в обучение было нельзя. Генеративная модель должна опираться на приложенные материалы, тогда как оператор мог найти решение в другом месте или воспользоваться собственной экспертизой.
Даже ссылка на источник не всегда решала проблему. Операторы могли не указывать его вовсе, а если указывали, то сохраняли идентификатор целого документа. Поисковая система к этому моменту работала с отдельными фрагментами. Наличие ответа где-то в длинном документе не означало, что он попал в контекст генерации.
Поэтому команда сначала получила фрагменты улучшенным поиском, затем сопоставила их с ответом оператора. Использовались эвристики текстового сходства, среди которых в докладе упоминается сравнение по Левенштейну. В обучение отбирали примеры, где такая проверка подтверждала наличие ответа в найденных материалах. Подробности варианта сравнения и его пороги не раскрыты.
Дополнительные ответы собирали через разметку. Исполнителю давали роль ассистента оператора, диалог и документы — примерно тот же вход, что и генеративной модели. Доступа к полной операторской базе у исполнителя не было. Задание тем самым связывало требуемый ответ с доступным контекстом. Обе процедуры решали одну задачу: подготовить примеры ответа по найденным основаниям, а не просто научить модель воспроизводить стиль поддержки.
Доклад · 00:12:00Когда лучше не показывать подсказку
Отсутствие ответа в контексте имеет две разные причины. Поиск может не найти существующую инструкцию. Но бывает и так, что решение вообще не записано в базе: клиент принёс новый или специфический случай, который требует человеческого расследования. Улучшение ранжирования помогает только с первой причиной.
В системную инструкцию добавили требование явно сообщать о недостатке информации в приложенных документах. Это позволяет не подгонять неподходящий материал под проблему клиента. Однако формулировка отказа могла немного меняться: добавлялись слова о приложенных документах или о невозможности подготовить ответ.
Для распознавания этих вариантов использовали регулярное выражение — текстовое правило поиска заданных формулировок. Если оно срабатывало, подсказку не показывали оператору. Работа с обращением продолжалась без неё: оператору не приходилось читать сообщение, которое ничего не добавляет к решению. Это фильтр отказов, а не автоматическая проверка достоверности всех остальных ответов; доля пропущенных неподтверждённых ответов не приводится.
Доклад · 00:13:00Проверка ответа: от приветствия до выбора инструкции
Качество готовых ответов проверяли доверенные операторы. Их просили не только поставить оценку, но и объяснить, что не так. Такая обратная связь выявляла требования, которые трудно заметить при одной автоматической проверке текста.
Простой пример — приветствие. «Доброе утро» может оказаться неуместным из-за другого часового пояса клиента, поэтому предпочтительно «Здравствуйте». Подобные правила добавляли в системную инструкцию. Более тонкие особенности ответа дорабатывали обучением модели на дополнительных примерах. Здесь проверка влияла и на запрос к модели, и на её последующее обучение.
Более содержательный пример — просьба отключить платную подписку, когда нужная функция не находится в профиле. Поиск возвращает три документа: об отключении подписки на сайте, об отключении подписки на iOS и об отмене автопродления абонемента. Первый документ, несмотря на похожее название, описывает почтовую рассылку.
В полученном ответе используется инструкция об отмене автопродления абонемента. Слова пользователя не совпадают с её заголовком буквально, но именно она соответствует смыслу платной подписки. Этот пример показывает, зачем генерации нужны содержание документов и контекст запроса, а не только похожие названия. Он иллюстрирует удачный выбор инструкции, но не заменяет оценку на наборе неоднозначных обращений.
Доклад · 00:14:00Что изменилось в работе поддержки
Результат системы оценивали не только по поисковой выдаче, но и по работе операторов и реакции клиентов. Основной заявленный эффект — сокращение среднего времени от обращения пользователя до получения ответа на 15%. Показатель описывает ожидание ответа клиентом, а не длительность одного вызова генеративной модели.
Таблицу можно прокрутить по горизонтали.
Небольшое редактирование могло касаться даже одного приветствия. Например, система подставила имя из профиля, а оператор по содержанию обращения решил оставить нейтральное «Здравствуйте» без имени. Поэтому долю использования подсказок нельзя приравнивать к доле автоматических ответов без участия человека.
Команда сообщает, что качество ответов по клиентским оценкам сохранилось, а рост удовлетворённости связывает с более быстрым получением помощи. Это отдельные утверждения: ускорение обслуживания не является измерением качества текста, а отсутствие названной величины роста удовлетворённости не позволяет приписать ей процентный прирост.
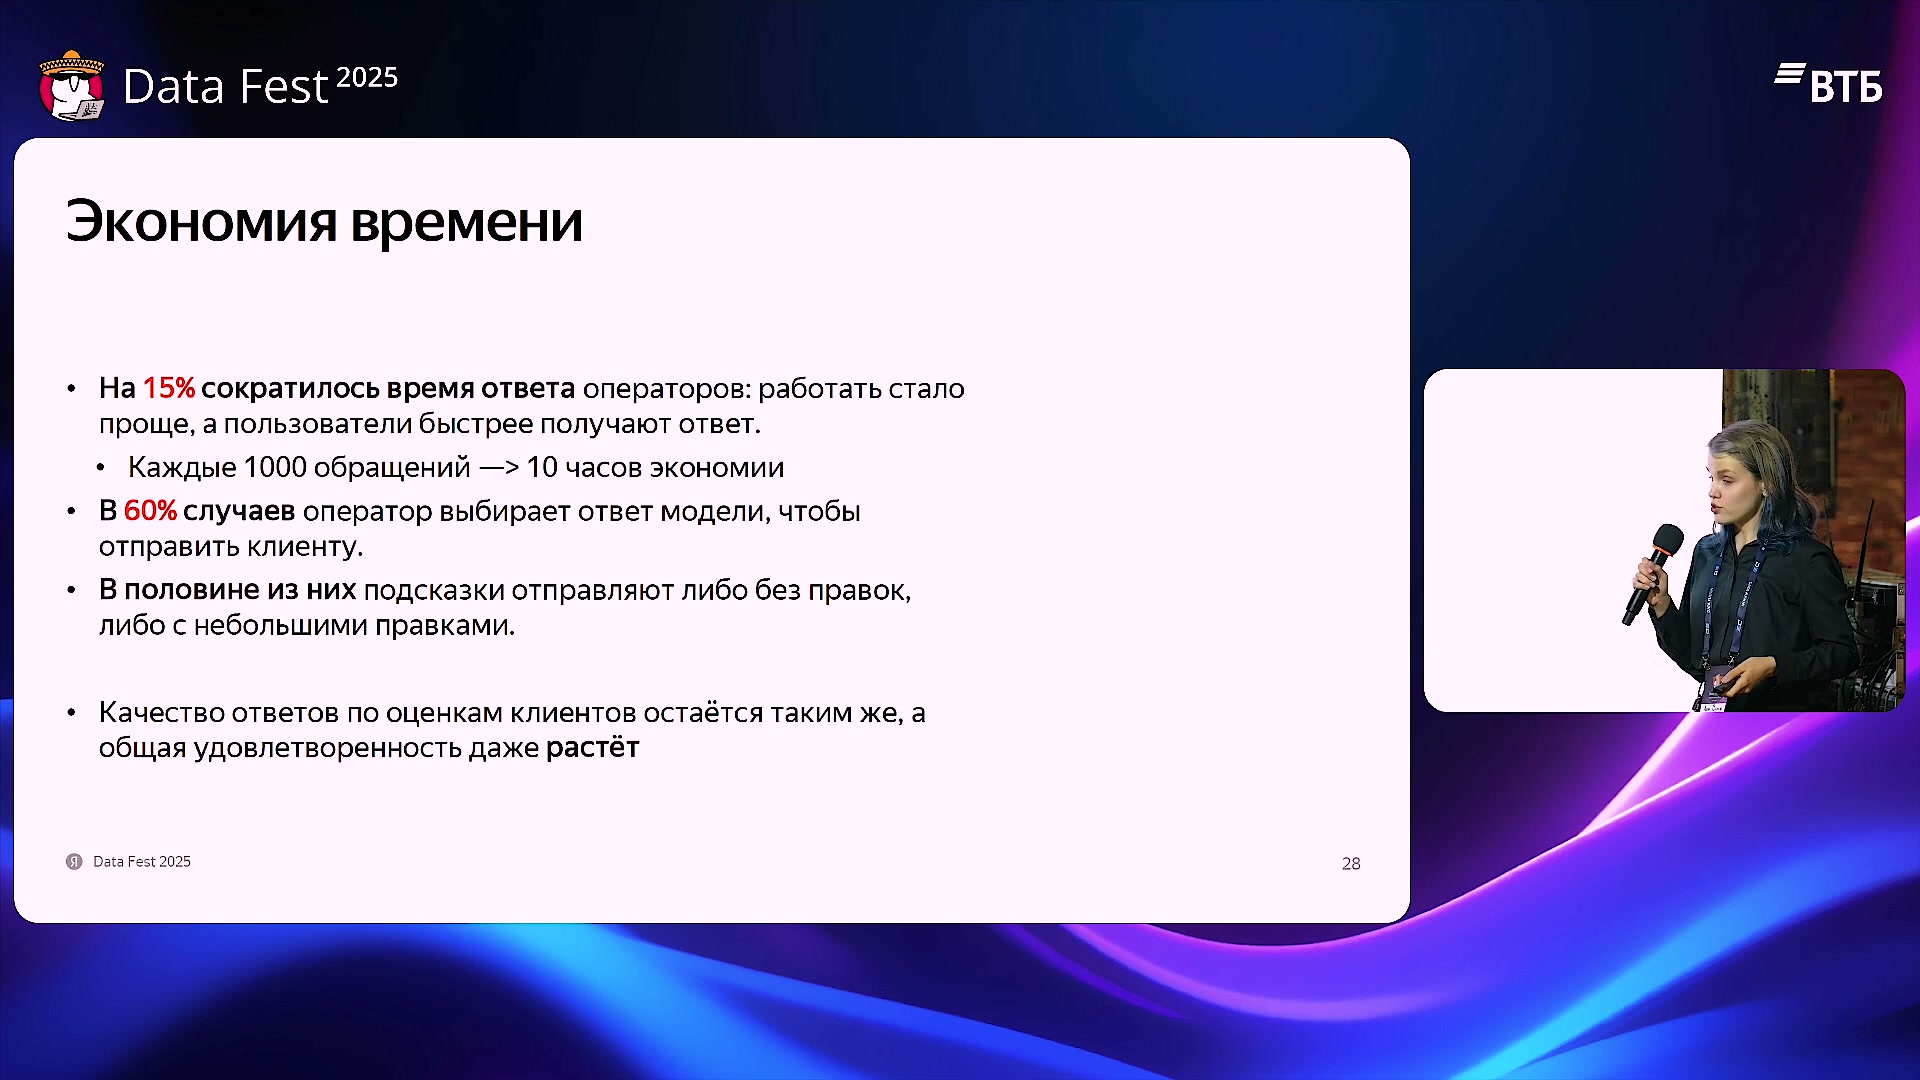
Эксплуатационные результаты по данным доклада. Качество ответов по оценкам клиентов не снизилось, общая удовлетворённость выросла без численного значения. Кадр, 16:30.
Источник: Доклад · 16:30Обратная связь клиентов и риск слепого доверия
У помощника есть риск, который не исчезает от сохранения кнопки отправки за человеком: оператор может привыкнуть принимать подсказки без внимательной проверки. В обсуждении этот риск сравнивается с потерей навыков при постоянной опоре на автопилот. Принудительный ручной набор предложенного текста команда не рассматривает как решение: он противоречит цели ускорить обслуживание.
Вместо искусственного замедления опираются на обратную связь клиентов. Отрицательная оценка, сообщение о том, что ответ не помог, или повторное открытие обращения дают сигнал для контроля качества. Затем нужно разбираться, связан ли он с работой конкретного оператора или с общей проблемой системы. Наличие этих сигналов, однако, не доказывает, что профессиональные навыки операторов сохраняются: отдельного исследования такого эффекта не описано.
Клиентские оценки действительно использовались в экспериментах, а не подменялись мнением операторов о подсказках. Команда сопоставляла работу только операторов и работу с ассистентом по ответу на вопрос о полезности помощи, положительной или отрицательной реакции либо оценке по пяти звёздам. Сообщается о сохранении качества и росте общей удовлетворённости. При этом не раскрыты размеры групп, длительность сравнения, способ их формирования и статистическая неопределённость результата.
Доклад · 00:18:00Уточнение запроса и границы автоматизации
Удачный пример с подпиской опирался на слово «платная». Без него обращение могло бы относиться и к рассылке, и к абонементу. Для таких развилок команда выбрала правило, зависящее от объёма объяснения. Если обе инструкции короткие, в ответе можно привести два варианта с явными условиями. Если каждая ветка требует длинного описания, сначала задаётся уточняющий вопрос.
Например, можно уточнить устройство — iPhone или Android — либо спросить, идёт ли речь о почтовой рассылке или автопродлении абонемента. Это не отказ из-за отсутствия документов: материалы могут быть найдены, но ещё не хватает сведений о намерении клиента. Уточнение и отказ решают разные проблемы.
Даже правильный текст не завершает все задачи поддержки. При жалобе на неверно доставленный товар может потребоваться связаться с кладовщиком. В других случаях важны человеческое участие и дополнительные выяснения. Поэтому удаление оператора из процесса не является заявленной целью. Возможность поручать внешние действия агентам обсуждается лишь предположительно, а не как реализованная часть системы.
Сокращение времени на 50% прозвучало как гипотетический ориентир в вопросе из зала. На момент доклада команда рассчитывала дойти до 20%, но это план, а не новое измерение. Достигнутый результат, сообщённый в основной части, остаётся равным 15%.
Доклад · 00:21:00Другие варианты нарезки и отбор обращений
Иерархическая нарезка не описывается как единственный проверенный вариант. Команда экспериментировала с разными способами разбиения и увеличением передаваемого контекста. Дополнительно обнаружилась необходимость чистить фрагменты от специальных символов. Однако конкретное сравнение с семантической нарезкой — разделением по смысловым границам текста — в докладе не раскрыто. Утверждать, что она оказалась хуже, оснований нет.
При отборе данных также учитывали пригодность самого обращения. Сообщение «Привет», после которого клиент закрыл чат, почти ничего не даёт для подготовки полезного ответа. В связи с фильтрацией таких примеров упоминается длина 20–30 символов, но точное условие отбора не определено однозначно. Воспроизводимого правила с фиксированным порогом в описании нет.
Другой фильтр касался обращений не в тот сервис. В поддержку главной страницы могли попадать вопросы, предназначенные другой службе. Признаком такого случая служил ответ оператора с перенаправлением в соответствующий сервис; подобные примеры не брали. Эти эвристики описывают отбор обращений, но не дают полного алгоритма удаления неподходящих операторских реплик, о котором также спрашивали в обсуждении.
Доклад · 00:23:00Длина диалога и порядок документов
Для поиска нужно построить представление переписки, поэтому длина диалога ограничена возможностями соответствующей модели. В использованных командой данных все чаты помещались в её контекст. Специальный механизм обработки переполнения в докладе не представлен.
Для возможного внедрения в другом сервисе обсуждалась обрезка истории, но сразу возникло возражение: важные исходные условия могут находиться в начале разговора. Также прозвучало предложение использовать граф связей между частями истории. Ни обрезку, ни графовое представление нельзя считать внедрёнными решениями этой системы.
Отдельный вопрос — порядок трёх найденных материалов. Метрика hitrate@3 не различает первую и третью позицию нужного документа: в обоих случаях генеративная модель его получает. Это объясняет выбор метрики, но ещё не означает, что генерация нечувствительна к порядку.
Команда проверяла этот эффект, искусственно перемешивая контексты и перенося содержащий ответ материал, например, с первого места в конец. Наблюдалась небольшая просадка без указанного численного значения. По словам спикера, её устранили добавлением перемешанных контекстов в обучение. Это результат конкретной проверки, а не универсальная гарантия независимости любой модели от расположения документов.
Доклад · 00:26:00Очистка базы: технические фильтры и решения владельцев
Сохранённый в базе документ не обязательно остаётся рабочей инструкцией. Устаревшие страницы могли не удалять ради идентификаторов и связности. Другие страницы служили оглавлениями: оператор находил в них ссылку на нужный материал, но сами они почти не содержали ответа. Такие особенности объясняют, почему нарезки текста было недостаточно.
Очистка сочетала эвристики и сведения от владельцев базы. Большое количество ссылок считали признаком страницы-оглавления. Применяли и языковой фильтр: в рассматриваемой конфигурации исключали документы на турецком и казахском языках, что спикер объясняла ограничениями использовавшейся YandexGPT. Это характеристика описанного решения, а не утверждение о возможностях всех последующих версий модели.
У владельцев базы запросили перечень служебных пометок, среди которых названы «устаревшее», «не использовать», «NDA» и «не отправлять без согласования». Их использовали при очистке; точная обработка каждой категории в докладе не раскрыта. Решение о том, что документ больше не должен применяться операторами, оставалось за людьми, которые ведут базу знаний.
Таким образом, алгоритмическое выявление малополезного текста не заменяло ответственность за содержание инструкций. Команда использовала уже существующие решения владельцев о статусе материалов и дополняла их фильтрами пригодности для языковой модели.
Доклад · 00:28:00Компенсации: контроль оператором ещё не измерение расходов
Клиентская удовлетворённость не охватывает все последствия ответа для сервиса. В обсуждении возникает гипотеза: если слишком часто предлагать недовольным клиентам промокоды, оценки могут улучшиться, но расходы на компенсации вырастут. Это возможный конфликт целей, а не обнаруженное поведение системы.
Команда прямо сообщает, что такой эксперимент не проводила. В действующей схеме оператор остаётся ответственным за окончательный ответ: может удалить предложение промокода, когда оно неуместно, или добавить его, когда компенсация нужна. Обсуждается возможность отдельного синтетического эксперимента в изолированных условиях, но не результаты такой проверки.
Из этого следует ограничение эксплуатационного вывода. Сохранение человека объясняет, кому поручен контроль решения, но не доказывает отсутствие роста компенсационных расходов. Заявленная экономия времени и сохранение клиентских оценок не заменяют измерения этой стороны работы поддержки.
Доклад · 00:30:00Итог: от обращения клиента до ответа оператора
Команда Яндекса начала не с замены человека, а с разделения работы: модели быстрее находят и перерабатывают текст, оператор разбирает ситуацию и отвечает клиенту. Для этого пришлось сохранить целостность шаблонов в базе, улучшить попадание нужных материалов в первые три результата и подготовить примеры генерации, где ответ подтверждается приложенным контекстом. Отдельная проверка ответов помогла уточнить стиль и поведение при недостатке информации.
Изменения были связаны друг с другом: бессмысленно требовать точного ответа по оборванному шаблону или учить генерацию на реплике, основание которой не удалось найти. Поэтому итоговая система опирается не только на языковую модель, но и на подготовку документов, проверку поиска на конкретных диалогах и возможность не предлагать ответ вовсе.
- 01
Получить контекст обращения
Система получает переписку и доступные сведения о клиенте, устройстве или заказе.
- 02
Найти материалы
По векторному представлению переписки поиск отбирает подходящие фрагменты подготовленной базы знаний.
- 03
Выбрать три фрагмента
Ранжирующая модель меняет порядок кандидатов; первые три становятся материалом для ответа.
- 04
Подготовить черновик
Генеративная модель получает инструкцию, переписку, метаданные и найденные материалы и составляет подсказку.
- 05
Отфильтровать отказ
Если регулярное выражение распознаёт сообщение о недостатке информации, подсказку не показывают оператору.
- 06
Оставить решение человеку
Оператор решает, использовать ли подсказку, редактирует её при необходимости и отправляет ответ клиенту.
В описанных результатах hitrate@3 вырос с 0,34 до 0,7, а среднее время от обращения до ответа клиенту сократилось на 15%. Это разные уровни оценки: наличие нужного документа ещё не гарантирует правильного ответа. Операторы выбирали подсказку в 60% случаев, но точный знаменатель этой доли не раскрыт. По клиентским оценкам качество сохранилось, удовлетворённость выросла без указанного численного значения.
Полученный результат относится к помощнику, а не автономной поддержке. Случаи вне базы, действия за пределами переписки и решение о компенсации остаются за человеком. Влияние на расходы по компенсациям не измеряли, а сокращение времени на 20% обозначили как дальнейший ориентир.
Доклад · 00:00:00