Разбор готов
Wildberries: один визуальный энкодер для множества проверок
На маркетплейсе нужно проверять изображения в карточках товаров на разные нарушения. Когда для каждой новой проверки появляется отдельная тяжёлая модель, растут расход видеопамяти, число сервисов и время запуска изменений. В докладе Дмитрий Колесников рассказывает, как Wildberries пришёл к общей обработке изображения и небольшим отдельным классификаторам. Важная часть истории — почему объединения сервисов оказалось недостаточно и как команда проверяет новую модель до включения в рабочий поток.
Полезно, если вы запускаете несколько CV-моделей на общей инфраструктуре, добавляете новые проверки контента или настраиваете передачу спорных случаев модераторам. Разбор опирается на оригинальные слайды доклада.
Рекомендуем. Хорошо виден путь от набора отдельных моделей к общей архитектуре и процессу запуска новых проверок.
Слайды · на русском
Как мы автоматизировали модерацию карточек товаров с помощью Computer Vision в WildberriesОткрыть оригинальные слайдыДмитрий Колесников, HighLoad++ 2025 · Опубликовано: 7 ноября 2025 г.
Почему понадобилось объединение
Каждая проверка отвечает на свой вопрос об изображении. При независимой реализации одни и те же данные приходится подготавливать и пропускать через тяжёлую модель несколько раз. По мере роста числа проверок сложнее становится и эксплуатация, и добавление новой функциональности.
Ежедневная нагрузка: более 12 млн карточек, около 50 млн изображений и 500 тысяч видео. Разрозненные сервисы дублировали обработку; одна модель занимала около 1,75 ГБ видеопамяти.
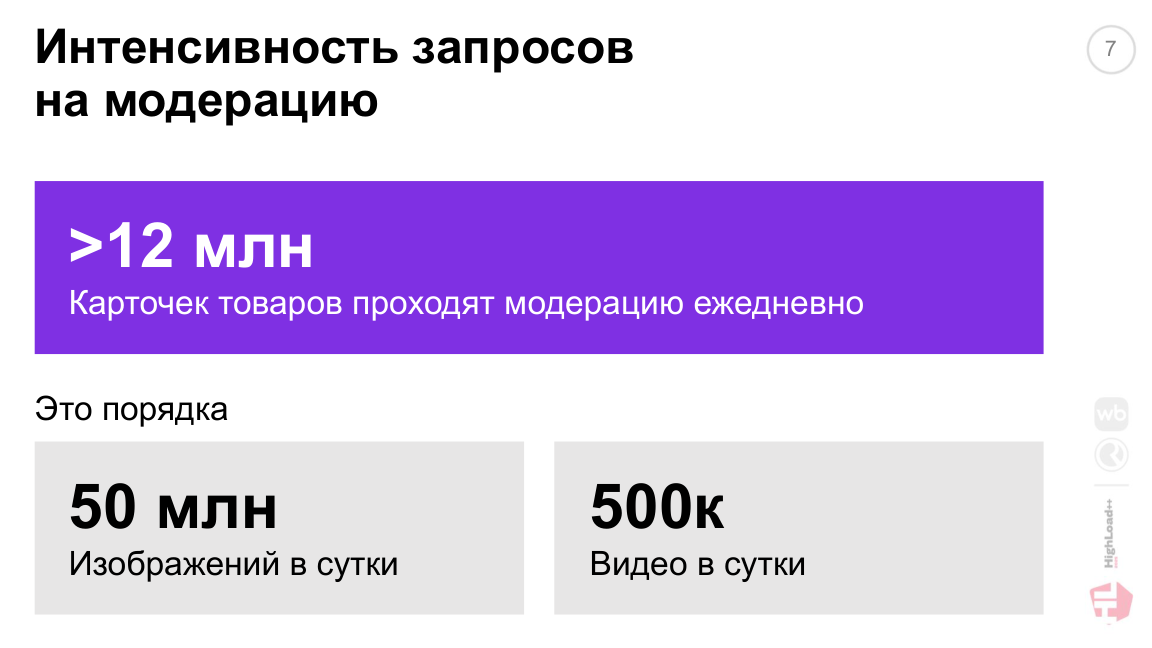
Слайд 7: объём модерации на момент доклада.
Источник: WildberriesЕдиный вызов ещё не экономит память
Сначала команда оптимизировала выполнение уже существующих моделей. Их перевели в TensorRT — среду NVIDIA для ускоренного применения нейросетей — и использовали FP16, то есть вычисления с пониженной точностью. Подготовку изображений перенесли в DALI, а выполнение организовали через сервер моделей Triton.
Следующим шагом несколько операций объединили в ансамбль Triton: подготовка данных и модели вызываются одной цепочкой. Это сократило сетевые обращения, но не устранило главную причину расхода памяти. Внутри цепочки по-прежнему оставались отдельные тяжёлые модели. Чтобы изменить расход ресурсов, пришлось менять саму архитектуру.
Слайды 15–20, 32–34Общий энкодер и отдельные головы
Общая модель CLIP преобразует изображение в набор чисел, описывающих его содержание. Эта часть называется энкодером. После неё работают небольшие классификаторы: каждый использует полученные признаки, чтобы проверить своё нарушение. Такие отдельные выходные модули часто называют головами.
Теперь тяжёлая обработка изображения выполняется один раз, а новую проверку можно добавить небольшим модулем поверх общих признаков. В Triton остаётся цепочка из подготовки изображения, энкодера и голов. На исходных слайдах ниже показаны её устройство и сравнение памяти.
Это решение зависит от того, насколько общие признаки подходят конкретной проверке. Наличие одного энкодера само по себе не доказывает качество всех новых классификаторов: для каждого всё равно нужны данные и проверка ошибок.
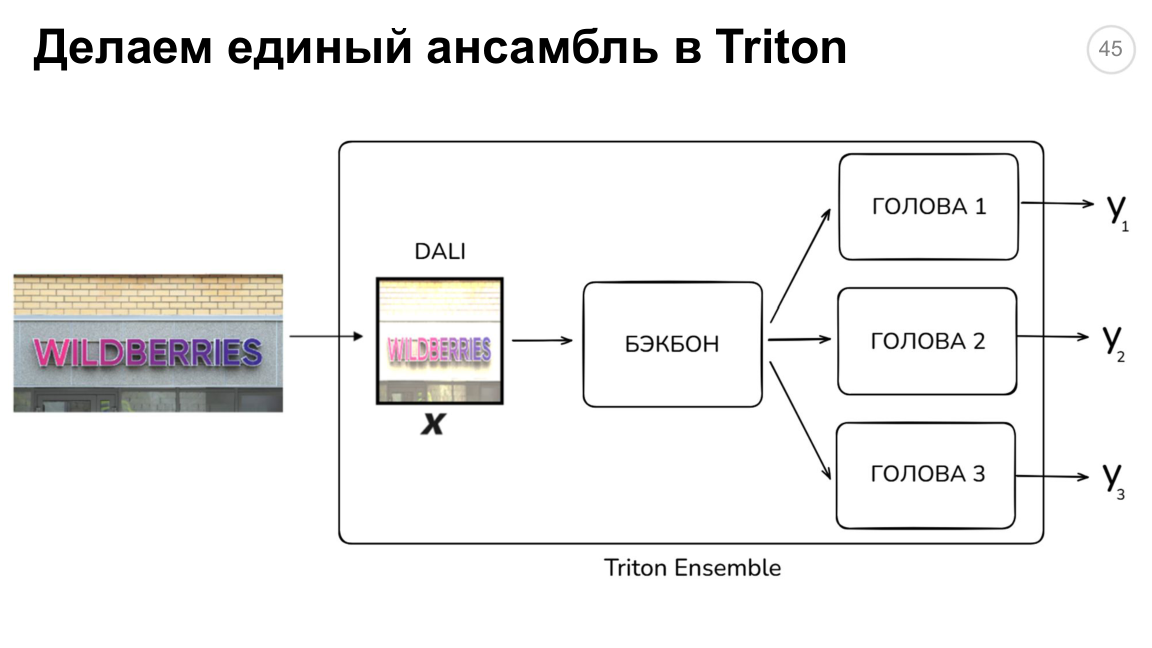
Слайд 45: общий энкодер и несколько голов.
Источник: Wildberries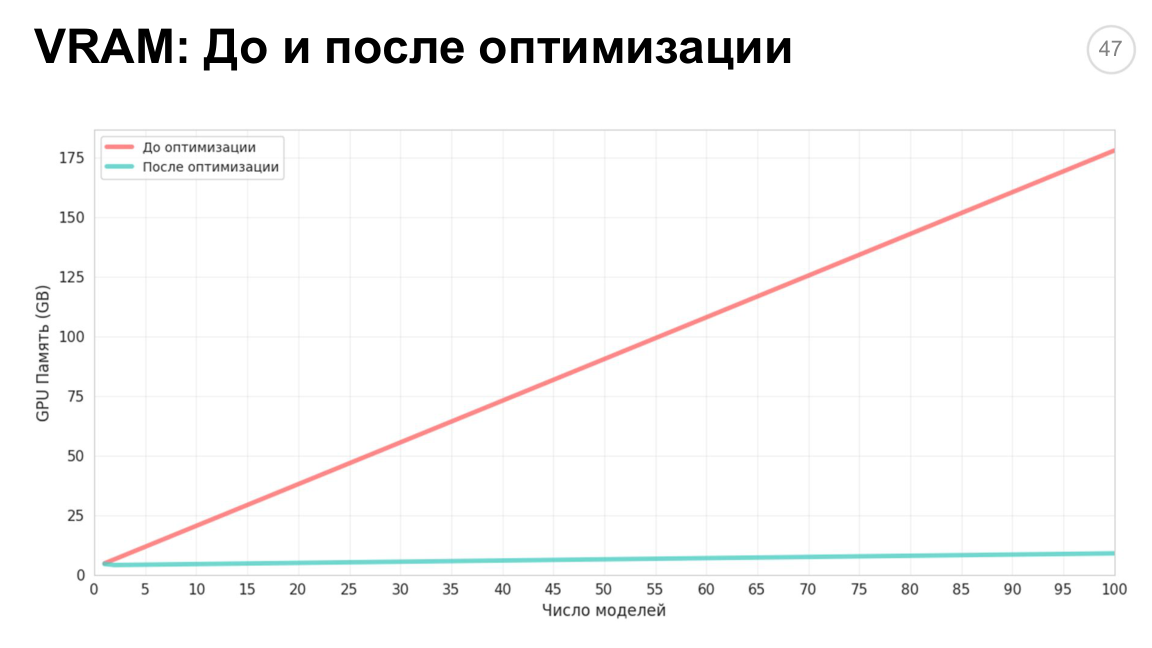
Слайд 47: сравнение расхода GPU-памяти.
Источник: WildberriesПеред включением проверяют нагрузку
Архитектура модели — только часть системы. В докладе показан процесс через ClearML: обучение, преобразование модели для выполнения и проверка на историческом потоке. Так команда оценивает будущие срабатывания до включения проверки.
Порог, после которого результат считается нарушением, задаётся в административном интерфейсе. От него зависят и ошибки автоматической проверки, и объём дальнейшей модерации. Для перепроверки можно подключить дополнительного проверяющего на основе LLM; пограничные случаи передают человеку.
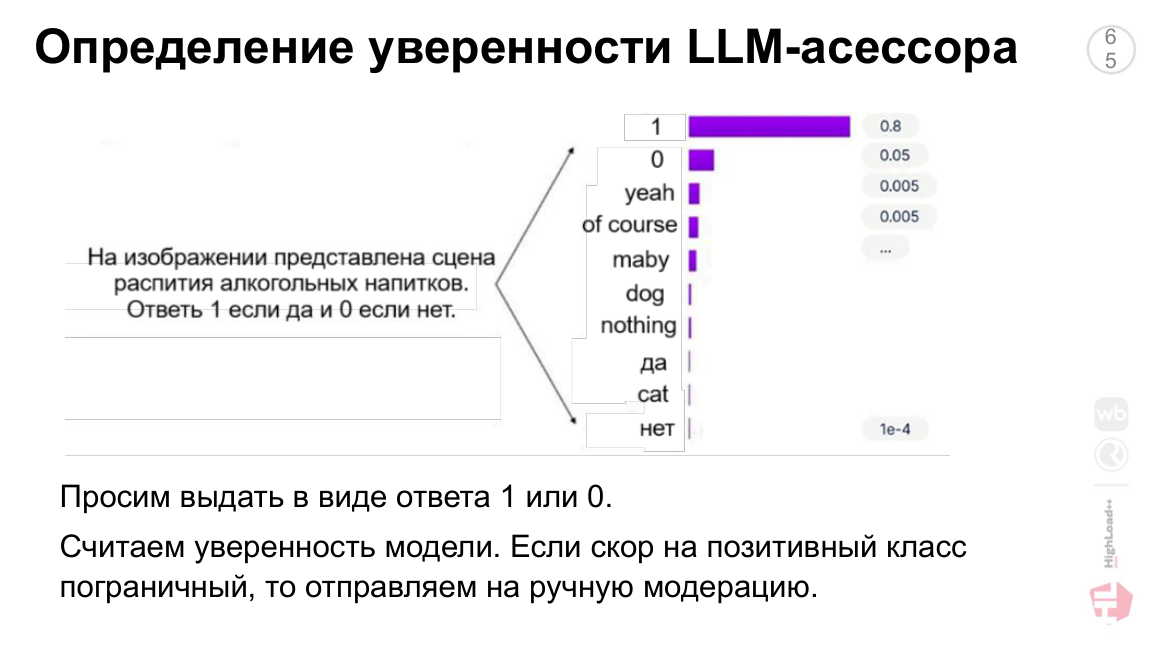
Слайд 65: решение о дополнительной ручной проверке.
Источник: WildberriesЧто изменилось и что ещё планируют
Голова занимает в среднем 15 МБ; разработка новой модели сократилась до недели. Дообучение общего энкодера на контенте Wildberries и автоматическое переобучение всех голов — планы. Разбор основан на полной презентации, не на расшифровке видео.
Главный результат — более дешёвое добавление новых проверок поверх общей обработки изображения. Его нельзя свести только к размеру головы: остаются общий энкодер, инфраструктура и контроль качества каждого нарушения. Перечисленные в конце презентации дальнейшие улучшения не считаем уже внедрёнными.
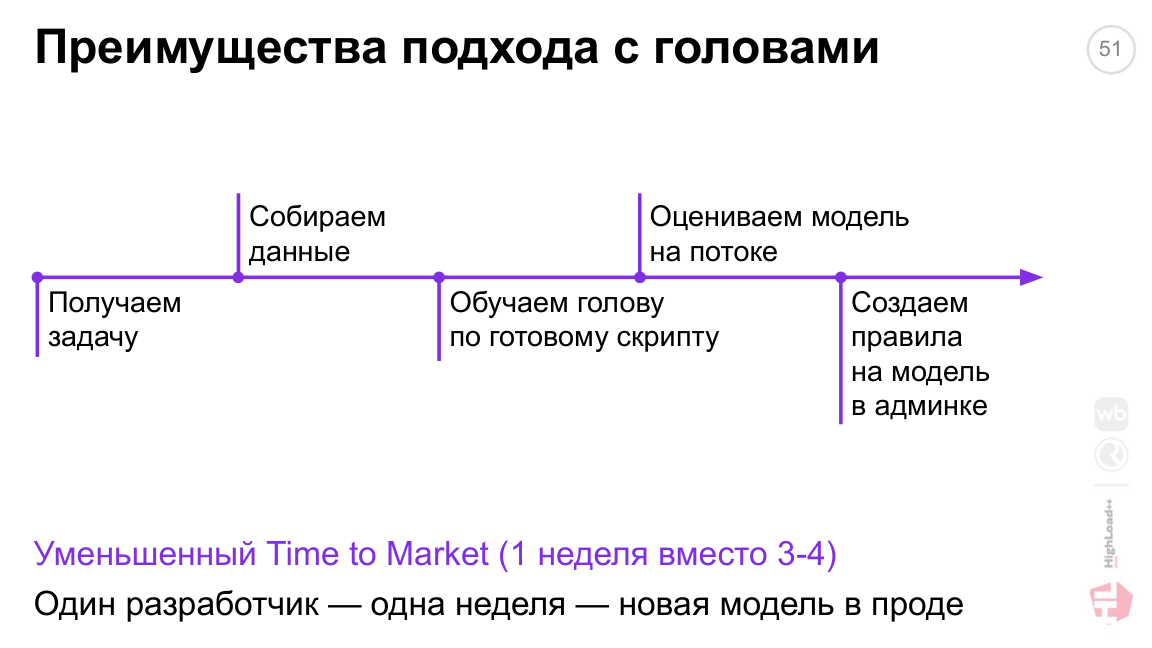
Слайд 51: изменение процесса разработки.
Источник: WildberriesИтог: одна обработка изображения, несколько проверок
Мы разобрали, почему набор отдельных CV-моделей стал дорогим способом модерации карточек. Перевод в TensorRT и объединение вызовов через Triton улучшили выполнение, но сами по себе не убрали дублирование тяжёлых моделей. Архитектурное решение Wildberries — один общий энкодер изображения и небольшие классификаторы для отдельных нарушений. Новая проверка добавляется поверх уже вычисленных признаков.
- 01
Изображение карточки
Система получает изображение, которое нужно проверить на несколько видов нарушений. Один и тот же исходный материал используется всеми проверками.
- 02
Подготовка данных
Изображение приводится к входному формату модели. Подготовка организована через DALI в общей цепочке выполнения Triton.
- 03
Общий энкодер
CLIP преобразует изображение в признаки. Эта тяжёлая часть выполняется один раз и обеспечивает вход для нескольких классификаторов.
- 04
Классификаторы нарушений
Небольшие выходные модули — головы — оценивают каждый свой тип нарушения по общим признакам. Новая голова требует собственной проверки качества.
- 05
Решение и перепроверка
Оценки сравниваются с настроенными порогами. Для дополнительной проверки можно подключить LLM-асессора; пограничные случаи передают человеку.
До включения новой проверки команда обучает и преобразует модель, затем проверяет её на историческом потоке. Так можно оценить будущие срабатывания и нагрузку на модерацию. Это отдельный процесс подготовки модели: обучение не запускается заново для каждой картинки.
Автор сообщает о среднем размере головы 15 МБ видеопамяти и сокращении разработки новой модели с трёх–четырёх недель до одной. Размер головы не равен памяти всей системы: остаются общий энкодер и инфраструктура. В разборе нет единой численной метрики точности всех нарушений — её нельзя вывести из экономии памяти. Дообучение общего энкодера на контенте Wildberries и автоматическое переобучение голов в конце презентации обозначены как дальнейшие планы.
Источник: слайды 45–51, 59–66 и 70