Разбор готов
Как OpenAI устроила внутреннего агента для анализа данных
Во внутренней платформе OpenAI десятки тысяч наборов данных, и аналитическая задача часто начинается не с написания SQL, а с поиска правильной таблицы и понимания её смысла. Две таблицы могут выглядеть почти одинаково, но учитывать разные категории пользователей, обновляться по-разному или требовать разных фильтров; ошибка в соединении или незамеченный null способен сделать правдоподобный результат неверным. Чтобы сотрудники могли задавать такие вопросы на естественном языке и проходить весь путь от поиска данных до проверяемого вывода, OpenAI построила собственного data agent. Его ключевая часть — не только GPT-5.2, а система контекста вокруг модели: сведения о таблицах, экспертные аннотации, код их построения, документы компании, память прошлых исправлений и живой доступ к системам платформы данных.
Материал полезен ML- и data-инженерам, аналитикам и разработчикам LLM-агентов, которым нужно понять, почему одного text-to-SQL недостаточно для надёжной работы с корпоративными данными. Главный вопрос главы: какой контекст, поиск, проверка и контроль доступа нужны вокруг языковой модели, чтобы она могла не просто написать SQL, а разобраться, какие данные использовать и насколько результату можно доверять.
Статья · на английском
Inside our in-house data agentBonnie Xu, Aravind Suresh, Emma Tang · Опубликовано: 29 января 2026 г.
Почему обычного доступа к SQL оказалось недостаточно
Платформа данных OpenAI обслуживает более 3,5 тыс. внутренних пользователей и охватывает более 600 ПБ данных в 70 тыс. наборов данных. Эти числа описывают среду, внутри которой работает агент. При таком масштабе одна из первых проблем аналитика — вообще понять, какую таблицу использовать. В статье приводится жалоба сотрудника на множество похожих таблиц: одни включают определённые категории пользователей, другие нет, поля пересекаются, а различия не всегда очевидны из названия.
Даже после выбора таблиц задача не заканчивается. Неправильное соединение многие-ко-многим может раздуть строки, неверный фильтр — изменить выборку, а необработанный null — тихо испортить расчёт. Поэтому цель агента шире генерации SQL. Авторы хотят снять с аналитика часть работы по поиску источников и разбору их семантики, чтобы больше времени оставалось на определение метрик, проверку гипотез и принятие решений.
Иллюстрация с запросом более чем на 180 строк показывает именно сложность проверки реальной аналитической логики: по длинному SQL трудно быстро убедиться, что выбраны правильные таблицы и столбцы. Число 180 не описывает средний запрос агента и не является метрикой его качества.
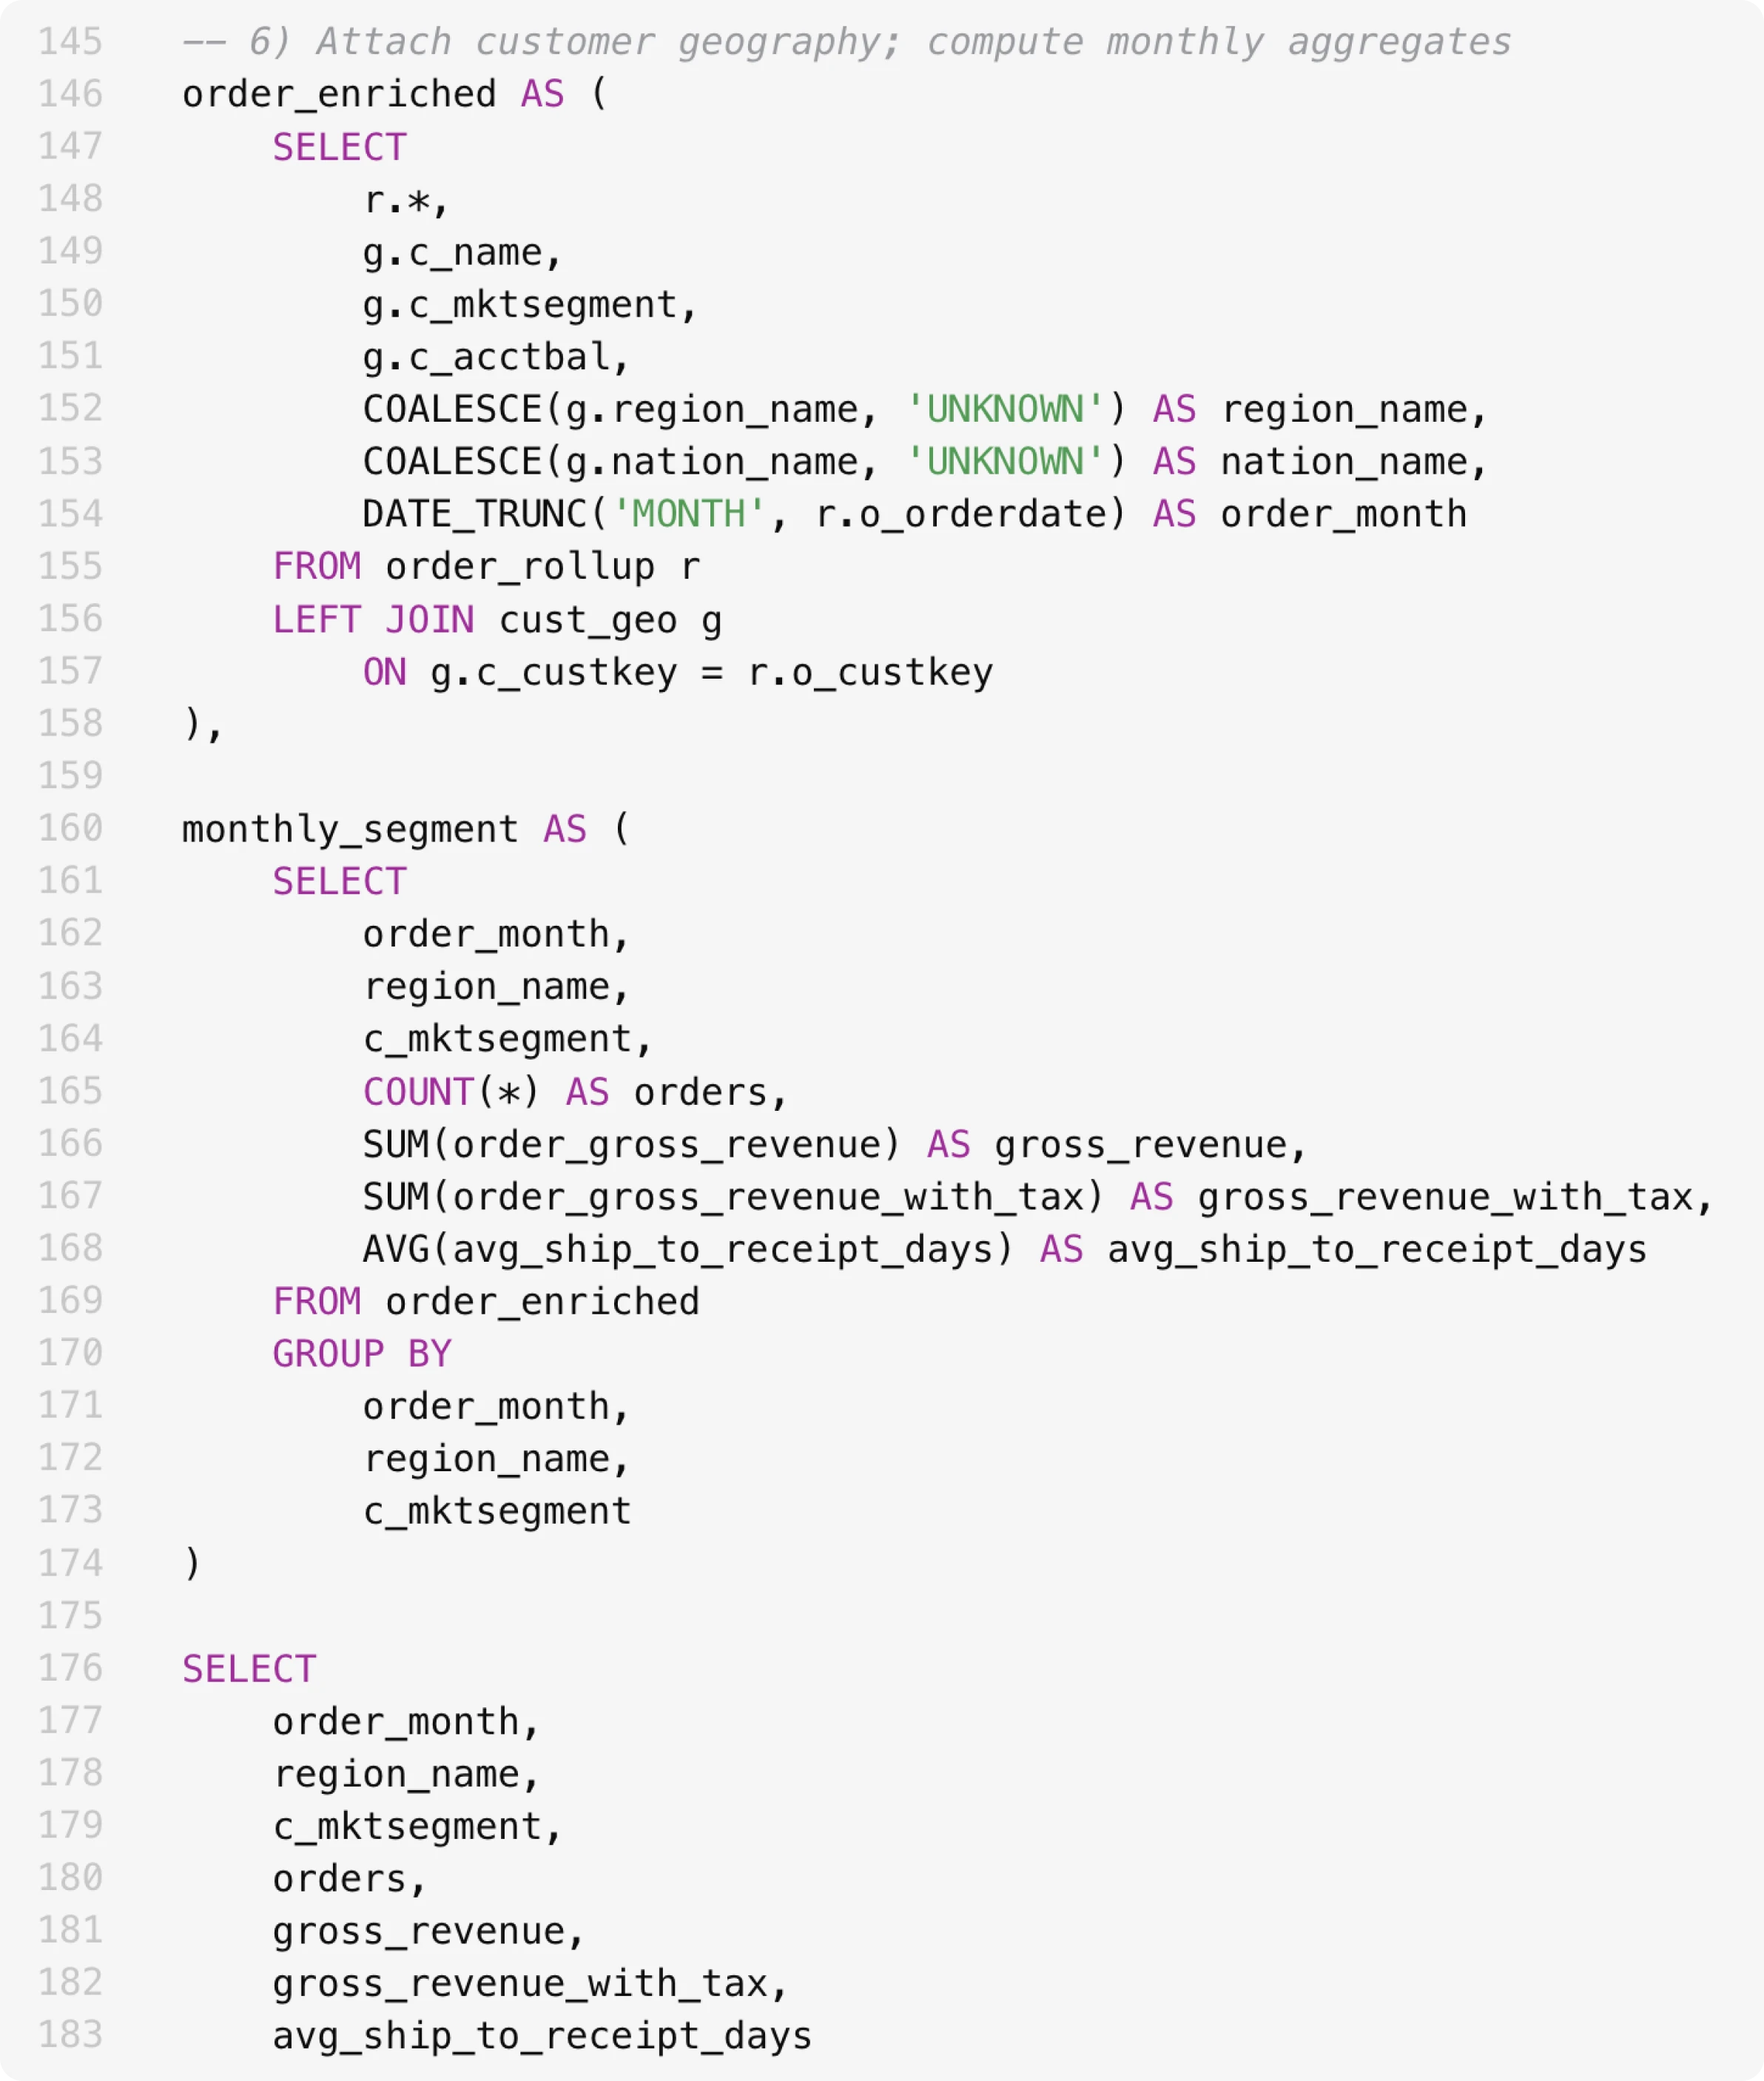
Исходный пример OpenAI: запрос длиннее 180 строк трудно проверить без понимания таблиц и фильтров.
Источник: Оригинальная иллюстрация OpenAIСквозной пример: ненадёжные поездки такси
Авторы показывают работу агента на тестовых данных о такси Нью-Йорка. Пользователь спрашивает, какие пары ZIP-кодов места посадки и высадки наиболее ненадёжны: где сильнее всего расходятся типичное и худшее время поездки и когда возникает такая вариативность. Это намеренно не запрос вида «посчитай одну агрегацию». Чтобы ответить, нужно понять постановку, найти подходящие данные, выбрать способ сравнения, выполнить несколько запросов и интерпретировать результат.
На иллюстрации с ходом анализа видно, зачем агенту нужен цикл проверки. Он не обязан один раз составить запрос и принять полученный результат за истину. Если промежуточный шаг выглядит подозрительно — в статье приводится пример нулевого результата из-за неверного соединения или фильтра — агент может разобраться в причине, изменить подход и повторить вычисление, сохраняя контекст предыдущих шагов.
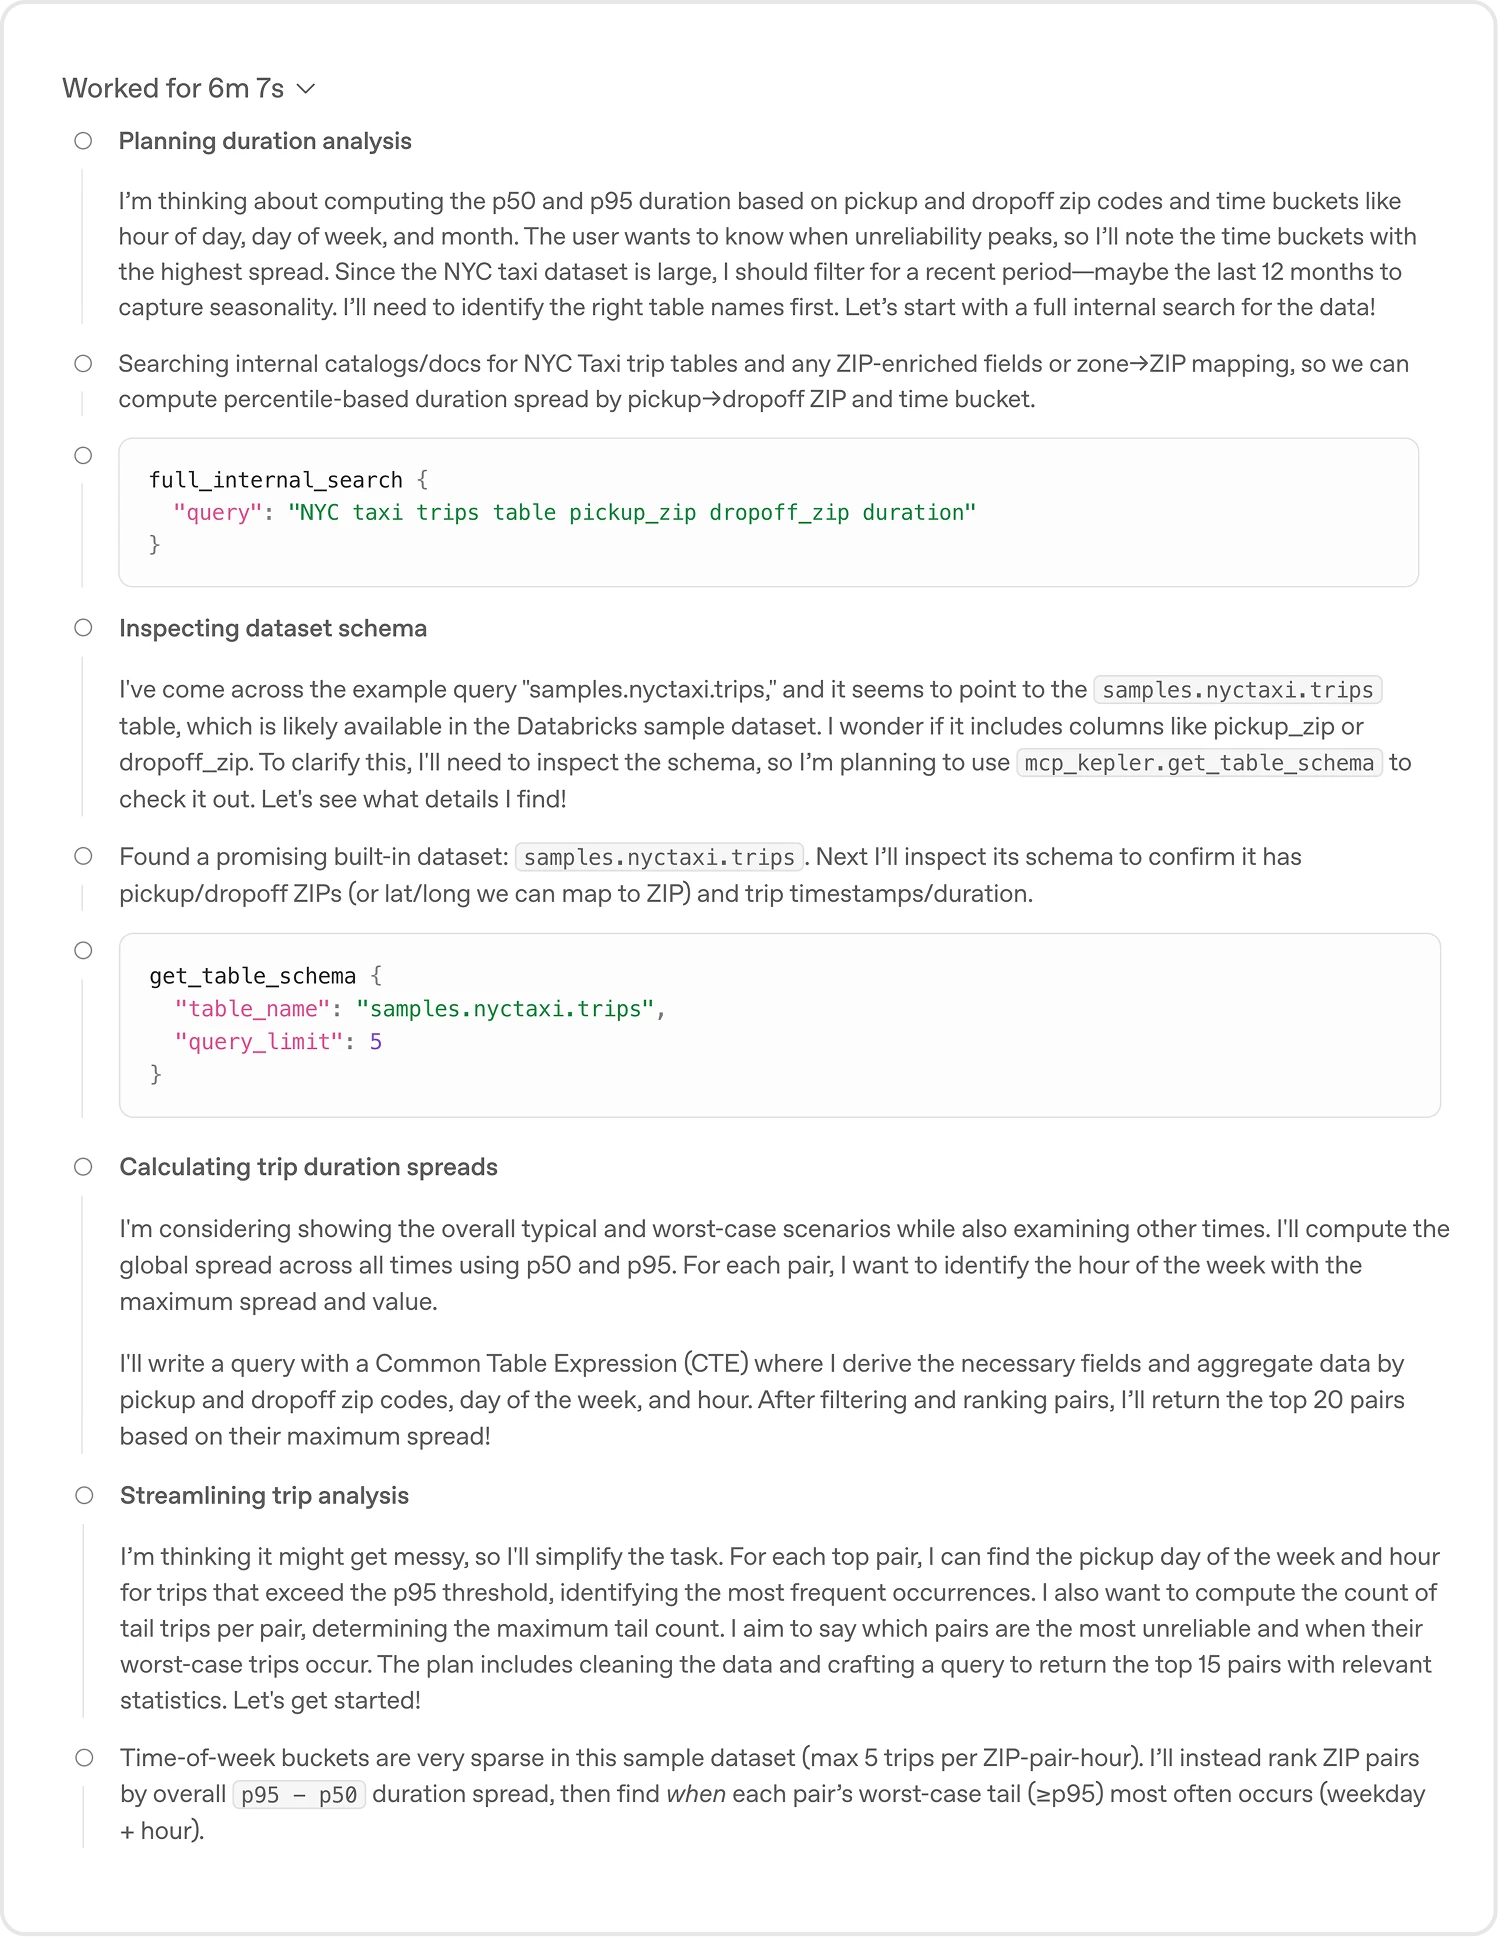
Агент ищет набор данных, проверяет схему и уточняет способ сравнения длительности поездок.
Источник: Оригинальная иллюстрация OpenAIОт вопроса до проверяемого результата
Текущая версия агента работает на GPT-5.2 и доступна там, где сотрудники уже выполняют работу: в Slack, веб-интерфейсе, IDE, Codex CLI через MCP и во внутреннем приложении ChatGPT через MCP-коннектор. Архитектурно модель является управляющей частью системы: она разбирает задачу, выбирает следующие действия и обращается к разрешённым источникам и инструментам.
Агент охватывает весь аналитический процесс: ищет данные, выполняет SQL, может публиковать блокноты и отчёты, обращается к внутренним знаниям компании и при необходимости использует внешнюю информацию из интернета. При этом ответ не должен скрывать путь к данным. Выполненные запросы связываются с исходными результатами, а рядом с ответом агент суммирует существенные предположения и шаги выполнения, чтобы человек мог проверить анализ.
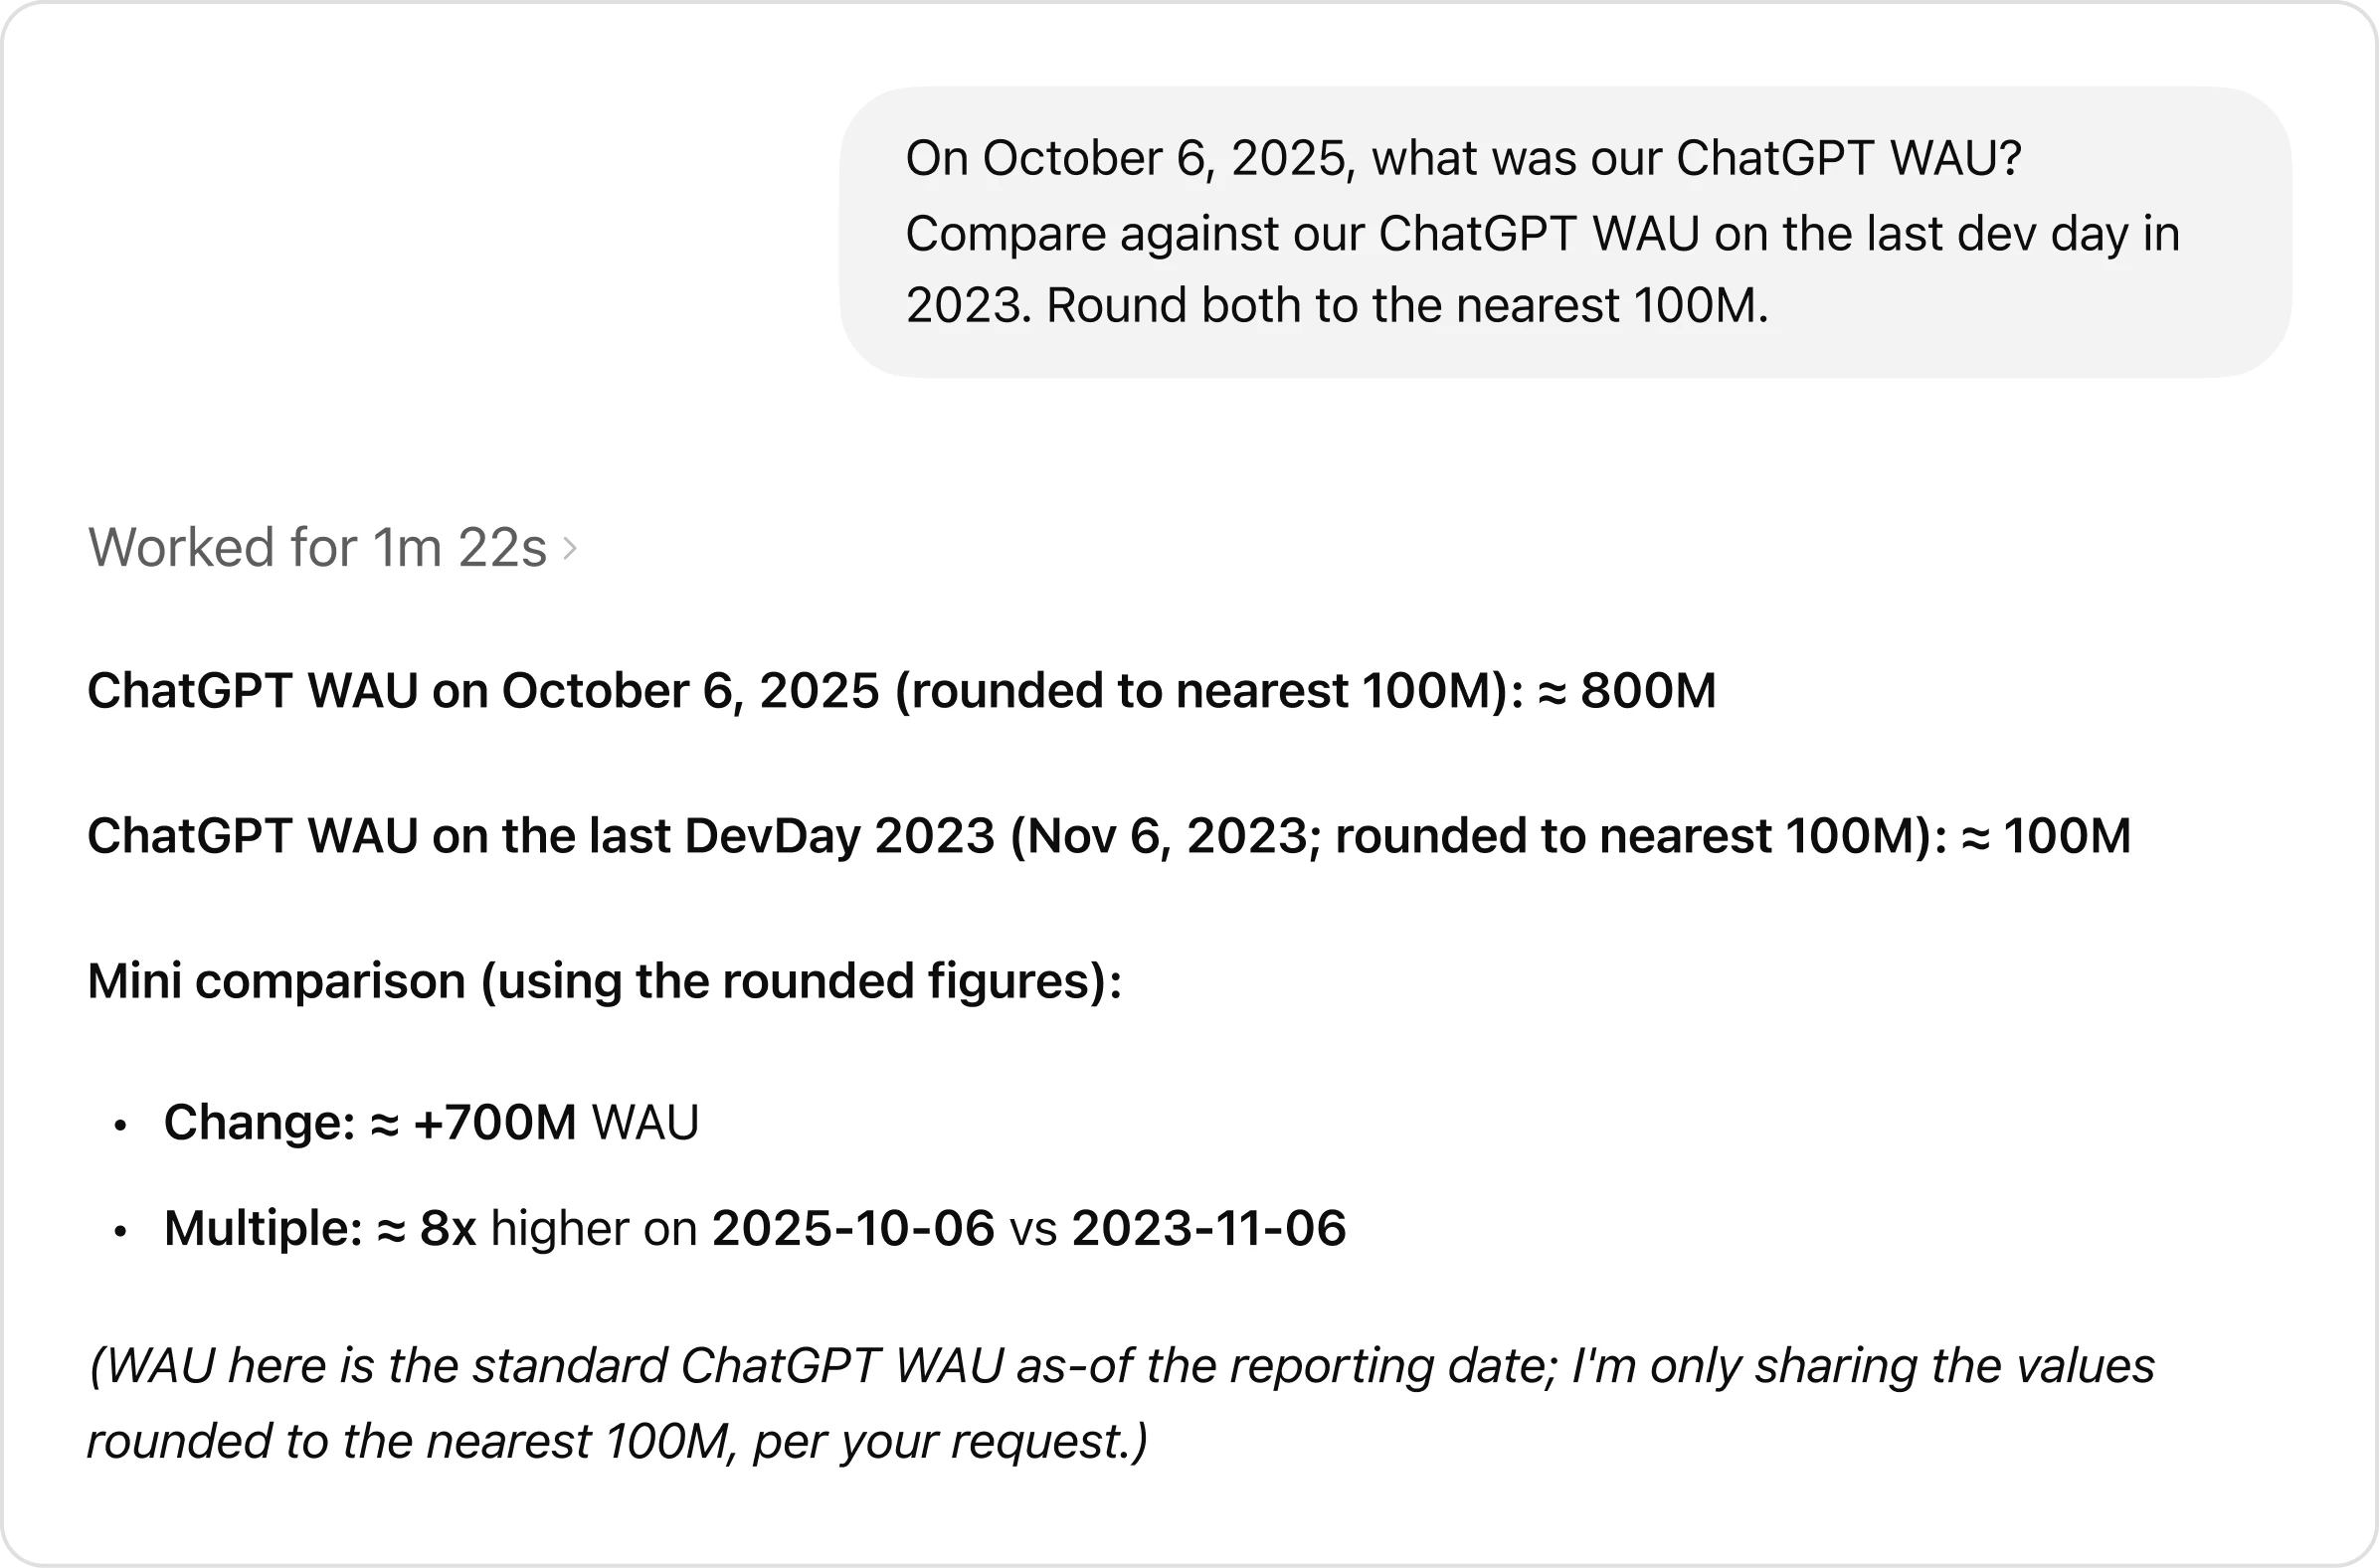
Пример интерфейса результата: агент показывает вывод и оставляет возможность проверить данные и запрос.
Источник: Оригинальная иллюстрация OpenAI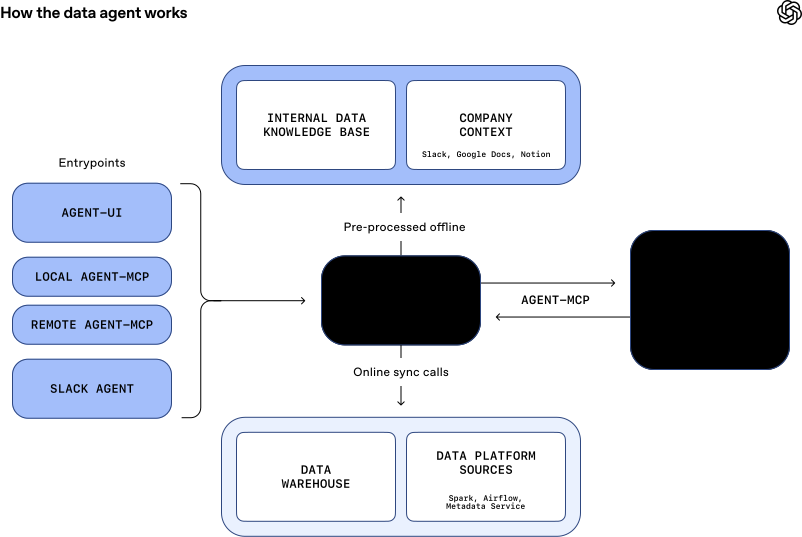
Исходная схема архитектуры: сотрудник обращается к агенту через несколько рабочих интерфейсов.
Источник: Оригинальная иллюстрация OpenAIПочему качество упирается в контекст
Сильная языковая модель сама по себе не знает внутреннюю семантику данных компании. Она может увидеть несколько похожих названий таблиц, неправильно понять внутренний термин или посчитать показатель по выборке, которая не соответствует вопросу. Поэтому архитектура агента построена вокруг нескольких независимых источников контекста, каждый из которых закрывает свой класс неопределённости.
В статье выделены шесть слоёв: фактическое использование таблиц, аннотации экспертов, сведения из кода, институциональные знания компании, память накопленных исправлений и контекст, получаемый непосредственно во время выполнения. Схема с шестью слоями важна не как список подключённых баз, а как разделение ролей: одни сведения можно подготовить заранее, другие появляются только в документах или коде, а самые свежие приходится проверять живым запросом.
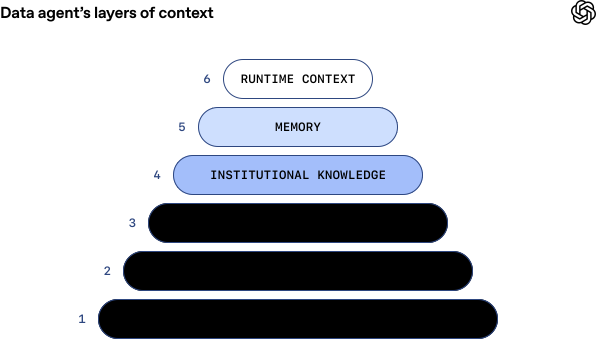
Авторская схема: использование таблиц, аннотации, код, документы, память и живой контекст.
Источник: Оригинальная иллюстрация OpenAIСлой 1: как таблицы устроены и как ими реально пользуются
Первый уровень начинается с метаданных схемы: названий столбцов, типов данных и происхождения таблиц. Lineage — связи вверх и вниз по конвейеру данных — помогает понять, из каких источников появилась таблица и какие другие наборы зависят от неё. Этого уже достаточно, чтобы не воспринимать каждую таблицу как изолированный набор колонок.
К метаданным добавляется история предыдущих запросов. Она показывает, какие таблицы обычно используются вместе и как сотрудники уже строили соединения. Это практическая подсказка, но не окончательная истина: прошлый SQL говорит, как данными пользовались, а не обязательно полностью объясняет, что они означают.
Уровень №1: Использование таблицСлой 2: знания людей о смысле данных
Схема и история запросов не объясняют все договорённости вокруг данных. Поэтому эксперты добавляют описания таблиц и столбцов: зачем они существуют, какой бизнес-смысл имеют поля, какие ограничения нужно помнить и в каких случаях таблицу нельзя интерпретировать буквально.
Этот слой особенно важен для различения похожих источников. Если две таблицы имеют почти одинаковые колонки, выбор между ними может зависеть от правила, которое нигде не зашито в тип данных. Человеческая аннотация превращает такое неявное знание в контекст, доступный агенту.
Уровень №2: Аннотации человекаСлой 3: искать смысл таблицы в коде, который её создаёт
Следующий источник — код, формирующий набор данных. Codex используется для разбора определения таблицы на уровне программной логики. Это позволяет получить сведения, которых может не быть в схеме: например, как именно извлекается аналитическое событие, какие данные исключаются, какова детализация результата и с какой частотой обновляется таблица.
Такой анализ также расширяет картину использования за пределы SQL. Таблица может участвовать в Spark-задачах, Python-коде и других системах данных. Код помогает различать источники, которые внешне похожи, но отличаются критическим правилом формирования. В статье приводится пример способности определить, включает ли таблица только определённый класс трафика ChatGPT.
Преимущество этого слоя в том, что контекст можно обновлять вместе с изменениями кодовой базы, а не поддерживать всё описание вручную. При этом статья не утверждает, что анализ кода заменяет человеческую документацию: эти источники дополняют друг друга.
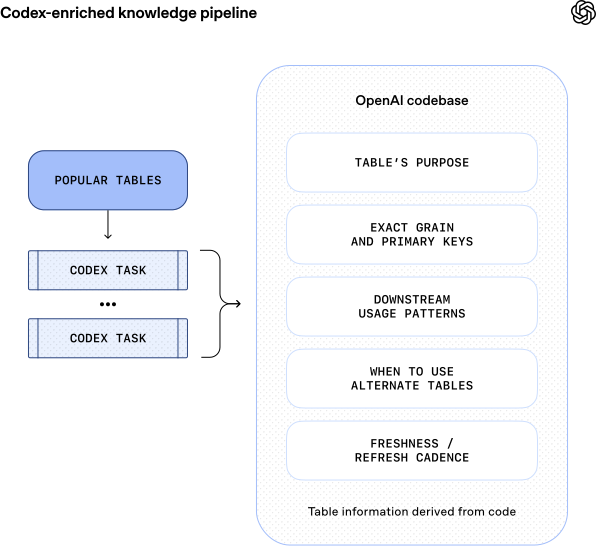
Codex извлекает из кода происхождение таблиц, детализацию, правила и связанные системы.
Источник: Оригинальная иллюстрация OpenAIСлой 4: решения и определения, которых нет в хранилище
Часть необходимых знаний существует не в таблицах и не в коде, а в рабочей документации. Агент может обращаться к Slack, Google Docs и Notion. Там находятся сведения о запусках, инцидентах надёжности, внутренних кодовых названиях и инструментах, а также канонические определения важных метрик и логика их вычисления.
Эти документы загружаются, превращаются в векторные представления и сохраняются вместе с метаданными и правами доступа. Во время поиска отдельный сервис учитывает разрешения и кеширование. Поэтому наличие документа в общем корпусе ещё не означает, что его содержимое можно показать любому пользователю.
Уровень №4: Институциональные знанияСлой 5: помнить исправления, которые трудно вывести заново
Память предназначена не для хранения всего диалога навсегда, а прежде всего для неочевидных правил, которые критичны для корректности анализа. Если пользователь исправил агента или во время работы обнаружилось важное ограничение, знание можно сохранить и использовать в следующих запросах, чтобы не повторять ту же ошибку.
В статье приведён пример с аналитическим экспериментом. Для правильной фильтрации нужно было сопоставить данные с конкретной строкой, определённой в экспериментальном шлюзе; приблизительное сопоставление строк здесь было бы ошибкой. Такой нюанс сложно каждый раз восстановить только по схеме таблицы, поэтому он подходит для памяти.
Агент предлагает сохранить полезное исправление после разговора, а пользователь также может создавать и редактировать записи вручную. Статья различает глобальную и личную память. Это механизм повторного использования контекста, а не заявление об онлайн-обучении весов GPT-5.2 на каждом диалоге.
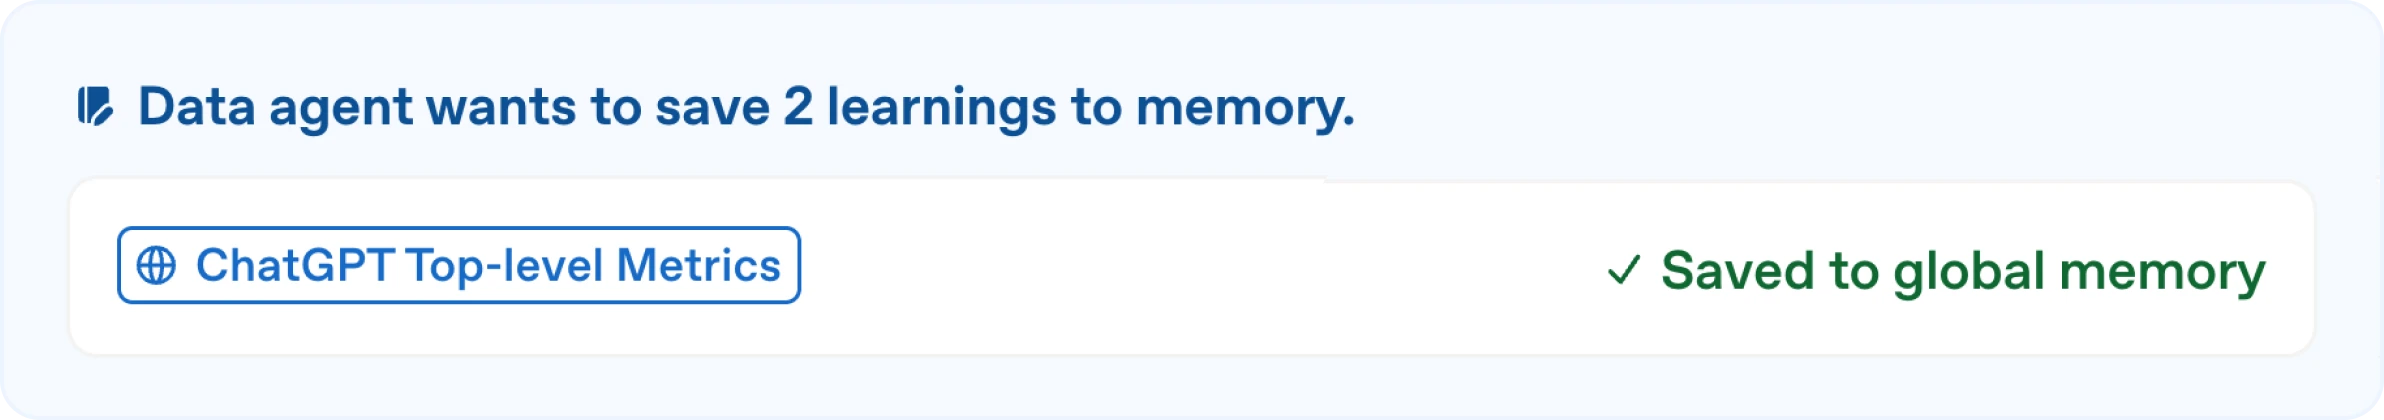
Пользователь подтверждает сохранение полезного исправления для следующих запросов.
Источник: Оригинальная иллюстрация OpenAIСлой 6: проверять текущее состояние систем
Заранее подготовленный контекст может отсутствовать или устареть. В таком случае агент способен обратиться непосредственно к хранилищу данных: посмотреть актуальную схему, исследовать содержимое таблицы и выполнить живой запрос. Это позволяет отличать долговременные знания о наборе данных от его текущего состояния.
При необходимости агент взаимодействует и с другими компонентами Data Platform, в статье названы сервис метаданных, Airflow и Spark. Шестой слой поэтому играет роль проверки реальности: если сохранённого описания недостаточно, модель может получить дополнительные сведения из работающей системы, а не строить ответ только по старому индексу.
Уровень №6: Контекст выполненияЧто готовят заранее и что ищут во время запроса
Чтобы не перебирать десятки тысяч наборов данных во время каждого вопроса, OpenAI разделяет подготовку знаний и работу агента. Раз в день офлайн-конвейер агрегирует три прямо перечисленных источника: использование таблиц, человеческие аннотации и обогащение, полученное Codex из кода. Их приводят к единому нормализованному представлению.
Подготовленный контекст преобразуется в эмбеддинги через OpenAI Embeddings API и сохраняется для последующего поиска. Когда приходит запрос, агент через RAG получает только наиболее релевантные фрагменты вместо полного сканирования сырых метаданных и логов. Авторы связывают это с предсказуемой и низкой задержкой поиска контекста, но численных значений latency в статье нет.
Живые запросы к хранилищу остаются отдельным механизмом и выполняются по необходимости. Ежедневный конвейер, который авторы описывают явно, объединяет использование таблиц, аннотации экспертов и сведения из кода. Корпоративные документы тоже индексируются с учётом прав доступа, но статья не говорит, что они обновляются именно этим же конвейером.
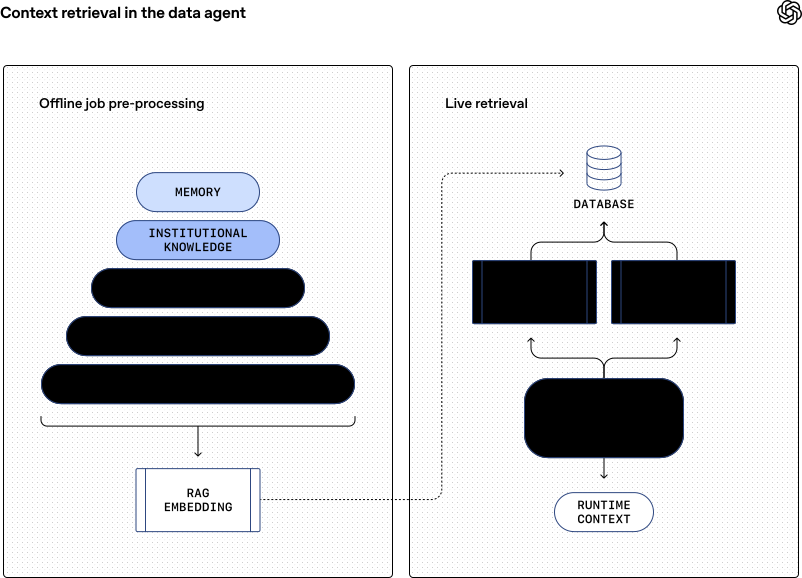
Часть знаний готовится заранее; в момент вопроса агент извлекает подходящий контекст и при необходимости обращается к данным.
Источник: Оригинальная иллюстрация OpenAIДиалог вместо одноразовой генерации
Многие аналитические вопросы нельзя точно сформулировать с первого сообщения. Поэтому агент сохраняет полный контекст разговора между ходами: пользователь может задать уточняющий вопрос, изменить разрез анализа или остановить неудачное направление без повторного описания всей задачи.
Если существенной информации не хватает, агент может попросить уточнение. Если ответа нет, он способен использовать разумное предположение, чтобы продолжить работу. В статье приведён конкретный пример: для запроса о росте бизнеса без указанного периода агент может предположить последние семь или 30 дней. Такое допущение должно оставаться видимым пользователю, потому что изменение временного окна меняет смысл результата.
После запуска OpenAI заметила повторяющиеся сценарии и добавила workflows — повторно используемые наборы инструкций для типовых анализов. Среди примеров названы еженедельные бизнес-отчёты и проверки таблиц. Их задача — один раз зафиксировать полезный контекст и практику выполнения, а затем получать более последовательный результат при повторении той же работы.
Built to think and work like a teammateПрактический урок: качество агента нужно проверять непрерывно
До формального списка Lessons learned статья даёт ещё один важный практический вывод: постоянно меняющийся агент способен не только улучшаться, но и незаметно регрессировать. Поэтому новые возможности нельзя оценивать только по нескольким удачным диалогам — нужна повторяемая автоматическая проверка.
Evals строятся на подготовленных парах «вопрос — ожидаемое решение». Для каждого важного аналитического шаблона человек пишет golden SQL, который формирует эталонный результат. Затем естественный вопрос отправляют в endpoint генерации запросов агента, выполняют полученный SQL и сравнивают его результат с результатом эталонного запроса.
Сравнение не сводится к совпадению текста SQL. Два запроса могут быть записаны по-разному и вернуть одинаково корректный ответ; результат также может содержать дополнительные столбцы, которые не меняют смысл. Поэтому учитываются и SQL, и полученные данные, а эти сигналы поступают в Evals grader, который выдаёт итоговую оценку и объяснение. Статья не раскрывает размер набора evals, долю успешных примеров или конкретный проходной score.
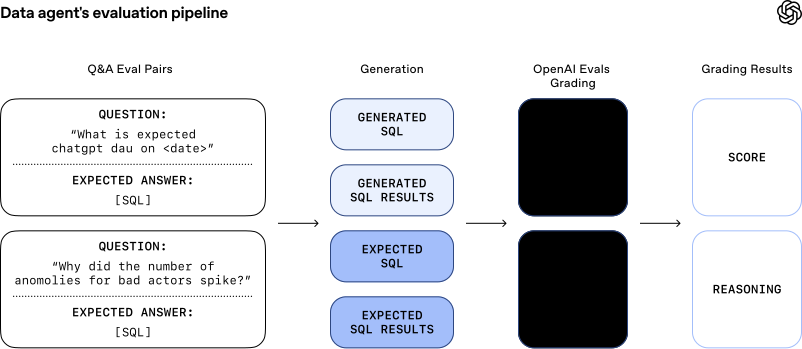
Оценка сравнивает сгенерированный SQL и данные с эталонным результатом, допуская корректные варианты записи.
Источник: Оригинальная иллюстрация OpenAIПрава агента не должны быть шире прав пользователя
Агент подключён к существующей модели безопасности и контроля доступа OpenAI и действует как интерфейс поверх неё. В статье используется принцип pass-through: если пользователь не имеет права читать таблицу напрямую, обращение к ней через естественный язык не должно создавать новое разрешение.
Если доступ отсутствует, агент сообщает о проблеме либо ищет альтернативный набор данных, который этому пользователю разрешён. Аналогичный принцип применяется к извлечению институциональных знаний: документы сохраняются с метаданными разрешений, а сервис поиска контролирует доступ во время выполнения.
Безопасность здесь связана и с проверяемостью. Авторы прямо признают, что система может ошибаться, поэтому она показывает существенные предположения и шаги выполнения, а для выполненных запросов даёт переход к исходным результатам. При этом статья не описывает полный threat model, защиту от prompt injection, устройство sandbox или конкретную реализацию row-level и column-level ограничений.
Agent securityУрок: меньше инструментов может дать более надёжное поведение
В ранней версии команда открыла агенту полный набор доступных инструментов. Для человека несколько похожих способов выполнить действие могут быть удобны, но для модели перекрывающиеся возможности создавали лишнюю неоднозначность: нужно было сначала решить, какой из похожих вызовов выбрать.
OpenAI сократила и объединила часть tool calls, чтобы уменьшить пространство неопределённых решений. Практический вывод статьи состоит не в том, что агенту всегда нужно мало инструментов, а в том, что каждая дублирующая возможность должна оправдывать усложнение выбора. Численного сравнения качества до и после консолидации авторы не приводят.
Lesson #1: Less is MoreУрок: задавать цель, а не жёстко прописывать маршрут
Команда пробовала детально предписывать агенту, как именно выполнять аналитические задачи, но обнаружила, что чрезмерно жёсткие инструкции ухудшают результат. Два вопроса могут иметь похожую форму и при этом требовать разных таблиц, проверок и последовательности действий.
Поэтому инструкции подняли на уровень цели и общих ограничений, а выбор конкретного пути оставили рассуждению модели. Авторы описывают такой вариант как более устойчивый и дающий лучшие результаты, но не публикуют отдельный benchmark prompting-стратегий. Значит, из статьи можно взять направление проектирования, но нельзя приписывать ему измеримый универсальный выигрыш.
Lesson #2: Guide the Goal, Not the PathУрок: форма таблицы видна в схеме, а смысл часто спрятан в коде
Третий урок возвращает к обогащению контекста из кода. Схема показывает колонки и типы, история запросов — привычные способы использования, но код конвейера фиксирует предположения, правила свежести данных и бизнес-логику, которые могут вообще не появляться в SQL.
Поэтому Codex обходит кодовую базу и извлекает контекст о том, как наборы данных действительно строятся. Это помогает отвечать не только на вопрос «какие здесь поля», но и на более важные вопросы «что на самом деле попало в эту таблицу» и «когда её корректно использовать». В архитектуре OpenAI код не заменяет остальные знания, а заполняет один из наиболее опасных пробелов между технической схемой и фактической семантикой.
Lesson #3: Meaning Lives in CodeИтог: как вопрос превращается в проверяемый анализ
Исходная проблема OpenAI — не просто научить модель писать SQL. В большой платформе сначала нужно найти подходящий набор данных, понять его смысл и происхождение, вспомнить внутренние договорённости, применить правильные фильтры и заметить ошибочный промежуточный результат. Поэтому вокруг GPT-5.2 построили систему из шести слоёв контекста. Часть сведений о таблицах заранее нормализуется, превращается в эмбеддинги и доступна через RAG; документы хранятся с правами доступа; исправления можно сохранять в память; свежие сведения агент при необходимости получает непосредственно из хранилища, Airflow, Spark и других систем.
- 01
Понять вопрос
Агент разбирает цель, сохраняет контекст диалога и при существенной неоднозначности уточняет условия или явно использует разумное допущение.
- 02
Найти нужный контекст
Система извлекает релевантные сведения о таблицах, коде, документации и сохранённых правилах, не просматривая весь корпус на каждый запрос.
- 03
Проверить источники
Если предварительной информации мало или она могла устареть, агент обращается к живым системам и исследует актуальную схему или данные.
- 04
Выполнить анализ
Агент строит и запускает SQL, оценивает промежуточный результат и меняет соединение, фильтр или следующий шаг, если результат явно противоречит ожиданиям.
- 05
Вернуть проверяемый ответ
Пользователь получает вывод вместе с существенными предположениями, описанием выполненных шагов и доступом к результатам запросов, которые можно проверить вручную.
Авторы говорят, что такой агент в рабочих сценариях сокращает путь от вопроса до инсайта с дней до минут, но статья не даёт benchmark, accuracy, A/B-теста или числа пользователей самого агента. Evals проверяют SQL и фактически возвращённые данные, однако численные результаты этих evals не опубликованы. Система также не считается законченной: OpenAI продолжает улучшать работу с неоднозначными вопросами, валидацию, надёжность и интеграцию в существующие процессы. Поэтому главный результат статьи — не доказательство полностью автономного аналитика, а инженерный шаблон: качественный data agent требует контекста, ограниченных инструментов, проверки вычислений, наследования прав пользователя и постоянных evals.
Same vision, new tools