Разбор готов
Grab: как команда построила собственную Vision LLM для OCR и извлечения данных из документов
Для электронного подтверждения личности, eKYC, сервису нужно получать структурированные данные из фотографий удостоверений личности, водительских прав и регистрационных документов. В Юго-Восточной Азии эта задача усложняется разнообразием языков и форматов документов: обычные OCR-системы хуже справлялись с множеством шаблонов, внешние крупные модели, по наблюдениям Grab, давали ошибки, галлюцинации и высокую задержку, а открытых Vision LLM не хватало по качеству. Команда начала с Qwen2-VL 2B, подготовила синтетические OCR-данные и размеченные реальные документы, попробовала LoRA, затем перешла к полному дообучению. После этого Grab собрала собственную модель примерно на 1 млрд параметров из визуального энкодера Qwen2-VL 2B и компактного языкового декодера Qwen2.5 0.5B. Разбор проходит весь этот путь: от постановки OCR и KIE до четырёх этапов обучения новой архитектуры, сравнений качества и нормированной задержки и границ того, что публикация действительно позволяет утверждать о внедрении.
Материал полезен инженерам машинного обучения и компьютерного зрения, которые работают с документами, мультимодальными моделями и специализированным дообучением, а также тем, кто хочет понять, почему знания языка в текстовой части модели ещё не гарантируют хорошее чтение этого языка на изображениях и как качество модели приходится согласовывать с ресурсами и задержкой.
Статья · на английском
How we built a custom vision LLM to improve document processing at GrabJia Chen, Manish Sahu, Sing Kwan Ng, Yang Yang · Опубликовано: 4 ноября 2025 г.
Задача: из фотографии документа получить структурированные данные
В процессе eKYC, электронного подтверждения личности клиента, система получает фотографии удостоверений личности, водительских прав, регистрационных свидетельств и других документов. Первый уровень задачи — OCR, Optical Character Recognition: найти текст на изображении и распознать его. Но конечному сервису обычно нужен не просто поток символов. KIE, Key Information Extraction, должна выделить конкретные сущности — например имя, номер документа или дату — и вернуть их в структурированном виде.
Для Grab эта задача особенно сложна из-за разнообразия языков и шаблонов документов в Юго-Восточной Азии. Авторы пишут, что традиционные OCR-системы плохо переносили такое разнообразие. Проприетарные большие модели рассматривались как альтернатива, но команда отмечала недостаточное понимание языков региона, ошибки, галлюцинации и высокую задержку. Открытые Vision LLM были экономичнее, однако исходного качества для задач Grab не хватало. Поэтому команда решила не ограничиваться готовой моделью, а последовательно адаптировать её под свои документы.
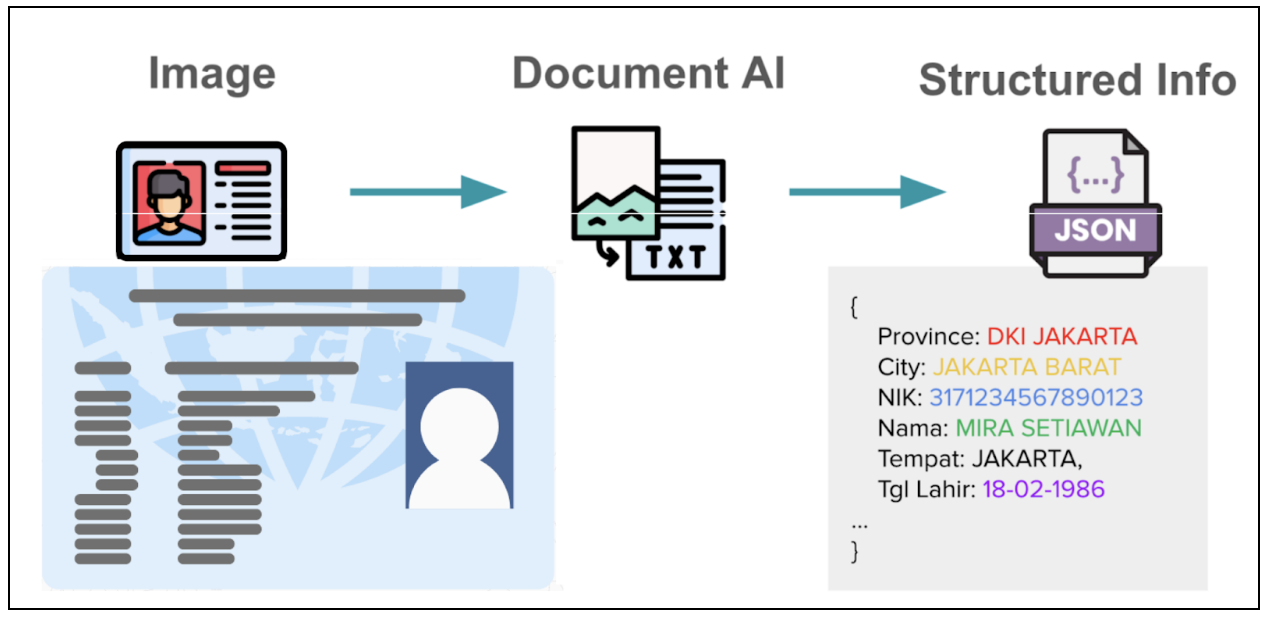
Задача Grab: из снимка документа получить структурированные поля для проверки пользователя.
Источник: Иллюстрация из инженерного блога GrabИз чего состоит Vision LLM
Vision LLM — мультимодальная модель, которая принимает не только текст, но и изображение. В упрощённой архитектуре Grab выделяет три части. Image encoder, или визуальный энкодер, превращает изображение в числовые представления. Vision-language projector преобразует эти представления в форму, с которой может работать языковая часть. Language model, или языковая модель, получает визуальную информацию вместе с текстовым запросом и генерирует ответ.
Такое разделение важно для всей дальнейшей истории. Если языковой декодер уже умеет работать с текстом на нужном языке, это ещё не означает, что визуальная часть научилась распознавать написание этих символов на фотографиях документов. Именно поэтому Grab позже отдельно обучает визуальные компоненты на синтетическом OCR и только затем дообучает всю модель под конечную задачу.
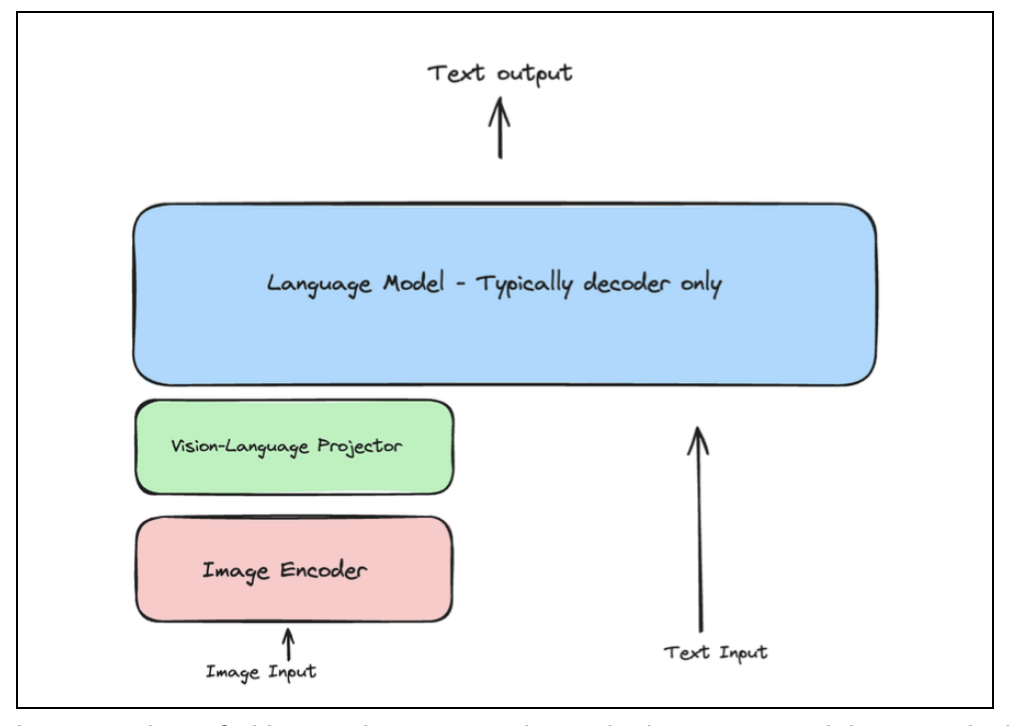
Изображение сначала кодируется, затем проектор передаёт его представление языковой модели.
Источник: Иллюстрация из инженерного блога GrabПочему базовой моделью стала Qwen2-VL 2B
Команда рассматривала Qwen2VL, miniCPM, Llama3.2 Vision, Pixtral 12B, GOT-OCR2.0 и NVLM 1.0. В качестве основы выбрали Qwen2-VL 2B. Первый аргумент — размер: модель достаточно мала, чтобы полностью дообучать её на GPU с ограниченным объёмом видеопамяти. Второй — поддержка языков региона: авторы отмечают эффективную токенизацию Thai и Vietnamese, что указывает на наличие подходящей лексики в текстовой части модели.
Третий аргумент — dynamic resolution, возможность обрабатывать изображения разных разрешений вместо обязательного приведения каждого документа к одному фиксированному размеру. Для OCR это важно: сильное масштабирование или обрезка способны исказить мелкие символы. При этом публикация отдельно сообщает о первоначальном сравнении Qwen2VL и miniCPM на данных Grab и низкой точности исходных моделей. Из текста нельзя делать вывод, что все перечисленные семейства прошли один и тот же численный benchmark.
Choosing our base Vision LLM modelКак дали модели больше визуального текста на языках региона
Для обучения требовались изображения с текстом на целевых языках. Grab извлекла текстовые фрагменты из Common Crawl и использовала собственный генератор синтетических данных. Текст отрисовывался разными шрифтами, на разных фонах и с аугментациями, то есть искусственными преобразованиями изображения, которые увеличивают разнообразие обучающих примеров.
В синтетическом наборе присутствовали Bahasa Indonesia, Thai, Vietnamese и English. На каждом изображении размещался абзац из случайных предложений, взятых из подготовленного корпуса. Такой датасет нужен не для изучения фактов из Common Crawl, а для визуального обучения: модель получает много примеров того, как символы и слова целевых языков выглядят на изображениях.
Training dataset generation → Synthetic OCR datasetDocumint: как готовили реальные документы и разметку
Одного синтетического текста недостаточно: конечная задача связана с реальными документами, их ориентацией, расположением полей и структурой. Эксперименты Grab показали, что предварительное обнаружение документа и исправление его ориентации заметно помогают OCR и извлечению информации. Для подготовки таких данных команда использовала внутреннюю платформу Documint.
- 01
Detection
Модуль находит область документа внутри полной фотографии.
- 02
Orientation
Модуль определяет, как документ нужно повернуть, например на 180 градусов, если он снят вверх ногами.
- 03
OCR
Система распознаёт текст и возвращает его в неструктурированном виде.
- 04
KIE
Из распознанного текста извлекаются нужные поля и формируется структурированный JSON.
Через этот конвейер команда прогоняла большое количество карточек и документов, собранных Grab, чтобы получить обучающие метки. После автоматической обработки данные дополнительно проверял человек. Это важная часть метода: публикация не описывает полностью автоматическую разметку без контроля качества.
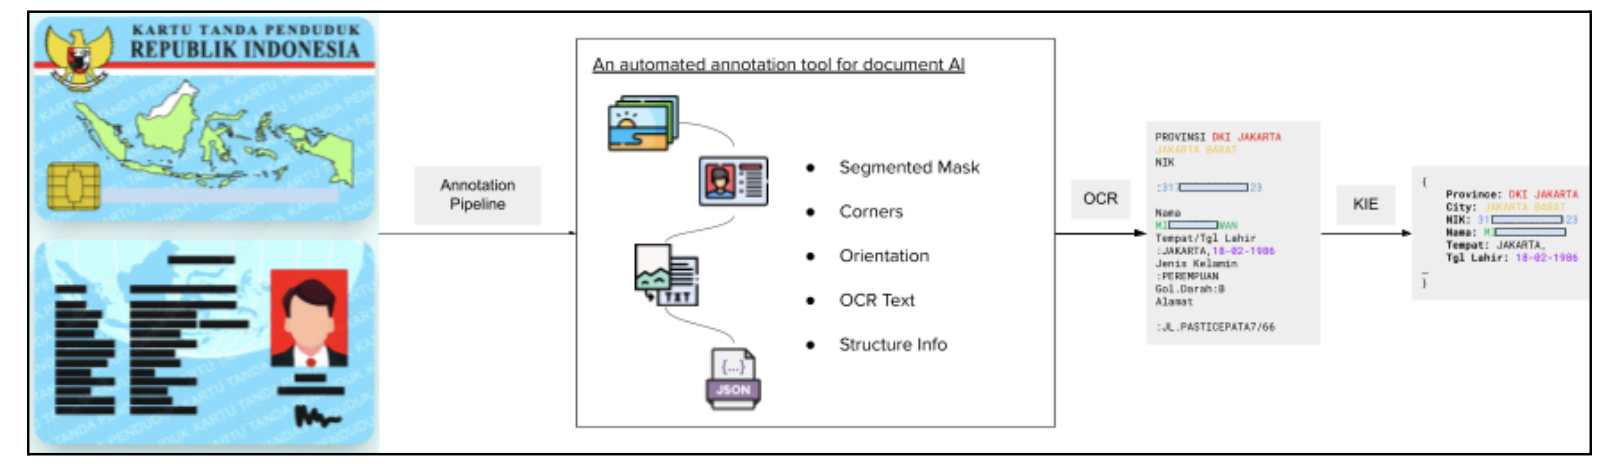
Documint последовательно находит документ, исправляет ориентацию, распознаёт текст и извлекает поля; разметку проверяет человек.
Источник: Иллюстрация из инженерного блога GrabПервая попытка: лёгкое дообучение через LoRA
Первым способом адаптации Qwen2VL стала LoRA, Low-Rank Adaptation. Вместо обновления всех исходных весов модели LoRA обучает небольшие дополнительные низкоранговые компоненты. Это уменьшает требования к вычислениям и памяти по сравнению с полным дообучением.
Grab обучала LoRA на подготовленных документах разных шаблонов и языков. Авторы называют результат многообещающим для документов с Latin scripts и сообщают о высокой field-level accuracy на Indonesian documents. Field-level accuracy здесь означает точность извлечения отдельных полей документа, но подробную формулу метрики публикация не приводит.
Ограничения проявились на документах Thai и Vietnamese, а также на неструктурированных макетах с мелким и плотным текстом. Именно эти случаи подтолкнули команду к более глубокому изменению параметров модели.
Experimentation → Phase 1: The LoRA experimentПочему команда перешла от LoRA к полному дообучению
Авторы формулируют ключевую гипотезу: открытая Vision LLM может получить хорошее покрытие разных языков при предварительном обучении текстового декодера, но при этом визуальный энкодер и совместное vision-language обучение могут видеть слишком мало изображений текста на языках Юго-Восточной Азии. Тогда модель знает язык как последовательность токенов, но хуже связывает его символы с визуальным входом.
Поэтому команда решила обновлять не только небольшие LoRA-компоненты, а полноценные части Vision LLM. Это вывод из конкретных экспериментов Grab, а не универсальное утверждение, что LoRA всегда хуже полного дообучения.
Phase 2: The power of full fine-tuning, абзац о multilingual corpus и visual textДва этапа полного обучения Qwen2-VL 2B
Grab использовала двухэтапную схему, опираясь на подход LLAVA. Сначала модель должна лучше научиться видеть текст нужных языков, а уже после этого — решать конкретные задачи на документах.
- 01
Continual pre-training
Визуальные компоненты обучаются на синтетическом OCR для Bahasa Indonesia, Thai, Vietnamese и English. Цель — выучить визуальные особенности символов и текста этих языков.
- 02
Full-parameter fine-tuning
После этого дообучается вся модель: vision encoder, projector и language model. Для этого используются подготовленные данные конкретных документов и задач Grab.
Смысл разделения этапов состоит не просто в большем числе обновляемых параметров. Первый этап адресно усиливает визуальное распознавание нужных языков, второй согласует все части модели уже под OCR и KIE документов.
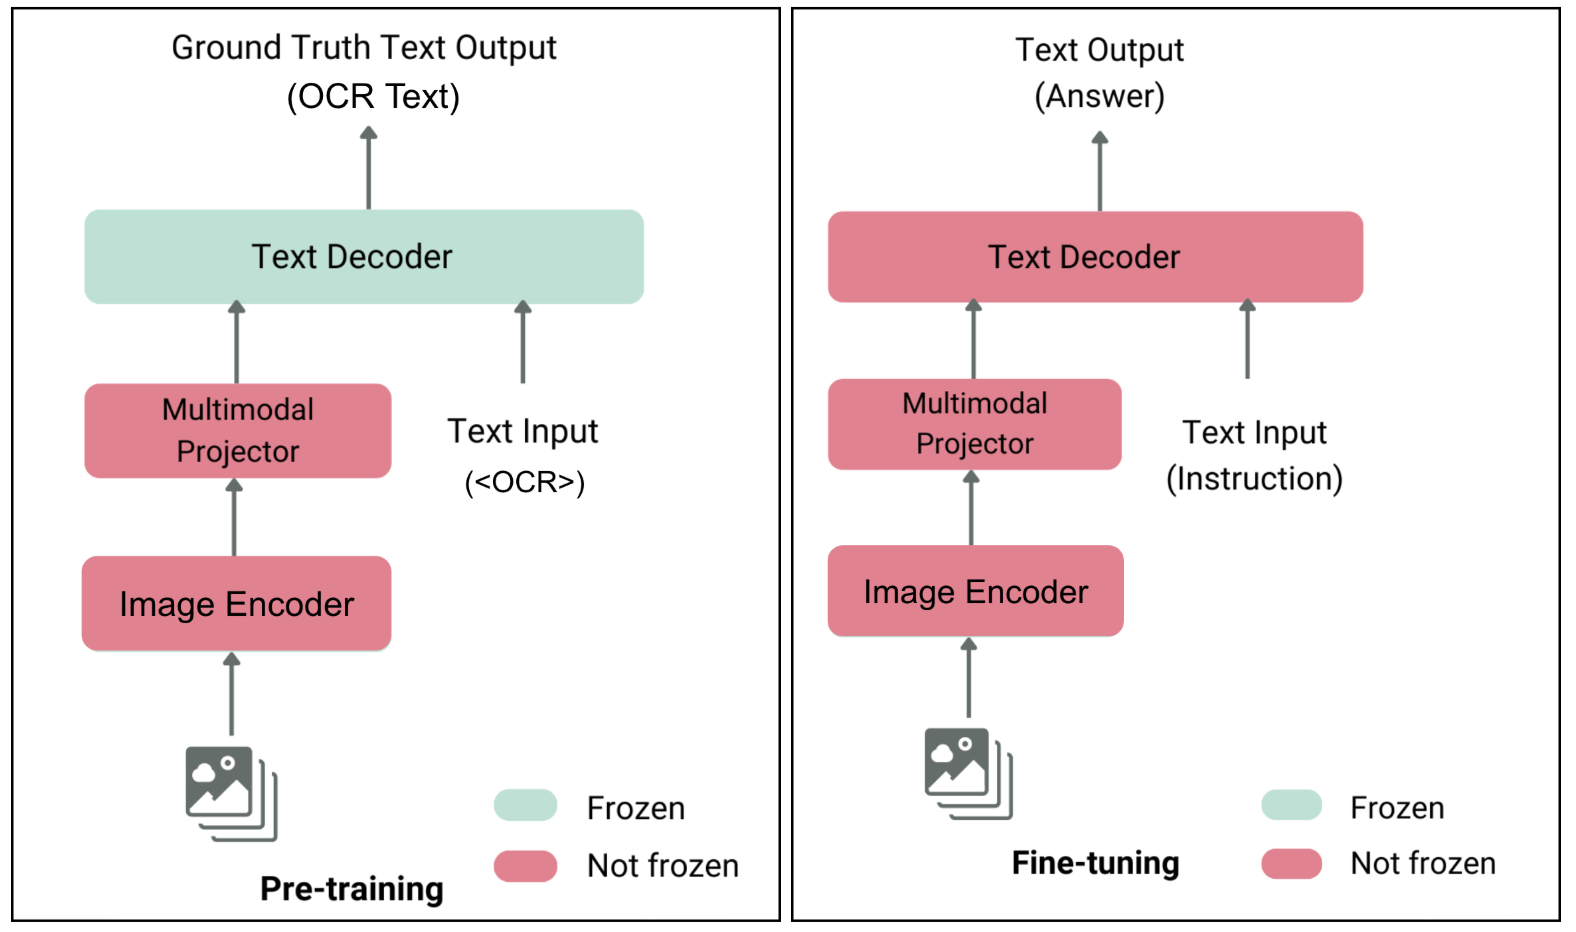
Сначала обучаются зрительные компоненты на синтетическом OCR, затем все параметры модели на данных документов.
Источник: Иллюстрация из инженерного блога GrabЧто изменилось после полного дообучения
В исходной таблице Grab не публикует абсолютную точность baseline. Все числа показывают изменение field-level accuracy относительно него в процентных пунктах, pp. Поэтому +70 pp нельзя превращать в «70% точности»: если исходное абсолютное значение неизвестно, конечное значение восстановить невозможно.
Таблицу можно прокрутить по горизонтали.
Полное дообучение лучше LoRA во всех четырёх строках таблицы. Наибольшие опубликованные приросты к baseline относятся к Thailand document 1 и Vietnam document 1: +70 pp и +40 pp соответственно. Отдельно видно, что LoRA на Philippines document 1 находится на 2 процентных пункта ниже baseline, тогда как Full FT — на 6 пунктов выше. Публикация не раскрывает состав baseline, абсолютные значения accuracy, размер тестовой выборки и способ агрегирования полей.
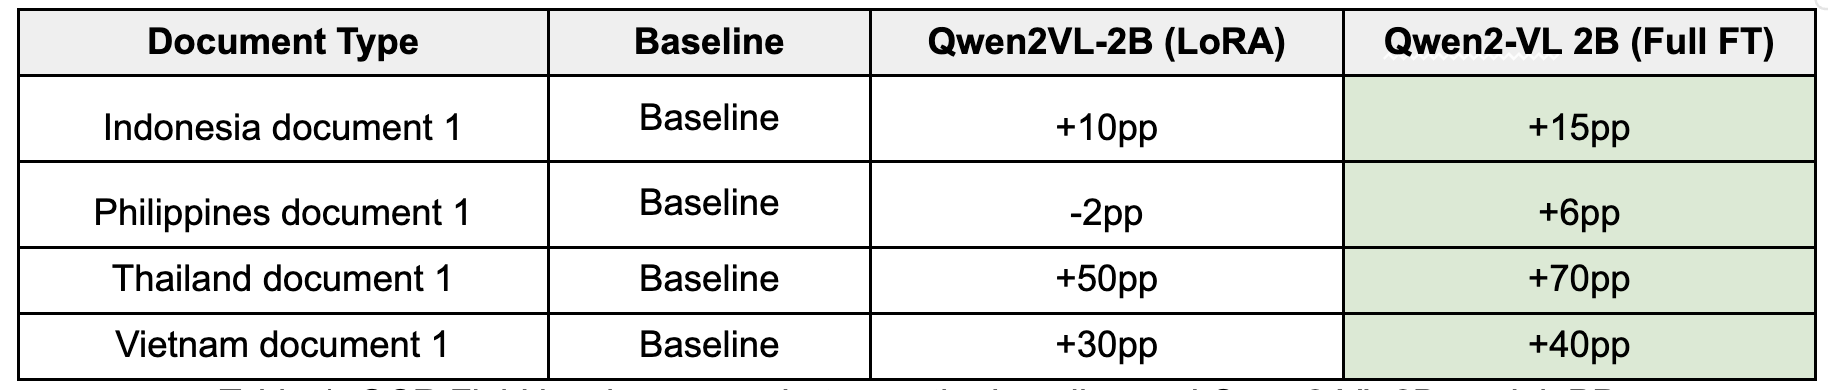
Изменения точности к baseline показаны в процентных пунктах по четырём типам документов; абсолютные значения baseline не опубликованы.
Источник: Иллюстрация из инженерного блога GrabЗачем после успешной 2B модели понадобилась собственная ~1B
Полное дообучение Qwen2-VL 2B улучшило качество, но, по словам авторов, приблизило использование GPU к пределам доступных ресурсов. Поэтому следующая цель была уже не только в точности: команда хотела уменьшить вычислительную стоимость обучения и применения модели.
Новая Vision LLM имеет примерно 1 млрд параметров и собрана из готовых сильных частей. Визуальный энкодер взят из Qwen2-VL 2B. Языковой декодер — из более компактной Qwen2.5 0.5B. Между ними используется скорректированный projector, который должен согласовать представления двух компонентов.
Поэтому выражение авторов «from scratch» здесь не следует понимать как случайную инициализацию всей миллиардной модели и её предварительное обучение с нуля. Публикация прямо описывает переиспользование энкодера и декодера из существующих Qwen-моделей.
Phase 3: Building a lightweight 1B model from scratchЧетыре этапа обучения собственной модели
- 01
1. Projector alignment
Сначала обучается новый projector, чтобы визуальный энкодер и компактный языковой декодер могли обмениваться совместимыми представлениями.
- 02
2. Vision tower enhancement
Визуальную часть дополнительно обучают на большом наборе публичных мультимодальных данных: visual question answering, общем OCR и описании изображений.
- 03
3. Language-specific visual training
Затем модель получает два типа синтетических OCR-данных для усиления распознавания целевых языков. Без этого этапа авторы наблюдали падение performance на некоторых документах до 10%.
- 04
4. Task-centric fine-tuning
В конце вся примерно миллиардная модель полностью дообучается на подготовленном наборе реальных документов под задачи Grab.
Для значения «до 10%» источник не указывает конкретную метрику и не использует обозначение процентных пунктов. Поэтому его нельзя переписывать как «-10 pp accuracy». Также публикация не называет конкретные публичные наборы данных второго этапа и не раскрывает, что именно представляют собой два типа synthetic OCR data третьего этапа.
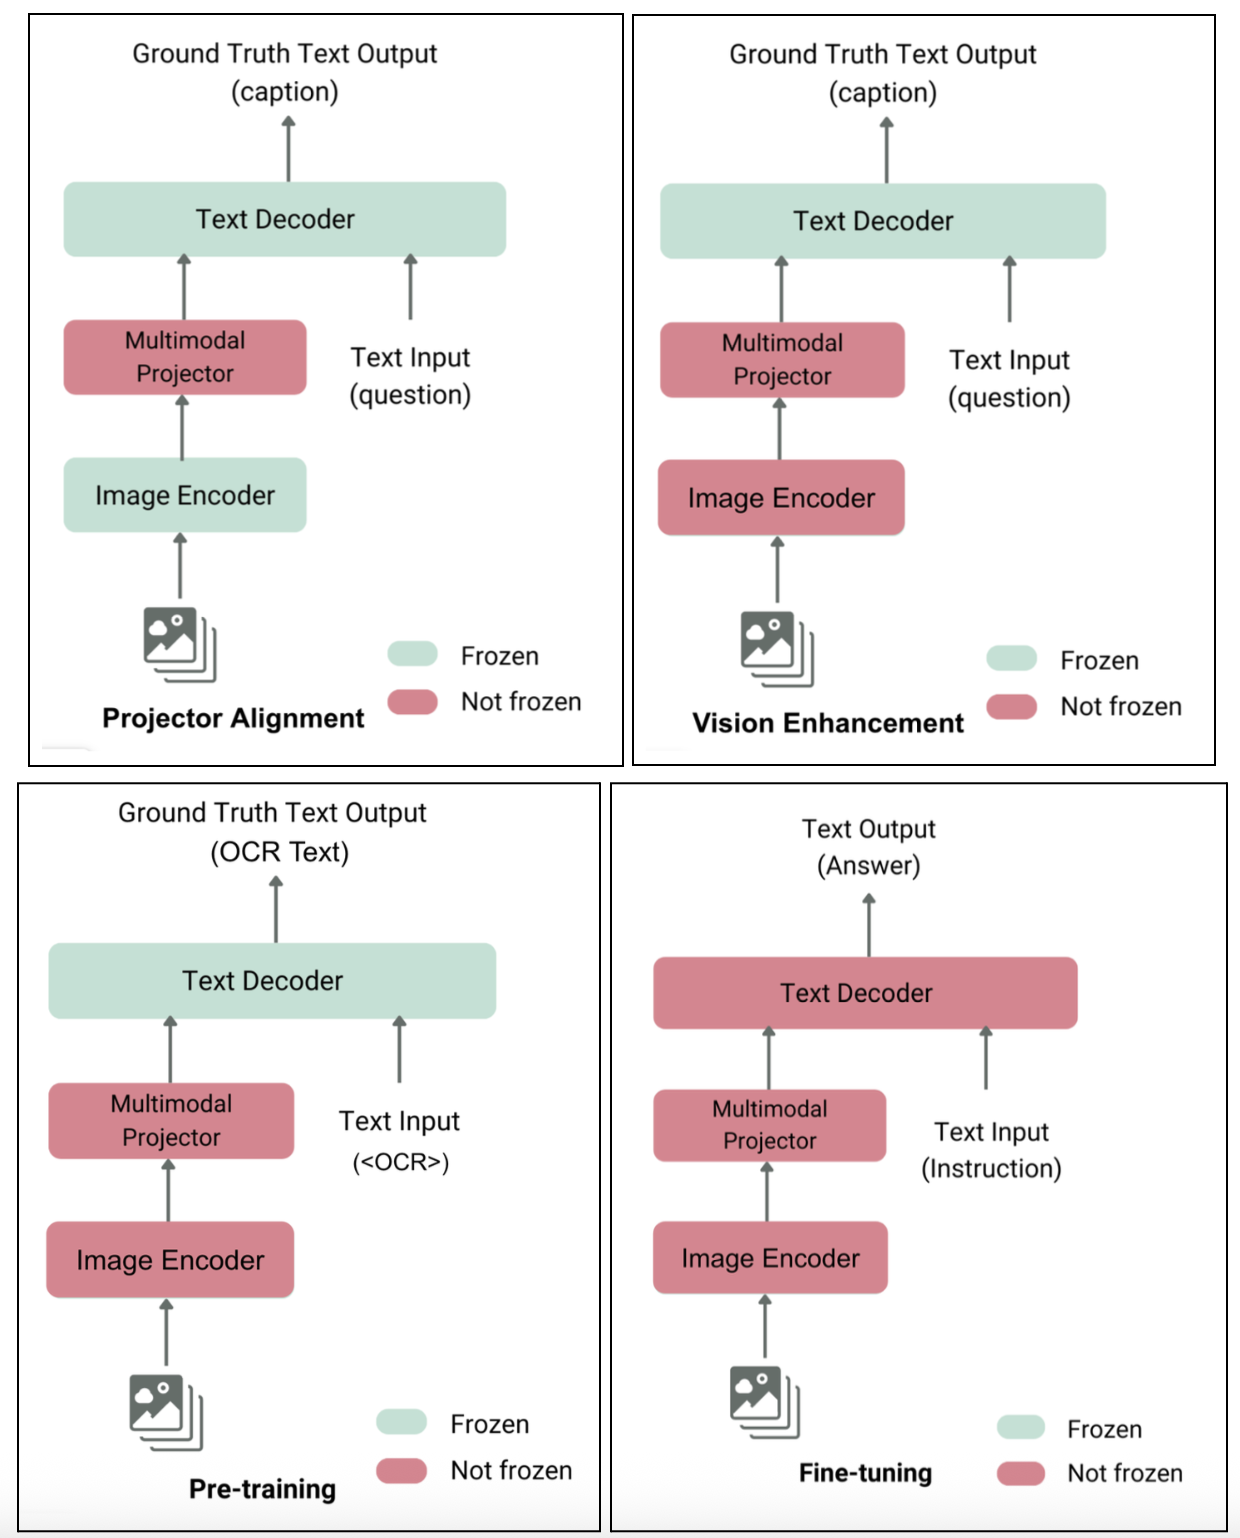
Grab последовательно согласует проектор, развивает зрительный кодировщик и дообучает модель на задачах OCR и извлечения полей.
Источник: Иллюстрация из инженерного блога GrabКомпромисс: почти качество 2B при меньшей задержке
По словам Grab, итоговая ~1B модель на большинстве типов документов остаётся в пределах 3 процентных пунктов по accuracy от более крупной 2B. Формулировка важна: источник не говорит, что разница всегда равна 3 pp или что 1B всегда хуже ровно на эту величину.
Для задержки авторы публикуют P50, P90 и P99. P50 — медианная задержка: половина измерений быстрее этого значения. P90 и P99 характеризуют хвост распределения: соответственно 90% и 99% измерений не превышают указанного уровня. Но шкала в таблице нормирована к 100 единицам и не привязана к миллисекундам или секундам.
Таблицу можно прокрутить по горизонтали.
В этой нормированной шкале 1B снижает P50 с 75 до 39, P90 с 96 до 42 и P99 со 100 до 44. Авторы отдельно отмечают проблему внешних API: их P99, по наблюдениям команды, может быть в 3–4 раза выше P50, что Grab считает неприемлемым для масштабных запусков. Публикация не сообщает оборудование, batch size, физические единицы времени или параметры serving, поэтому из таблицы нельзя получать миллисекунды, QPS или стоимость GPU.
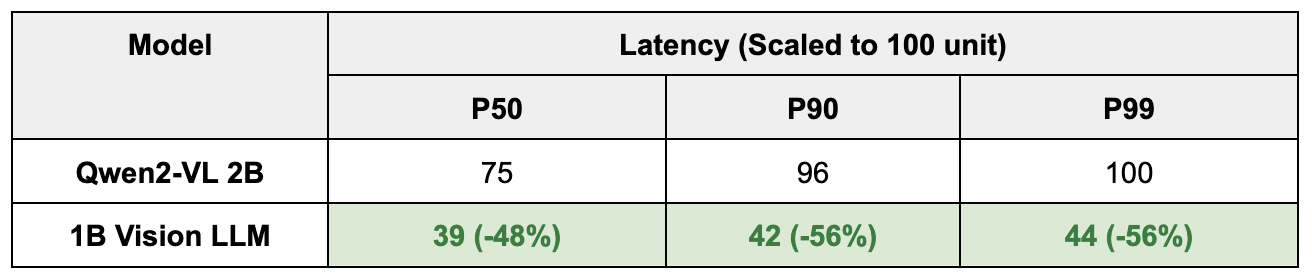
В исходной таблице задержка нормирована к условной шкале 100; показаны P50, P90 и P99, а не миллисекунды.
Источник: Иллюстрация из инженерного блога GrabКак авторы сравнивают три класса решений
В конце Grab сравнивает собственную 1B Vision LLM, традиционные OCR-алгоритмы и внешние API. Это качественная итоговая таблица, а не единый количественный benchmark: звёзды, значки усилий и ракеты обозначают оценку авторов, но не имеют общей числовой шкалы.
Таблицу можно прокрутить по горизонтали.
Из этой таблицы нельзя делать вывод, что собственная модель в полтора раза точнее традиционного OCR или втрое быстрее внешнего API. Публикация не задаёт численное соответствие между количеством символов и измеряемой величиной.
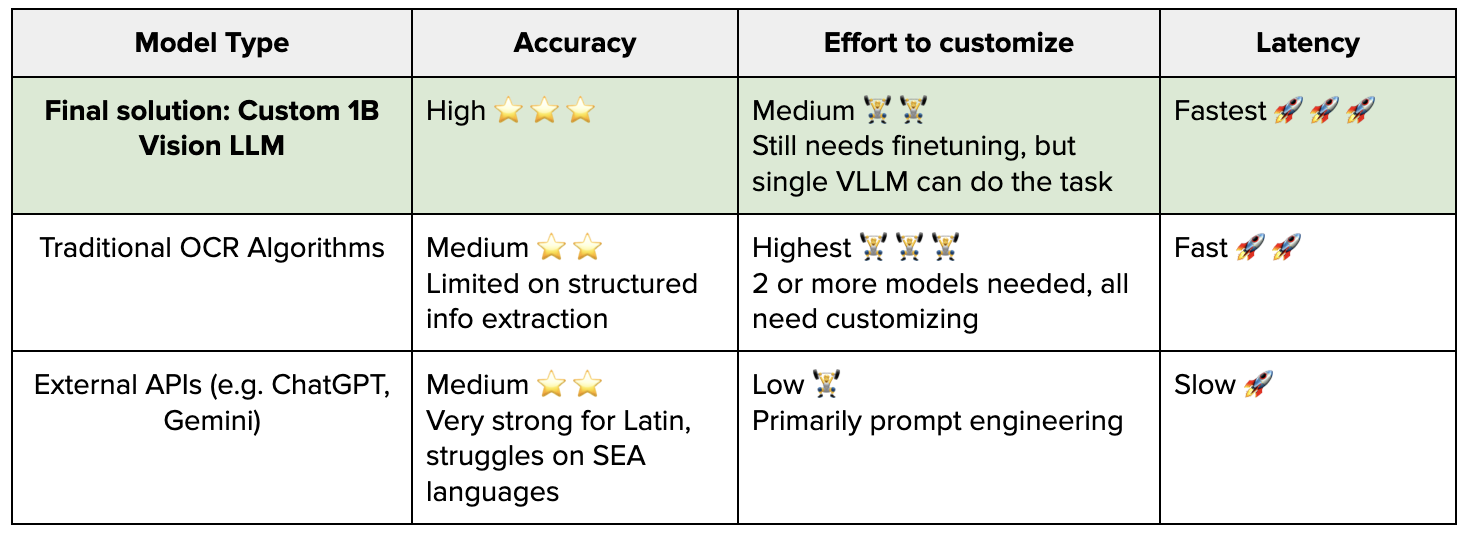
Итоговая таблица авторов сравнивает качество, трудоёмкость настройки и задержку качественными категориями.
Источник: Иллюстрация из инженерного блога GrabЧто результаты действительно показывают
Наиболее сильный подтверждённый вывод работы связан с сочетанием данных и способа обучения. На задачах Grab лёгкой адаптации LoRA оказалось недостаточно для части документов, тогда как полное дообучение Qwen2-VL 2B дало более высокий результат во всех строках опубликованной таблицы. Затем специализированная ~1B архитектура сохранила близкое к 2B качество на большинстве типов документов и заметно улучшила нормированную задержку.
Из этого не следует универсальное правило «маленькие модели лучше больших» или «full fine-tuning всегда лучше LoRA». Эксперимент показывает результат для определённой области: OCR и KIE документов Grab, языков Юго-Восточной Азии, конкретных данных и архитектур.
Авторы также подчёркивают роль качественной подготовки данных, поддержки целевых языков в базовой модели и работы с изображениями в исходном разрешении. Но точные вклады каждого фактора отдельным ablation-исследованием в публикации не разложены.
Key takeaways и итоговые утверждения после Table 2Что известно и чего не известно о внедрении
Grab называет ~1B модель финальным решением в сравнительной таблице и пишет, что архитектура оптимизирована для training and deployment. Это позволяет говорить, что команда построила и инженерно сравнила специализированную модель, предназначенную для применения в системе.
Однако источник не сообщает, что вся система eKYC Grab или весь поток документов уже переведены на эту модель. В публикации нет доли production-трафика, числа реальных запросов, даты полного rollout, A/B-теста, SLA, SLO или разбивки по рынкам. Поэтому утверждения «модель внедрена на весь трафик», «полностью заменила прежний OCR в production» или «обслуживает все рынки Grab» выходили бы за пределы первоисточника.
То же относится к архитектуре окружающей системы. Авторы делают общий вывод о возможности заменить традиционные OCR-конвейеры единой специализированной Vision LLM, но публикация не показывает полный runtime-контур, поэтому нельзя утверждать, что detection, orientation correction и все остальные вспомогательные компоненты физически исчезли из рабочей системы.
Phase 3, Key takeaways и What’s next; отсутствие описания полного rollout или A/B-тестаКаких деталей публикация не раскрывает
В Table 1 не раскрыты абсолютная accuracy baseline, конкретная модель baseline, размер тестовой выборки, список полей и способ агрегирования field-level accuracy. Для итоговой ~1B модели нет полной таблицы accuracy по тем же документам: приведена только формулировка о разрыве не более 3 pp на большинстве типов документов.
Для обучения не указаны размеры synthetic и real datasets, число эпох, learning rate, используемые GPU, точный объём памяти и конкретные публичные датасеты Stage 2. Для LoRA не приведены rank, target modules и другие параметры адаптации. Для новой архитектуры не раскрыты точное число параметров, устройство projector и размеры скрытых представлений.
В latency-бенчмарке отсутствуют миллисекунды или секунды, характеристики оборудования, разрешение документов, batch size и длина генерируемого ответа. Эти пробелы не делают результаты бесполезными, но ограничивают переносимость чисел на другую систему.
Ограничения информации вокруг Table 1, Table 2 и описания обученияЧто Grab оставляет на будущее
В разделе What’s next команда пишет о разработке OCR- и KIE-моделей с Chain of Thought, то есть подходом, где модель должна использовать более развёрнутое промежуточное рассуждение для повышения способности обобщать на разнообразные документы. В первоисточнике это направление находится именно в планах и не представлено как уже достигнутый production-результат.
Вторая линия развития — расширение поддержки по Юго-Восточной Азии, включая Myanmar, Cambodia и другие рынки. Формулировка также описывает продолжающуюся работу. Поэтому наличие этих стран в планах нельзя превращать в утверждение, что опубликованная модель уже прошла на них ту же оценку качества.
What’s next?Итог: от изображения документа до структурированных полей
История Grab показывает последовательный переход от готовых средств распознавания к специализированной мультимодальной модели. Исходная проблема возникла в eKYC: документы отличаются языком, шаблоном, ориентацией и плотностью текста, а системе нужны не только символы, но и структурированные поля. В качестве основы команда выбрала Qwen2-VL 2B, подготовила синтетический визуальный текст и реальные документы через Documint, затем сравнила LoRA с более глубоким обучением. Полное дообучение оказалось сильнее во всех четырёх опубликованных строках: до +70 процентных пунктов относительно исходного варианта, абсолютное качество которого не опубликовано для Thailand document 1 и +40 процентных пунктов для Vietnam document 1. После этого команда уменьшила архитектуру примерно до 1B параметров, сохранив зрительный кодировщик Qwen2-VL 2B и взяв языковой декодер Qwen2.5 0.5B. Итоговая модель, по словам авторов, остаётся в пределах 3 процентных пунктов от 2B на большинстве типов документов, а нормированная задержка меняется с 75/96/100 до 39/42/44 для P50/P90/P99. Эти значения не являются миллисекундами.
- 01
1. Получить изображение
На вход модели поступает фотография документа и запрос на распознавание текста или нужных полей.
- 02
2. Закодировать изображение
Зрительный кодировщик преобразует пиксели в числовое представление, сохраняя детали текста.
- 03
3. Передать изображение языковой части
Проектор переводит зрительное представление в формат, понятный языковому декодеру.
- 04
4. Сформировать ответ
Декодер использует изображение и текст запроса, чтобы распознать содержание и выделить нужные поля.
- 05
5. Вернуть структуру
Результат представляется структурированными полями, например JSON; статья не раскрывает всю дальнейшую проверку в eKYC.
При этом публикация не доказывает полный перевод рабочего трафика Grab на новую модель и не содержит A/B-теста. Не раскрыты абсолютный качество исходного варианта в таблице 1, физические единицы задержки и многие детали развёртывания и обслуживания запросов. Chain-of-Thought OCR/KIE и расширение на новые рынки авторы относят к дальнейшей работе.
Introduction; Documint; Phase 2; Phase 3; Key takeaways; What’s next