Разбор готов
ЕвроХим: как синтетические данные и zero-shot помогают быстро проверять CV-гипотезы
На производстве нужные изображения часто оказываются именно теми, которые сложнее всего собрать. Для детектора пожара понадобились бы кадры реальных или специально организованных возгораний, а для контроля средств индивидуальной защиты — достаточно примеров сотрудников, которые нарушают правила. В докладе Дмитрий Колесников показывает два способа работать с таким дефицитом данных. Сначала команда создаёт недостающие примеры с помощью Fooocus и Stable Diffusion, а затем разбирает zero-shot-модели, которые позволяют проверить часть гипотез вообще без специализированного обучающего датасета. Это история не о доказанном снижении аварий, а о том, как быстрее подготовить данные, собрать PoC и понять, жизнеспособна ли идея.
Материал полезен инженерам и аналитикам, которые запускают Computer Vision в условиях редких событий, дорогой разметки и недостатка реальных примеров. Особенно полезен сам переход от генерации синтетики к zero-shot: доклад показывает, какие инструменты автор использует для классификации, детекции и сегментации и как соединяет их в простые PoC.
Слайды · на русском
Использование Zero-shot и искусственных данных в проектах по компьютерному зрениюОткрыть оригинальные слайдыДмитрий Колесников, Industrial++ 2024 · Опубликовано: 22 октября 2024 г.
Почему в промышленном CV сначала нужен PoC
Автор начинает не с выбора модели, а с ограничения данных. На производстве изображений нужного типа зачастую мало, а заказчик не обязан заранее доверять обещаниям команды. Поэтому PoC здесь нужен как небольшая техническая проверка: показать, что идею в принципе можно реализовать, прежде чем строить полноценную систему.
В докладе рассматриваются две характерные задачи: обнаружение очагов возгорания и распознавание нарушений ношения СИЗ. В первом случае возникает вопрос, откуда взять достаточно кадров пожара и придётся ли ради них устраивать контролируемые поджоги. Во втором — где найти много нарушителей, как организовать съёмки, не вмешиваясь в работу предприятия, и как не создавать опасные ситуации специально ради датасета.
Слайды 3–4Fooocus как способ дорисовать недостающие ситуации
Первый ответ на нехватку данных — синтетические изображения. В докладе используется Fooocus, интерфейс поверх Stable Diffusion, который команда может запускать локально на своём сервере. Идея проста: вместо организации новой съёмки взять существующий кадр и сгенерировать тот вариант сцены, которого в исходных данных нет.
На примере касок проблема особенно наглядна. Заказчик сообщил, что на предприятии каски бывают разных цветов, но в предоставленных данных были только жёлтые. На слайде 6 показано, как из таких кадров получают варианты с белыми и красными касками. Это расширяет визуальное разнообразие датасета, но сам слайд не сообщает, сколько изображений было создано и насколько каждый синтетический пример похож на реальные условия съёмки.
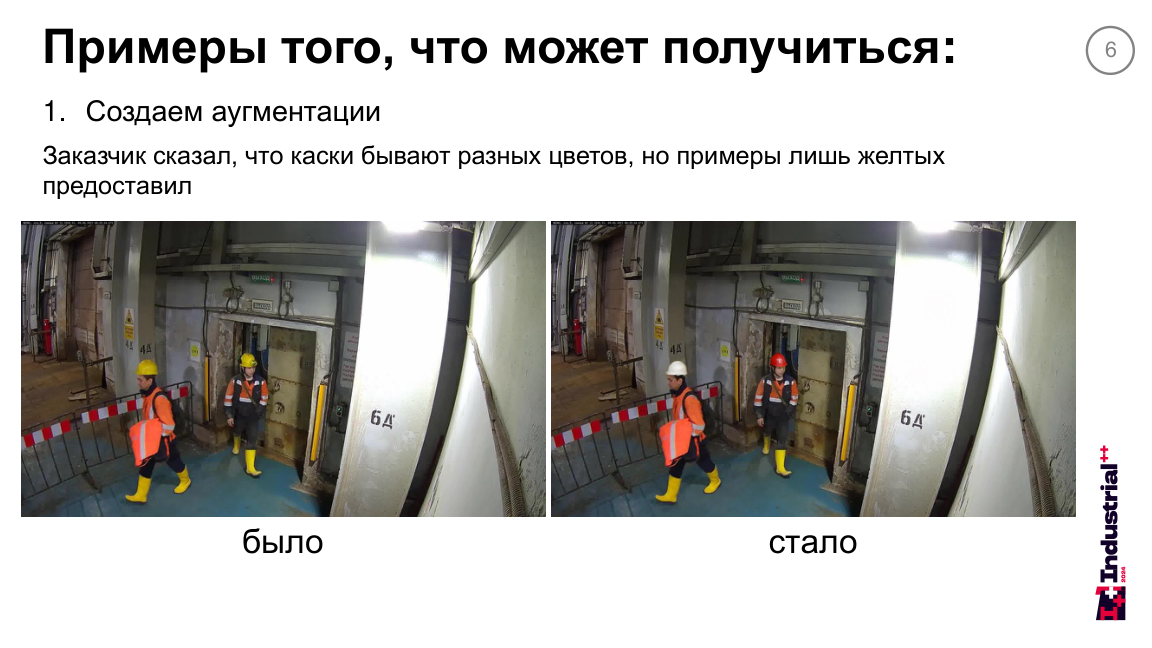
Когда в исходных данных были только жёлтые каски, команда сгенерировала другие цвета на существующих производственных кадрах. Слайд 6 доклада Дмитрия Колесникова.
Источник: Исходные слайды · 6Синтетический датасет пожаров
Дальше тот же подход применяется к более редкому событию — пожару на предприятии. Автор показывает исходный кадр, затем примеры созданных сцен. Смысл этого блока в том, чтобы получить дополнительные изображения возгораний без необходимости специально воспроизводить опасное событие в реальном цехе.
Доклад не раскрывает точные промпты, число сгенерированных кадров и долю синтетики в итоговой выборке. Поэтому эти примеры показывают способ получить редкие сцены, но сами по себе ещё не говорят, насколько устойчивым окажется детектор на реальном видеопотоке.
Слайды 7–13Генерация нарушений ношения СИЗ
Вторая группа синтетических данных относится к нарушениям ношения средств индивидуальной защиты. Здесь задача уже не в цвете объекта, а в создании примеров поведения или состояния, которое редко встречается в предоставленных кадрах и которое неудобно специально воспроизводить на производстве.
Автор отдельно показывает случаи, когда в кадре видны лица, и несколько попыток улучшить качество генерации. Это существенный практический момент: синтетическое изображение нужно проверить глазами, прежде чем добавлять в данные. Подробных измерений качества для каждого этапа доработки в докладе нет.
Слайды 14–19Что автор советует при работе с Fooocus
После примеров автор сводит опыт генерации к нескольким практическим приёмам. Для изменения содержимого выбранной области он предлагает режим Inpaint Modify Content. Промпты советует делать подробными и дополнять негативными указаниями — описанием того, чего на изображении быть не должно.
Автор также рекомендует запускать несколько генераций, использовать realistic-режим, подключать ControlNet и повторно прогонять результат через Upscale or Variation, если изображение получилось искажённым. Это советы из опыта команды, а не результаты отдельного эксперимента: на слайде нет абляции, которая показывала бы количественный вклад каждого приёма.
Слайды 20Что получили от синтетических данных
Слайд 21 важно читать как несколько разных результатов, а не как одну общую метрику. Количество данных, качество детектора и полнота обнаружения нарушений измеряют разные вещи.
Таблицу можно прокрутить по горизонтали.
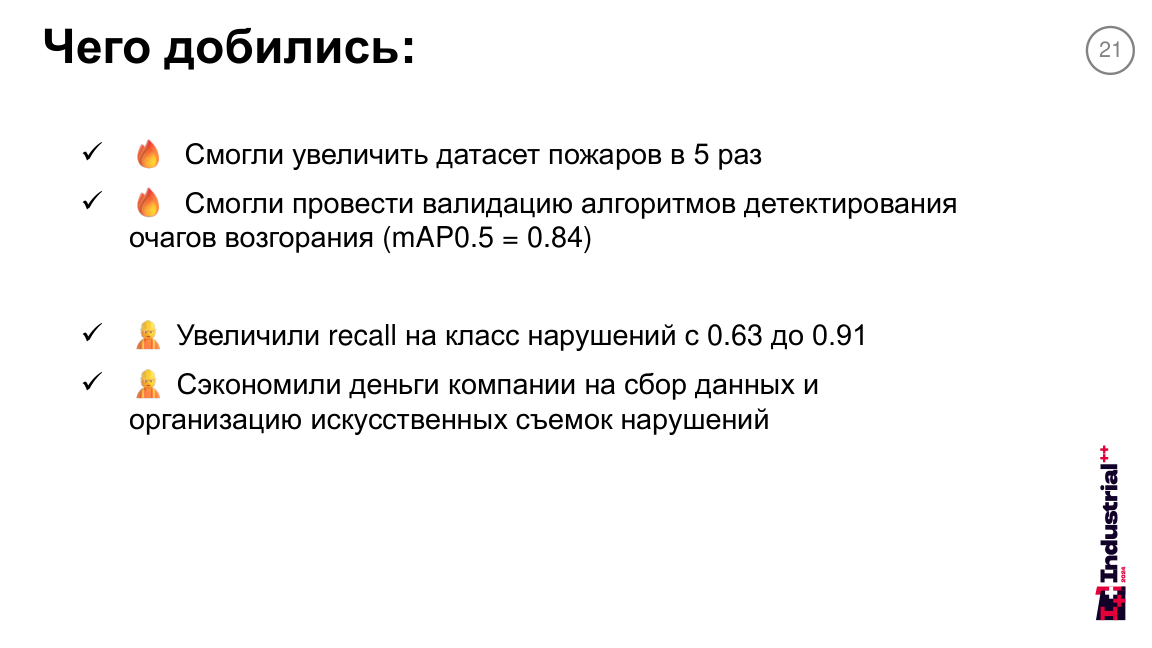
Результаты работы с синтетическими данными. На слайде приведены разные показатели для двух задач; условия теста подробно не раскрыты. Слайд 21.
Источник: Исходные слайды · 21Когда обучающих примеров нет вообще
После синтетики доклад ставит более радикальный вопрос: что делать, если данных вообще нет, решение нужно быстро, а сама гипотеза ещё не доказана? Здесь появляется zero-shot — использование уже предобученной модели для новой задачи без отдельного обучения на размеченных примерах именно этой задачи.
На простом примере это выглядит так: вместо сбора сотен фотографий для каждого нового класса инженер задаёт модели текстовое описание того, что хочет найти или различить. Предобученная модель уже умеет связывать визуальное содержимое с такими запросами и используется как отправная точка для PoC. Доклад не утверждает, что этот способ автоматически заменяет специализированное обучение в готовой промышленной системе.
Слайды 22–24Какие zero-shot-модели автор связывает с разными CV-задачами
Таблицу можно прокрутить по горизонтали.
Для CLIP автор приводит промышленные примеры вроде пустого или непустого конвейера, определения цвета вагонов и распознавания предметов. Для детекции — поиск движущихся объектов, автомобильных номеров и подсчёт специфических объектов. Это примеры применимости подходов, а не опубликованные на этих страницах численные результаты.
Слайды 25–30SAM: сегментация по подсказке
SAM в докладе показан как модель, которой нужно подсказать, какую область сегментировать. Такой вход называется промптом, но это уже не обязательно текст: на слайдах показаны point prompt и box prompt. В первом случае пользователь или предыдущий алгоритм указывает точку внутри объекта, во втором — прямоугольник вокруг него.
Сегментация дальше используется как строительный блок более сложных задач: определения габаритов объектов, гранулометрии и автоматической разметки. На этих страницах нет численного сравнения SAM, FastSAM или CLIPSeg, поэтому перечисление моделей нельзя превращать в рейтинг качества.
Слайды 31–34Двухстадийная схема: детектор находит объект, SAM уточняет маску
В итоге из этих инструментов складывается двухстадийная схема. Сначала zero-shot-детектор получает изображение и находит интересующие объекты. Его результат — прямоугольники, или bounding boxes. Затем эти боксы передаются в SAM как box prompt, и SAM строит маску найденного объекта.
- 01
Изображение
На вход поступает кадр, в котором требуется найти объекты заданного типа.
- 02
Zero-shot detector
Предобученный детектор ищет объекты по заданным классам или текстовым описаниям.
- 03
Boxes
Для найденных объектов детектор возвращает ограничивающие прямоугольники.
- 04
SAM
Каждый прямоугольник используется как входной промпт для сегментации, чтобы получить маску отдельного объекта.
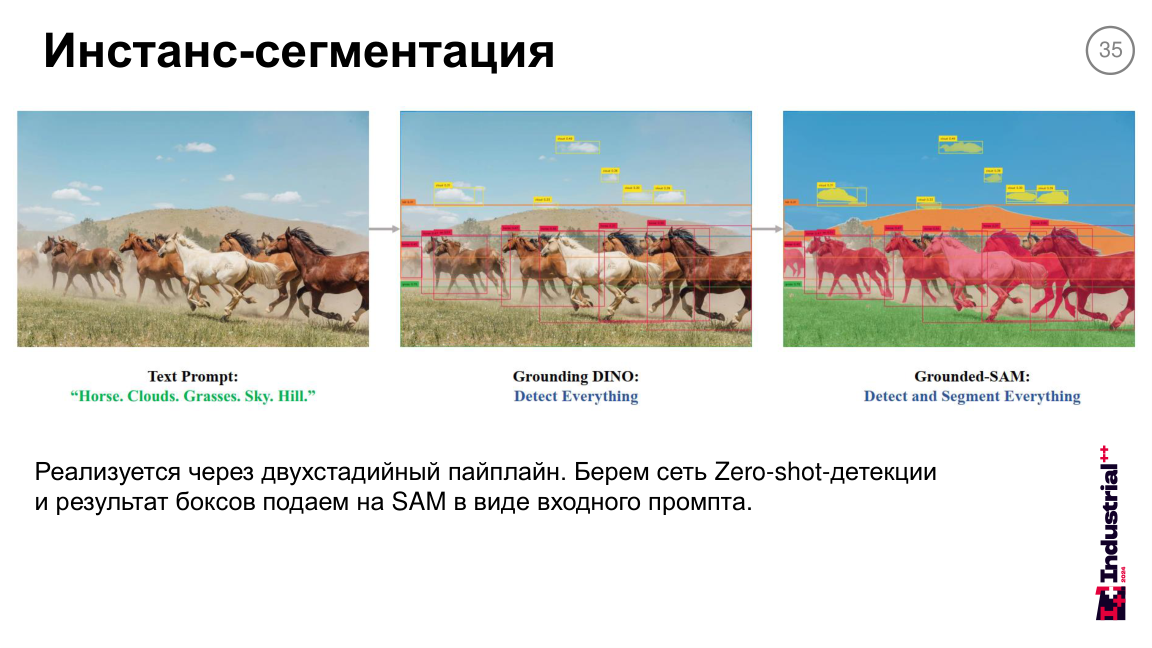
Двухэтапная инстанс-сегментация: рамки найденных объектов становятся подсказкой для SAM. Слайд 35.
Источник: Исходные слайды · 35Какие PoC автор показывает в промышленности
Автор также сообщает о проекте гранулометрии в реальном времени с применением дистиллированной модели SAM. Точность, скорость в кадрах в секунду и детали дистилляции не приведены, поэтому здесь можно зафиксировать сам кейс и используемое семейство моделей, но не оценить его производительность.
Далее приведены ещё два срока разработки: PoC распознавания автомобильных номеров был реализован за 2 недели, PoC аналитики СИЗ — за месяц. Это именно сроки PoC. Слайд не говорит, что за это время решения прошли промышленное внедрение, длительную эксплуатацию или подтвердили влияние на безопасность производства.
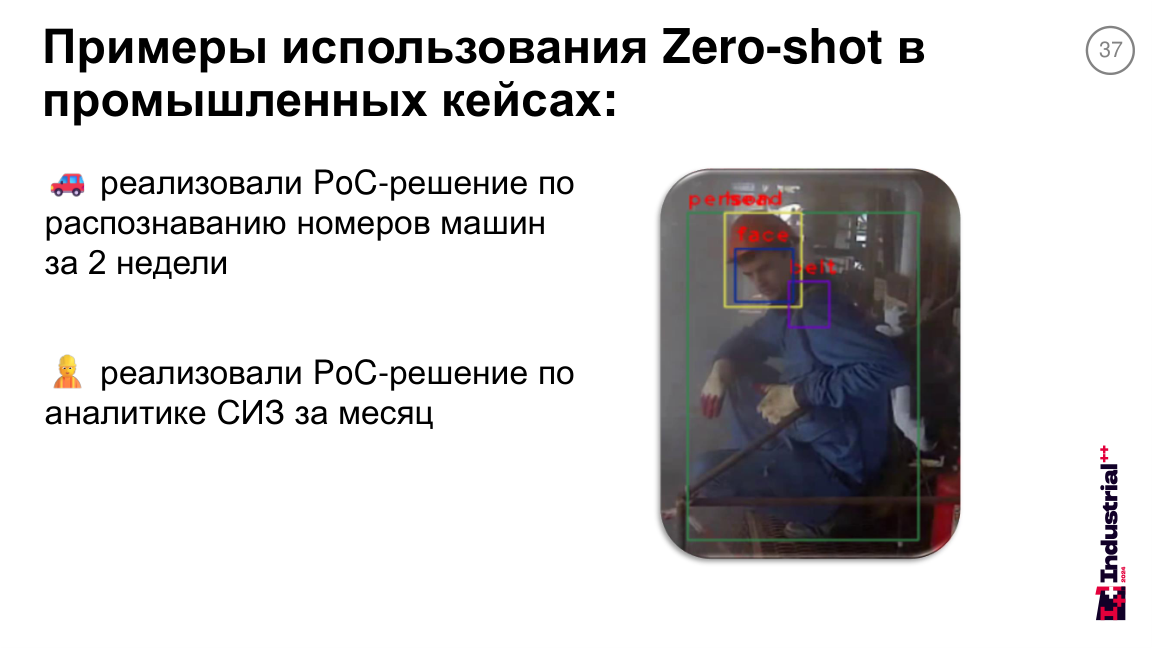
Сроки проверки двух гипотез. Слайд говорит о PoC, а не о длительности внедрения в производство. Слайд 37.
Источник: Исходные слайды · 37Zero-shot как инструмент автоматической разметки
Ещё одно применение — подготовка уже обычных размеченных датасетов. Автор показывает open-source-проект AutoCVAT, который автоматизирует разметку в CVAT. Логика естественно продолжает двухстадийную схему: модель сама предлагает локализацию или маску, а результат можно использовать в процессе подготовки датасета вместо полностью ручной разметки.
На слайде сказано, что такое решение удешевило процесс разметки, но численной оценки экономии, скорости или качества автоматически полученных аннотаций нет. Поэтому эффект здесь следует оставлять качественным заявлением автора.
Слайды 38Какие выводы делает автор
Первый вывод доклада: для некоторых редких или неудобных для съёмки ситуаций генерация синтетики может оказаться практически единственным доступным способом быстро получить нужные примеры. В показанных кейсах она используется для пожаров, нарушений СИЗ и вариаций внешнего вида объектов.
Второй вывод касается zero-shot. Автор формулирует, что такой подход «на порядок» снижает затраты на этапе PoC и прототипирования и легко переносится между задачами. Однако на итоговом слайде нет расчёта стоимости, поэтому эту фразу нельзя превращать в измеренное десятикратное снижение расходов. Надёжнее читать её как итоговую оценку автора по опыту представленных проектов.
Слайды 39Итог: два способа быстро получить проверяемый CV-прототип
Доклад начинается с практической проблемы: на производстве именно самые важные события могут быть редкими и неудобными для сбора данных. Пожары нельзя регулярно устраивать ради датасета, а нарушения СИЗ не хочется специально воспроизводить во время работы предприятия. Поэтому первая часть решения — не новая архитектура детектора, а создание недостающих примеров. Через Fooocus команда меняет существующие изображения, например превращает жёлтые каски в белые и красные, и генерирует дополнительные сцены пожаров и нарушений.
- 01
Определить, каких примеров не хватает
Команда фиксирует редкие классы и ситуации, которые трудно или дорого получить обычной съёмкой.
- 02
Дополнить данные синтетикой
Исходные кадры изменяются через Fooocus; качество генераций улучшают промптами, Inpaint, ControlNet и повторной обработкой.
- 03
Проверить модель на подготовленных данных
Для показанных задач автор сообщает увеличение пожарного датасета в 5 раз, mAP0.5 = 0.84 и отдельный рост recall нарушений с 0.63 до 0.91.
- 04
Если данных нет, перейти к zero-shot
CLIP используется для классификации, Grounding DINO или YOLO-world — для детекции, SAM-подобные модели — для сегментации.
- 05
Собрать составной PoC
В двухстадийной схеме zero-shot-детектор выдаёт боксы, а SAM превращает их в маски; тот же подход может помогать автоматической разметке.
Вторая половина доклада показывает, зачем это полезно именно на ранней стадии проекта. Автор приводит realtime-гранулометрию с дистиллированной SAM, PoC автомобильных номеров за 2 недели, аналитику СИЗ за месяц и AutoCVAT для автоматизации разметки. Но граница результата принципиальна: это примеры подготовки данных и прототипирования. Доклад не показывает измеренного снижения аварий, числа нарушений или пожаров на действующем производстве и не доказывает полноценное внедрение всех описанных PoC. Также для ряда метрик не раскрыты размер контрольной выборки, пороги и другие детали оценки. Поэтому главный результат источника — не универсальная точность конкретной модели, а практический маршрут от дефицита данных к проверяемому CV-прототипу.
Слайды 3–39