Разбор готов
Cloud.ru: как поиск по документации превратили в работающую RAG-систему
У Cloud.ru три облачные платформы и десятки сервисов. Когда пользователь ищет ответ в их документации, а сотрудник поддержки разбирается с тем же вопросом, нужная информация может оказаться в разных разделах. Команда построила систему, которая сначала находит подходящие фрагменты, а затем передаёт их языковой модели для ответа. В докладе подробно показано, что пришлось настроить между этими двумя шагами: поиск по словам и по смыслу, повторное ранжирование, работу с русским текстом, подготовку документов и регулярное обновление базы. Разберём также сравнение пяти конфигураций поиска и путь одного вопроса через работающую систему.
Материал полезен тем, кто строит поиск и ответы по технической документации. Он помогает понять, почему качество зависит не только от языковой модели, но и от выбора кандидатов, их порядка и актуальности базы. Термины объясняются по ходу.
Видео · на русском
Михаил Дремин, Петр Королев | Как мы завели RAG в продакшенеМихаил Дремин, Пётр Королёв · Опубликовано: 11 октября 2024 г.
Исходный доклад · Открыть оригинал
Почему сведения подставляют при ответе, а не переучивают генератор
В базовом варианте система сначала ищет в документации фрагменты, соответствующие пользовательскому вопросу. Для этого тексты представлены векторами — наборами чисел, по близости которых можно отбирать кандидатов. Найденные фрагменты вместе с исходным вопросом поступают в языковую модель. Она составляет ответ на основе предоставленного материала. Поиск перед генерацией и называется RAG.
Альтернатива — дообучить генератор на всей документации и затем рассчитывать на знания, сохранённые в его параметрах. Авторы отказываются от такого способа поддержания актуальности: обучение требует времени и ресурсов, а источник меняется. В RAG новые сведения можно передавать непосредственно при формировании ответа, обновляя поисковую базу. Это не означает отказа от обучения вообще: дальше команда обучает модели поиска и ранжирования, а не описывает переобучение генератора после каждого изменения документации.
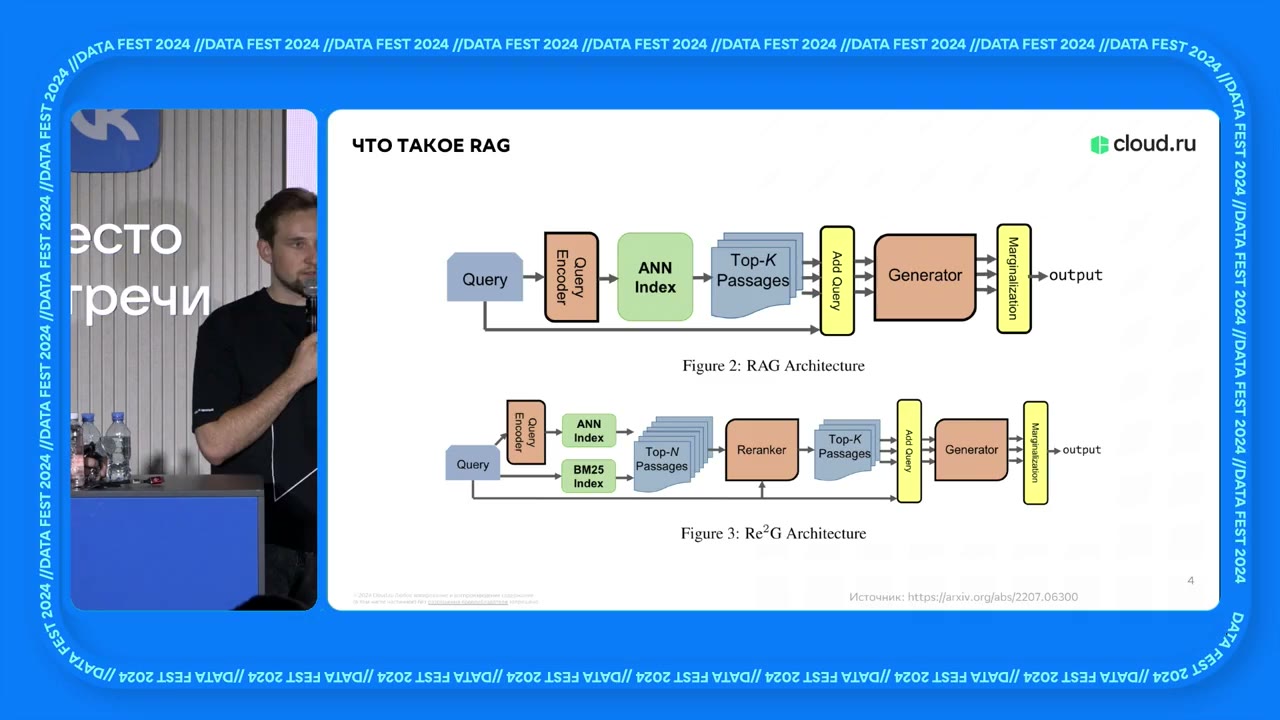
Доклад сначала сравнивает базовый RAG и схему с двумя поисками и отдельным ранкером. Кадр, 01:30.
Источник: Доклад · 01:30Задача Cloud.ru и гибридный поиск
Собственная задача Cloud.ru возникает из масштаба документации: три облачные платформы и десятки сервисов образуют большой набор материалов. Команда хочет уменьшить время поиска полезных сведений и трудозатраты пользователей и поддержки, а также повысить лояльность. Здесь это цели проекта, а не результаты измеренного продуктового эксперимента.
Расширенная схема добавляет к поиску по векторам полнотекстовую выдачу BM25, основанную на словах запроса и документа. Так формируются два источника кандидатов: поиск по текстовым совпадениям и поиск по векторной близости. Затем общая модель повторно упорядочивает найденные фрагменты. Этот этап называется переранжированием.
У нейросетевых компонентов разные задачи. Bi-encoder отдельно превращает запрос и фрагмент в векторы и помогает отбирать кандидатов. Cross-encoder рассматривает запрос вместе с конкретным фрагментом и оценивает их соответствие. Первый нужен для поиска, второй — для выбора порядка уже найденных материалов. Базовая и расширенная схемы в начале доклада объясняют устройство подхода; они не устанавливают подробную историю прежних версий поиска Cloud.ru.
Доклад · 00:02:00Экспертная оценка: запрос, фрагмент и релевантность
Для обучения двух поисковых компонентов нужны примеры того, какие тексты подходят к каким запросам. Авторы рассматривают синтетические данные и разметку специалистами. По их опыту, экспертные данные дают лучшие результаты, но такого материала мало. Поэтому качество разметки и возможность получить достаточно примеров становятся отдельной частью решения, а не подготовительной формальностью.
Перед разметкой команда готовит инструкцию и методологию, затем передаёт материал экспертам. Одна запись содержит запрос, текст и оценку релевантности по шкале 0–3. Ноль означает, что текст не соответствует запросу, а три — максимальное соответствие. Точные критерии промежуточных оценок в доступном объяснении не раскрыты.
Это оценка пары, а не документа самого по себе: один и тот же фрагмент может подходить к одному вопросу и не подходить к другому. Такая постановка соответствует последующей работе cross-encoder, который получает сразу обе текстовые последовательности. Число примеров и распределение экспертных оценок авторы здесь не сообщают.
Доклад · 00:03:00Русская токенизация как ограничение модели
При выборе модели команда смотрит не только на результаты бенчмарков, но и на то, сколько русского текста модель действительно получает на входе. Токенизация разбивает текст на единицы, с которыми работает нейросеть. Если русские слова дробятся слишком сильно, ограниченное окно заполняется быстрее, и существенная часть документа может не попасть в обработку.
На гистограммах сопоставляются высоко оценённая в рейтинге модель и другая модель, обученная в том числе на русскоязычных данных. В показанном сравнении первая вмещает меньше исходного русского текста в ограниченное окно, вторая — больше. Это сравнение вместимости текста при токенизации, а не скорости работы и не конечного качества ответов.
Для ранжирования это принципиально: высокая оценка модели на внешнем наборе не компенсирует потерю нужного фрагмента из-за обрезания входа. Поэтому выбор токенизатора связан с будущей нарезкой документации. Недостаточно подобрать сильный энкодер; нужно ещё обеспечить ему содержательный вход в пределах допустимой длины.
Доклад · 00:05:00Обучение cross-encoder: от общих данных к документации
Первым обучают cross-encoder: позднее он будет не только ранжировать выдачу, но и размечать примеры для bi-encoder. Модель одновременно получает запрос и фрагмент документации, разделённые специальным токеном. Поверх энкодера расположен выходной модуль, который выдаёт оценку соответствия от 0 до 1. Это выход модели, а не исходная экспертная шкала 0–3; способ преобразования экспертных меток в целевые значения не описан.
Сначала используют датасет, полученный машинным переводом MS MARCO. По оценке команды, он подходит для предварительного обучения, но не для окончательной настройки. Затем модель дообучают с учителем на размеченных данных собственной задачи — этот этап авторы называют SFT.
При дообучении также применяют аугментации — изменённые варианты обучающих текстов. В речи явно упомянуто добавление ошибок; полный перечень преобразований не сохранился. Получившийся ранкер связывает две части решения: экспертные суждения о релевантности влияют на финальную выдачу и становятся основой автоматической разметки при адаптации поисковой модели.
Доклад · 00:06:00GPL: обучение bi-encoder на собственном корпусе
Bi-encoder обрабатывает запрос и документ по отдельности. В отличие от cross-encoder, он не сопоставляет их тексты непосредственно при построении каждого вектора. Авторы связывают с этим чувствительность готовой модели к предметной области: без адаптации она может плохо работать на специализированной документации. Для адаптации используют GPL — обучение на сгенерированных запросах с последующей автоматической оценкой примеров моделью-учителем.
- 01
Сгенерировать вопросы
Берут фрагмент документации и с помощью языковой модели создают по нему от пяти до семи пользовательских запросов. Исходный фрагмент становится положительным примером для этих запросов.
- 02
Найти сложные отрицательные примеры
Запросы отправляют в существующую поисковую систему, например OpenSearch или Elasticsearch. Найденные похожие фрагменты используют как hard negatives: кандидатов, которых модели нужно научиться отличать от исходного положительного текста.
- 03
Получить оценки учителя
Cross-encoder оценивает пары запроса с положительным и отрицательным фрагментами. К тройке текстов добавляются оценки соответствия; их используют как псевдоразметку.
- 04
Обучить поисковую модель
Bi-encoder строит векторы запроса и обоих фрагментов. Обучение согласует разность близостей положительного и отрицательного примеров к запросу с различием, заданным оценками учителя.
Важна не только похожесть положительного примера, но и величина его преимущества над другим кандидатом. Поиск может вернуть действительно полезный текст, который формально попал в отрицательные примеры. Если учитель оценивает оба фрагмента высоко, разность предпочтений должна быть небольшой. Такой обучающий сигнал мягче, чем безусловное требование считать каждый найденный альтернативный фрагмент плохим.
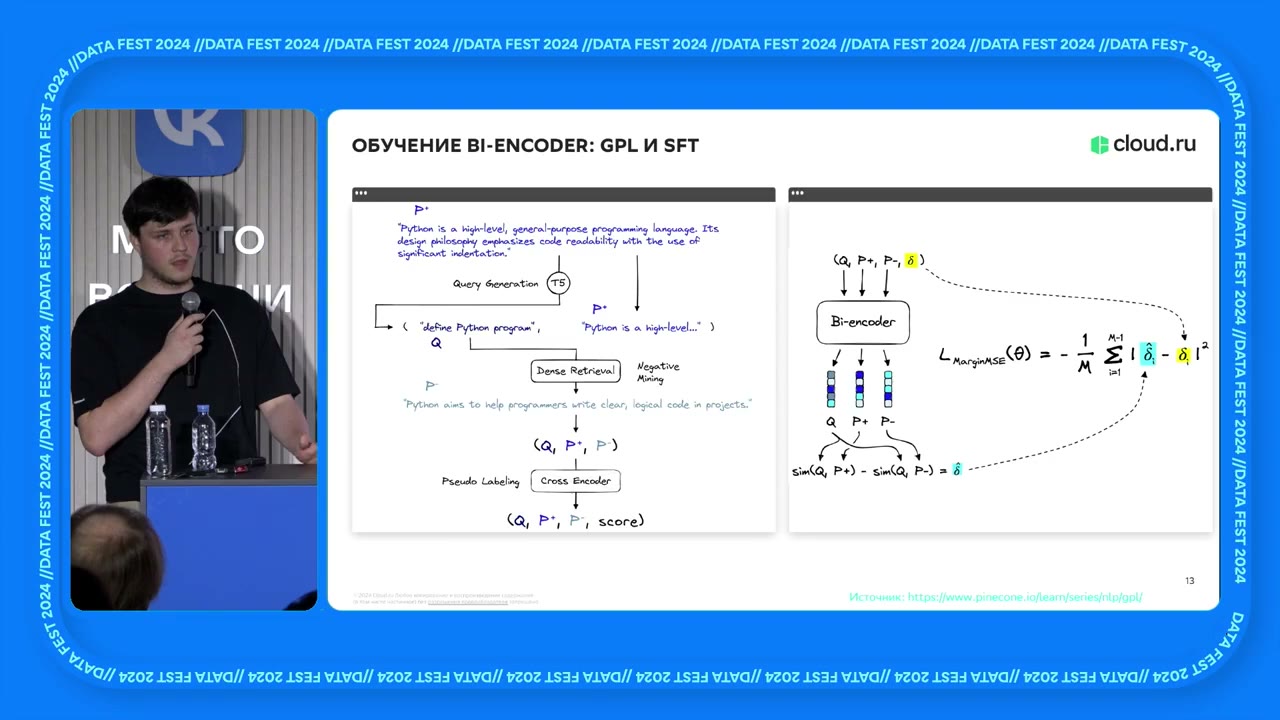
Синтетические вопросы и псевдоразметка помогают обучить модель первого этапа поиска. Кадр, 08:30.
Источник: Доклад · 08:30Терминология в словаре OpenSearch
Доменная адаптация не снимает всех проблем с терминологией. Пользователи могут называть один объект иначе, чем технические писатели, а для таких запросов команде особенно важно не потерять подходящий документ. Поэтому нейросетевой поиск дополняют словарём синонимов для полнотекстового поиска OpenSearch. Словарь берут у технических писателей.
Пример из доклада — виртуальная машина. В словаре учитывают пользовательские варианты «виртуалка», VM, «тачка», «сервер». Это соответствия для поиска в конкретной документации, а не утверждение, что все перечисленные термины равнозначны в любом техническом контексте.
Словарь связывает варианты терминов, а фильтры помогают сопоставлять формы слов и устойчивые сочетания. Эти настройки усиливают полнотекстовый источник кандидатов и не заменяют дальнейшее переранжирование объединённой выдачи.
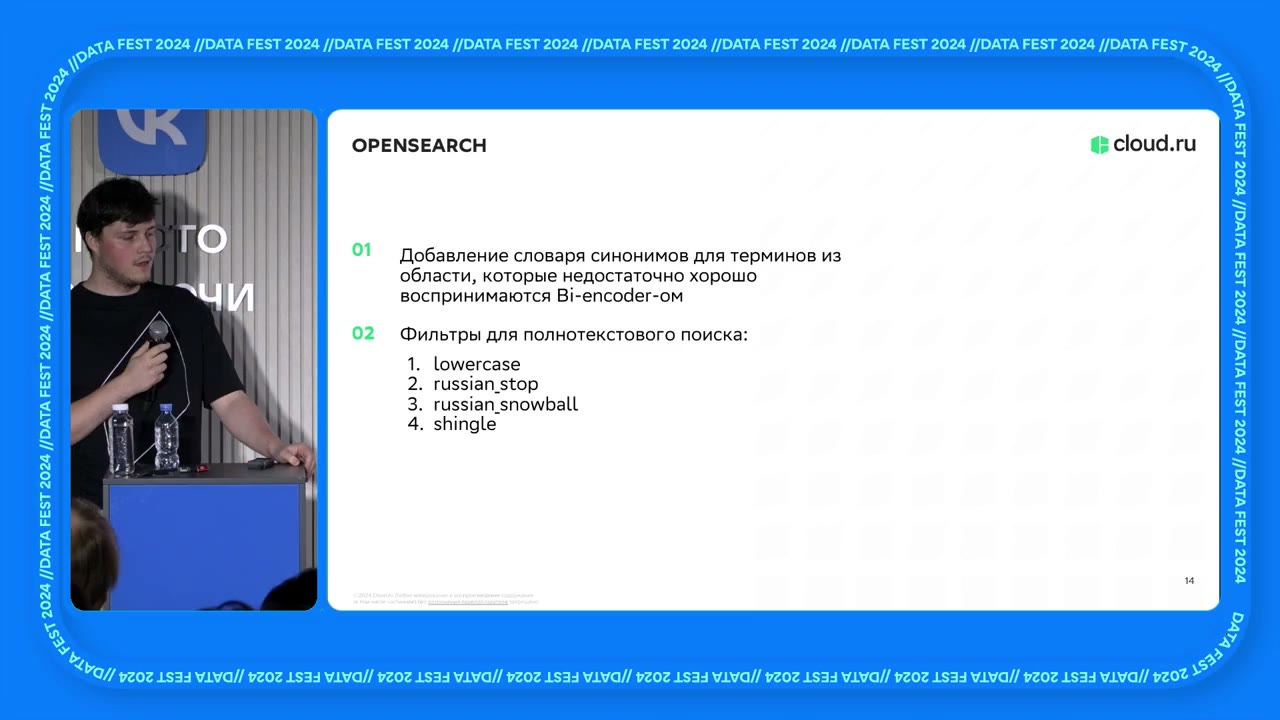
Полнотекстовый поиск дополняют синонимами и обработкой русских терминов в OpenSearch. Кадр, 12:30.
Источник: Доклад · 12:30Что показали сравнения и почему выбрали три фрагмента
После переранжирования генератору передают ровно три текста. Команда пробовала больше фрагментов, но дополнительный материал не всегда помогал: отрывки могли происходить из разных документов и быть плохо связаны между собой, из-за чего модель теряла нужный ответ. Три фрагмента показали приемлемый результат в этой системе. Это выбор для описанной задачи, а не общий оптимум для любого RAG.
Таблицу можно прокрутить по горизонтали.
Первый гибридный вариант на слайде оказался хуже отдельного BM25: nDCG@3 упал с 0.535876 до 0.492008. Авторы связывают это с тем, что mini-lm обрезал значительную часть русского текста. Добавление словаря и фильтров, адаптация bi-encoder через GPL и обучение cross-encoder на собственной разметке сопровождались ростом показателя. Между четвёртой и пятой строками меняется только вариант ранкера: 0.609899 → 0.668312. Устное объяснение авторов: подходящий текст уже находился среди кандидатов, но занимал недостаточно высокую позицию.
nDCG@3 измеряет качество верхней части поисковой выдачи на подготовленном наборе. Это не скорость ответа сервиса и не доля правильно отвеченных пользователю вопросов. В ответах из зала авторы уточняют, что синтетически подготовленные вопросы проверяли асессоры; размер набора, неопределённость и полная методика разделения данных не названы. Сравнение первой и последней строк не изолирует эффект одного компонента: между ними изменены и поиск, и ранкер.
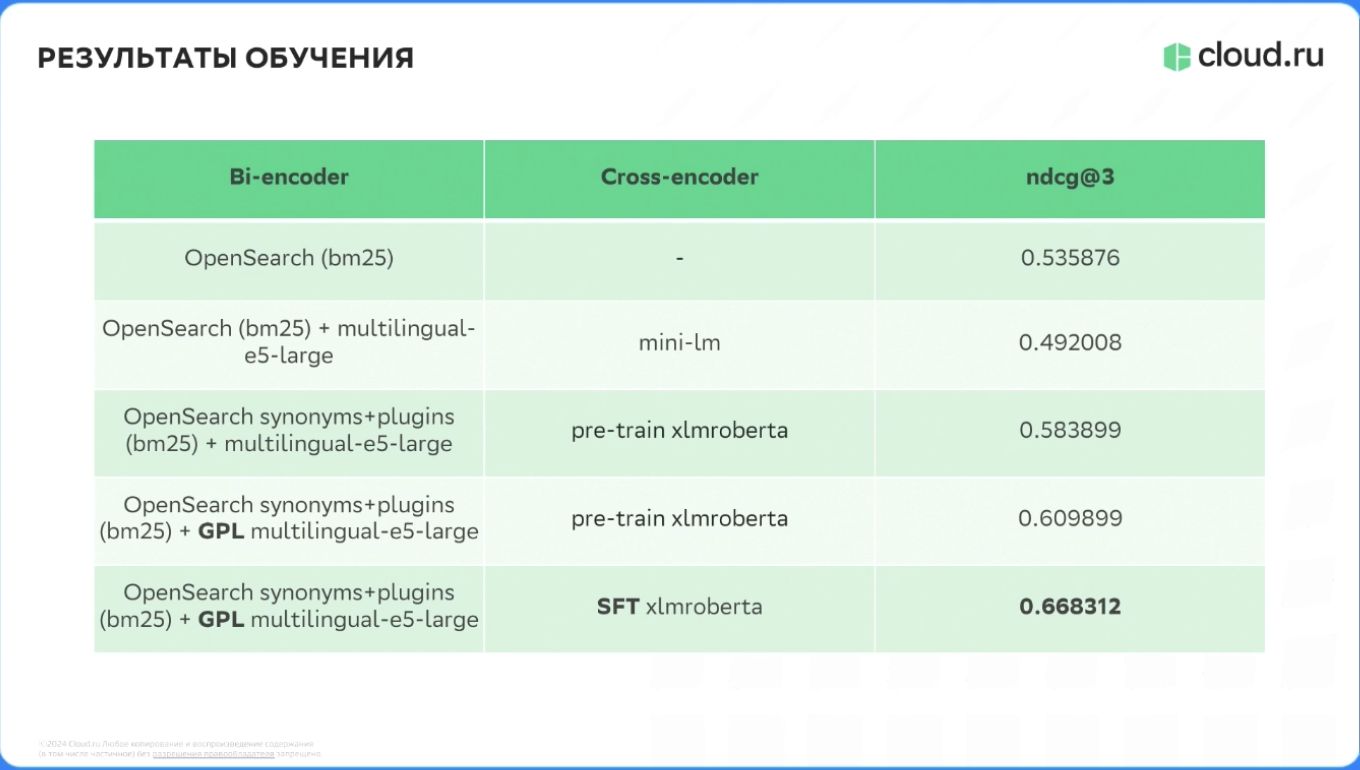
Исходная таблица офлайн-оценки: простое добавление векторного поиска с MiniLM ухудшило nDCG@3 относительно BM25; лучший показанный вариант — дообученные bi-encoder и cross-encoder. Кадр, 14:00.
Источник: Доклад · 14:00Подготовка документов: почему готового сплиттера недостаточно
После обучения моделей остаётся подготовить материал, по которому они будут искать. Эта часть относится к ETL — получению документов, их преобразованию и загрузке в поисковые хранилища. Центральная проблема здесь — границы фрагментов: слишком большой текст не помещается в модель, а механическое разрезание может разделить одну мысль на части.
Авторы приводят конкретную неудачу с готовой библиотекой: выбранный сплиттер, то есть компонент разбиения текста, должен был работать по регулярным выражениям, но вместо этого вставлял их в документ. По словам команды, через два месяца этот сплиттер вообще исчез из библиотеки. Опыт относится к использованной тогда реализации, а не доказывает непригодность всех инструментов такого класса.
Инженерный смысл эпизода — проверять сам результат подготовки корпуса. Наличие удобного интерфейса библиотеки не подтверждает, что текст разбит правильно или что поведение зависимости останется прежним. Для задачи Cloud.ru особенно важно сохранить логические части документа и одновременно уложиться в ограничения моделей.
Доклад · 00:14:00Иерархическая нарезка HTML
Команда использует структуру HTML-документов как подсказку о смысловых границах. Заголовки отделяют части текста, поэтому разбиение начинается с них, а не с фиксированного числа символов. Это позволяет опираться на структуру, которую при написании документации уже создали люди.
- 01
Делить по заголовкам
Документ рекурсивно разбивают по уровням H1–H6, переходя к более мелким структурным частям, если текст не помещается в окно модели.
- 02
Переходить к параграфам
Если после разбиения по H6 часть всё ещё слишком велика, её делят по параграфам.
- 03
Проверять размер в токенах
Длину оценивают по модели, у которой в допустимое окно помещается меньше исходного текста. Подсчёт слов или символов не заменяет проверку токенизации.
Последнее условие связывает подготовку корпуса с выбором обеих моделей. Фрагмент, который подходит одному токенизатору, может оказаться слишком длинным для другого. Авторы поэтому ориентируются на более ограничивающий вариант. Отдельная политика для параграфа, который остаётся слишком длинным после такого разбиения, в докладе не раскрыта.
Доклад · 00:16:00Ежедневное обновление документации
Подготовку документов запускает оркестратор — инструмент, который организует выполнение связанных задач. Авторы сравнивают его с Airflow и отмечают удобство для Python-разработчиков. Рассматривались два режима актуализации: по расписанию и по событию через webhook, то есть уведомление, запускающее обработку.
Сначала команда хотела обновляться по событиям, но нужная функциональность в выбранном продукте, по её словам, была доступна только в облачном варианте. В итоге задачи запускают примерно раз в день, около пяти утра. Время выбрано, чтобы меньше вмешиваться в работу пользователей; это мотив расписания, а не измеренный показатель отсутствия влияния.
Источником служит GitLab pipeline с отрендеренными документами, подготовленными техническими писателями. Процесс получает эти документы, нарезает их по выбранной стратегии и готовит к загрузке в поисковые хранилища. Для векторного поиска заранее рассчитываются представления фрагментов. Это обновление корпуса и индексов, а не описанная частота переобучения моделей.
Доклад · 00:17:00Поисковые хранилища и развёртывание в Kubernetes
Подготовленные материалы поступают в два хранилища. OpenSearch обеспечивает полнотекстовую выдачу. Milvus хранит векторные представления и используется для семантического поиска; перед загрузкой фрагментов в эту часть системы bi-encoder рассчитывает их векторы. Оба источника затем участвуют в поиске по одному пользовательскому запросу.
Компоненты развёрнуты в Kubernetes. Для OpenSearch команда использует OpenSearch Operator и связывает этот выбор с более удобным администрированием в такой среде, в том числе управлением паролями. Это часть эксплуатационного решения: обученные модели должны работать вместе с поддерживаемыми поисковыми сервисами.
Milvus выбирают по соображениям зрелости, микросервисной архитектуры и возможности горизонтально масштабировать отдельные компоненты. Авторы также отмечают наличие SDK для разных языков. Устное утверждение о лучшей производительности относительно других векторных баз не сопровождается условиями сравнительного теста, поэтому оно не даёт основания считать Milvus универсально самым быстрым вариантом.
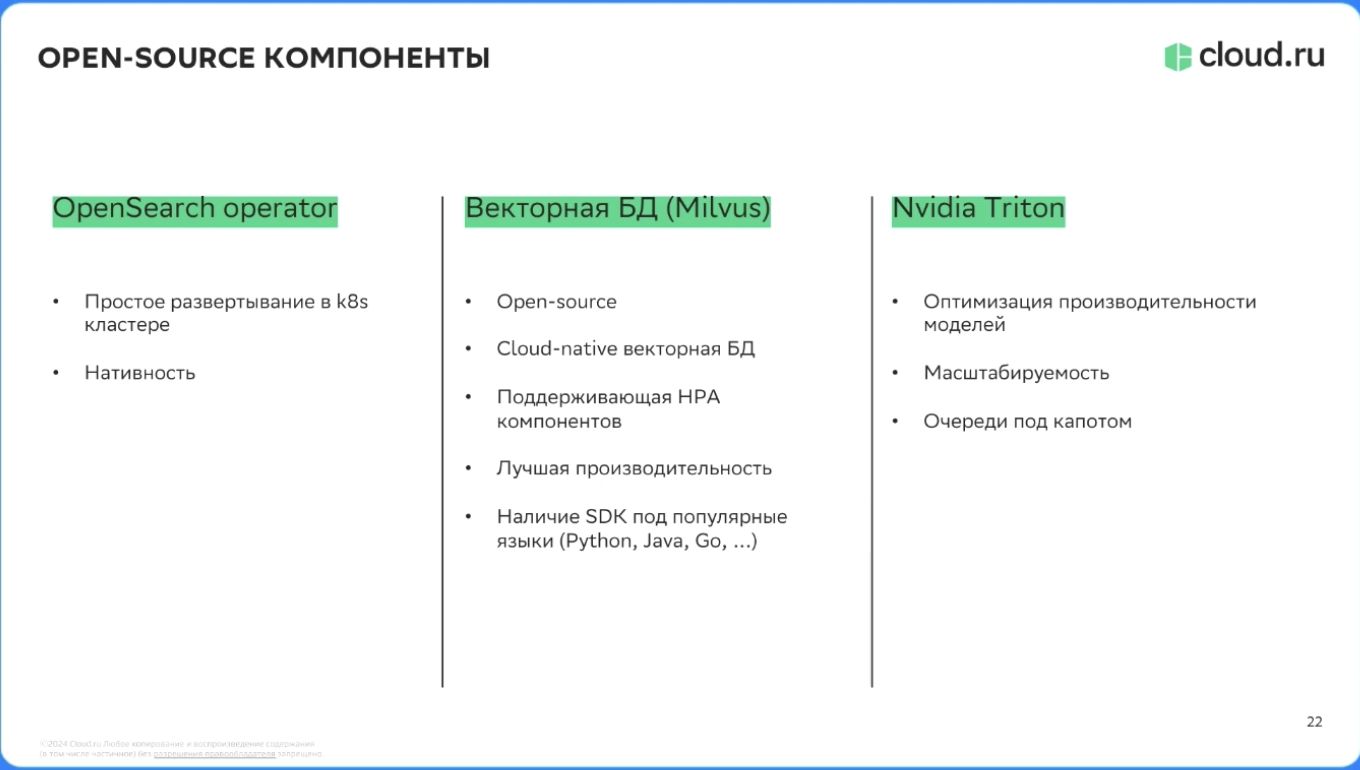
Компоненты обслуживания поиска и моделей в Kubernetes. Это схема выбранных инструментов, а не измерение их сравнительной производительности. Кадр, 19:30.
Источник: Доклад · 19:30Triton для обслуживания моделей
Для применения моделей в работающем сервисе команда использует NVIDIA Triton Inference Server. Его роль — обслуживать обращения к моделям, а не хранить документацию или заменять поисковую логику. Авторы связывают выбор с возможностью обрабатывать большое число запросов. Конкретное число запросов в секунду и конфигурация замера не приводятся.
Как дальнейшую возможность ускорения упоминают квантизацию и изменение числового представления моделей. Квантизация уменьшает точность представления чисел; в этом фрагменте она обсуждается как потенциальная оптимизация, а не как подтверждённая часть развёрнутой конфигурации.
Таким образом, выбор Triton описывает организацию выполнения моделей. Сам по себе он не доказывает конкретную задержку ответа или выигрыш производительности всей RAG-системы. Показатели качества выдачи из предыдущего сравнения также нельзя использовать вместо такого измерения.
Доклад · 00:20:00Путь запроса в работающем сервисе
Пользователь вводит вопрос в портале документации. Сервис поиска получает полнотекстовую выдачу из OpenSearch. Затем для вопроса рассчитывается вектор, с которым система обращается в Milvus и получает семантических кандидатов. Это работа с уже подготовленными индексами: извлекать документы из GitLab и запускать обучение для каждого вопроса не требуется.
Два списка объединяют и передают cross-encoder. Он оценивает соответствие найденных фрагментов запросу и задаёт итоговый порядок. Три лучших фрагмента вместе с вопросом поступают генератору, который составляет ответ.
В конце основной части авторы показывают результат в интерфейсе и сообщают, что система работает в production. Это подтверждает заявленный этап внедрения, но не заменяет измерение её эффекта для пользователей. В рассказе нет результатов A/B-теста или количественной оценки того, насколько изменились время поиска и нагрузка на поддержку.
Доклад · 00:20:00Вопрос из зала: почему именно RAG
Первый вопрос предлагает другой подход к работе с инструкциями. Авторы отвечают через устройство своего корпуса: сведения, необходимые для некоторых вопросов, распределены по документации, а не собраны в одном компактном месте. До перехода к RAG команда пробовала другие модели, но они показывали худшую работу именно в её случае.
Это важное уточнение мотивации: выбор объясняется свойствами документов и предыдущим опытом, а не тем, что генерация с поиском объявлена лучшим решением для любых инструкций. Из ответа нельзя восстановить точный состав конкурирующих систем, условия их настройки или численное преимущество RAG; локальный опыт авторов не является полным сравнением методов.
Доклад · 00:21:00Вопросы из зала: оценка качества и объединение выдач
Следующий вопрос отделяет показанную пользовательскую оценку от проверки на тестовом наборе. Авторы указывают на зелёную таблицу из основной части и уточняют происхождение данных: запросы генерировали, затем подготовленный синтетический материал проверяли асессоры. Специалисты не создавали всё с нуля, что, по словам команды, уменьшало трудозатраты на разметку.
Такую оценку нельзя описывать ни как полностью автоматическую проверку без человека, ни как набор исключительно самостоятельно написанных экспертами запросов. При этом размер тестового набора, его отделение от обучающих данных и полная процедура оценки в ответе не раскрыты. Наличие экспертной проверки не позволяет автоматически считать все эти условия установленными.
Последний вопрос касается объединения BM25 и векторного поиска. Ответ конкретен: сначала склеивают два списка кандидатов, затем общая модель переранжирует полученную выдачу и назначает финальные оценки. Здесь не описана взвешенная сумма исходных BM25-оценок и векторных близостей. Объединяются кандидаты, а их окончательное сравнение выполняет cross-encoder. Размеры исходных списков и правила удаления повторов не указаны.
Доклад · 00:22:00Итог: что подготовлено заранее и что происходит при запросе
Cloud.ru решала не абстрактную задачу общения с языковой моделью, а поиск по объёмной документации трёх платформ и десятков сервисов. Команда объединила полнотекстовый и семантический поиск, учла русскую токенизацию и подготовила экспертную разметку. Сначала был дообучен cross-encoder, затем его оценки использовали для адаптации bi-encoder через GPL. Словарь синонимов и фильтры дополнили нейросетевую часть там, где особенно важны предметные термины.
Обучение и обновление базы происходят отдельно от ответа пользователю. Ежедневный процесс получает документацию из GitLab, делит HTML на фрагменты, рассчитывает их векторы и загружает поисковые хранилища. Он не означает ежедневного переобучения моделей и не запускается заново для каждого вопроса.
- 01
Получить вопрос
Портал документации передаёт пользовательский запрос сервису поиска; модели и индексированные материалы уже подготовлены.
- 02
Найти кандидатов
OpenSearch возвращает полнотекстовую выдачу, а Milvus — фрагменты, найденные по вектору запроса, рассчитанному bi-encoder.
- 03
Переранжировать общий список
Списки объединяют. Cross-encoder оценивает пары запроса и найденных фрагментов и определяет их итоговый порядок.
- 04
Отобрать контекст
Три лучших фрагмента передают генератору вместе с исходным вопросом пользователя.
- 05
Сформировать ответ
Генератор составляет ответ по выбранным материалам, и результат показывают в интерфейсе портала.
Качество сравнивали по nDCG@3 на подготовленных данных; в ответах из зала уточняется, что синтетический материал проверяли асессоры. На авторском слайде BM25 набрал 0.535876, первый гибридный вариант с mini-lm — 0.492008, а полный вариант с дообученным ранкером — 0.668312. Это измерения поиска, не ответов генератора. Три фрагмента выбрали после попыток передавать больше текстов: дополнительный материал иногда мешал выделить ответ.
Система показана как работающая в production. Однако этот факт не доказывает ускорение поиска для пользователя, рост лояльности или снижение нагрузки на поддержку: измерений этих эффектов нет. Не раскрыты и все условия оценки, задержки обслуживания и согласования обновлений двух хранилищ. Результат доклада — конкретный путь к работающему поиску с генерацией, а не универсальный рецепт с гарантированными показателями.
Доклад · 00:00:00